
ถ้าเราเปลี่ยนข้อความให้เป็น token แบบที่ LLM ใช้ก่อน แล้วค่อยส่งให้โปรแกรมบีบอัดอย่าง gzip หรือ zstd ไฟล์จะเล็กลงจริงไหม? ทีมที่สร้าง parmar ไม่ตอบด้วยเดา แต่รันการทดลองถึง 452 การตั้งค่า บนชุดข้อความ PG-19 ตั้งแต่ 64 MB ไปจนถึง 4 GB
คำตอบสั้น ๆ คือ ช่วยได้จริงในหลายกรณี แต่เหตุผลไม่ใช่ “token วิเศษกว่า byte” เสมอไป และมี compressor หนึ่งตัวที่ยิ่งทำยิ่งแย่ลง
ไอเดียนี้ทำงานอย่างไร
โปรแกรมบีบอัดมองหาลวดลายซ้ำในหน้าต่างข้อมูลขนาดจำกัด ถ้าแปลงข้อความ UTF-8 เป็นรหัส token ก่อน สตรีมที่ส่งเข้าคอมเพรสเซอร์จะสั้นลงราว 45% ในภาษาอังกฤษ หน้าต่างเดิมจึงมองเห็นข้อความต้นฉบับได้ไกลขึ้น เหมือนย่อหนังสือก่อนใส่เข้ากล่อง—กล่องใบเดิมจุเนื้อหาได้มากกว่าเดิม
แต่ผลจะเห็นชัดก็ต่อเมื่อข้อมูลใหญ่กว่าหน้าต่างของ compressor แล้วเท่านั้น ไฟล์เล็กที่ทุกอย่างยังอยู่ในหน้าต่างเดียวกัน แทบไม่มีอะไรให้ได้เปรียบเพิ่ม
452 การตั้งค่าผ่านการบีบอัดและคลายกลับเพื่อตรวจ SHA-256 ครบทุกครั้ง
452 รอบ ไม่ได้แค่แข่งตัวเลข
ทีมทดสอบ tokenizer, วิธี pack token, backend, การส่งข้อมูลเป็น chunk และจำนวน thread บนชุด PG-19 ราว 10,600 เอกสาร ทุกไฟล์ที่บีบอัดถูกคลายกลับจริงและตรวจ SHA-256 จาก footer ผลคือ 452 round trips ผ่านทั้งหมด ไม่มี failure จึงไม่ได้เอา ratio ที่อ่านคืนข้อมูลไม่ได้มาปนในผลลัพธ์
อะไรที่เวิร์ก และอะไรที่ไม่เวิร์ก
gzip ได้เปรียบราว 15% แบบคงที่ตั้งแต่ 64 MB ถึง 4 GB เพราะหน้าต่างของมันเล็กมากและอิ่มตัวอยู่แล้ว ส่วน LZMA และ zstd ที่มีหน้าต่างใหญ่ ได้ช่องว่างเพิ่มขึ้นตามขนาดข้อมูลก่อนจะเริ่ม plateau เมื่อชุดข้อมูลใหญ่เกินหน้าต่างมากพอ
ข้อยกเว้นชัด ๆ คือ bzip2: pre-tokenization แพ้ราว 3.9% ทุกขนาด เพราะมันอาศัยโครงสร้างระดับ byte ของข้อความที่ถูกทำลายไปแล้ว และ zstd ระดับเร็วมากอาจติดคอขวดที่ขั้น tokenization แทน
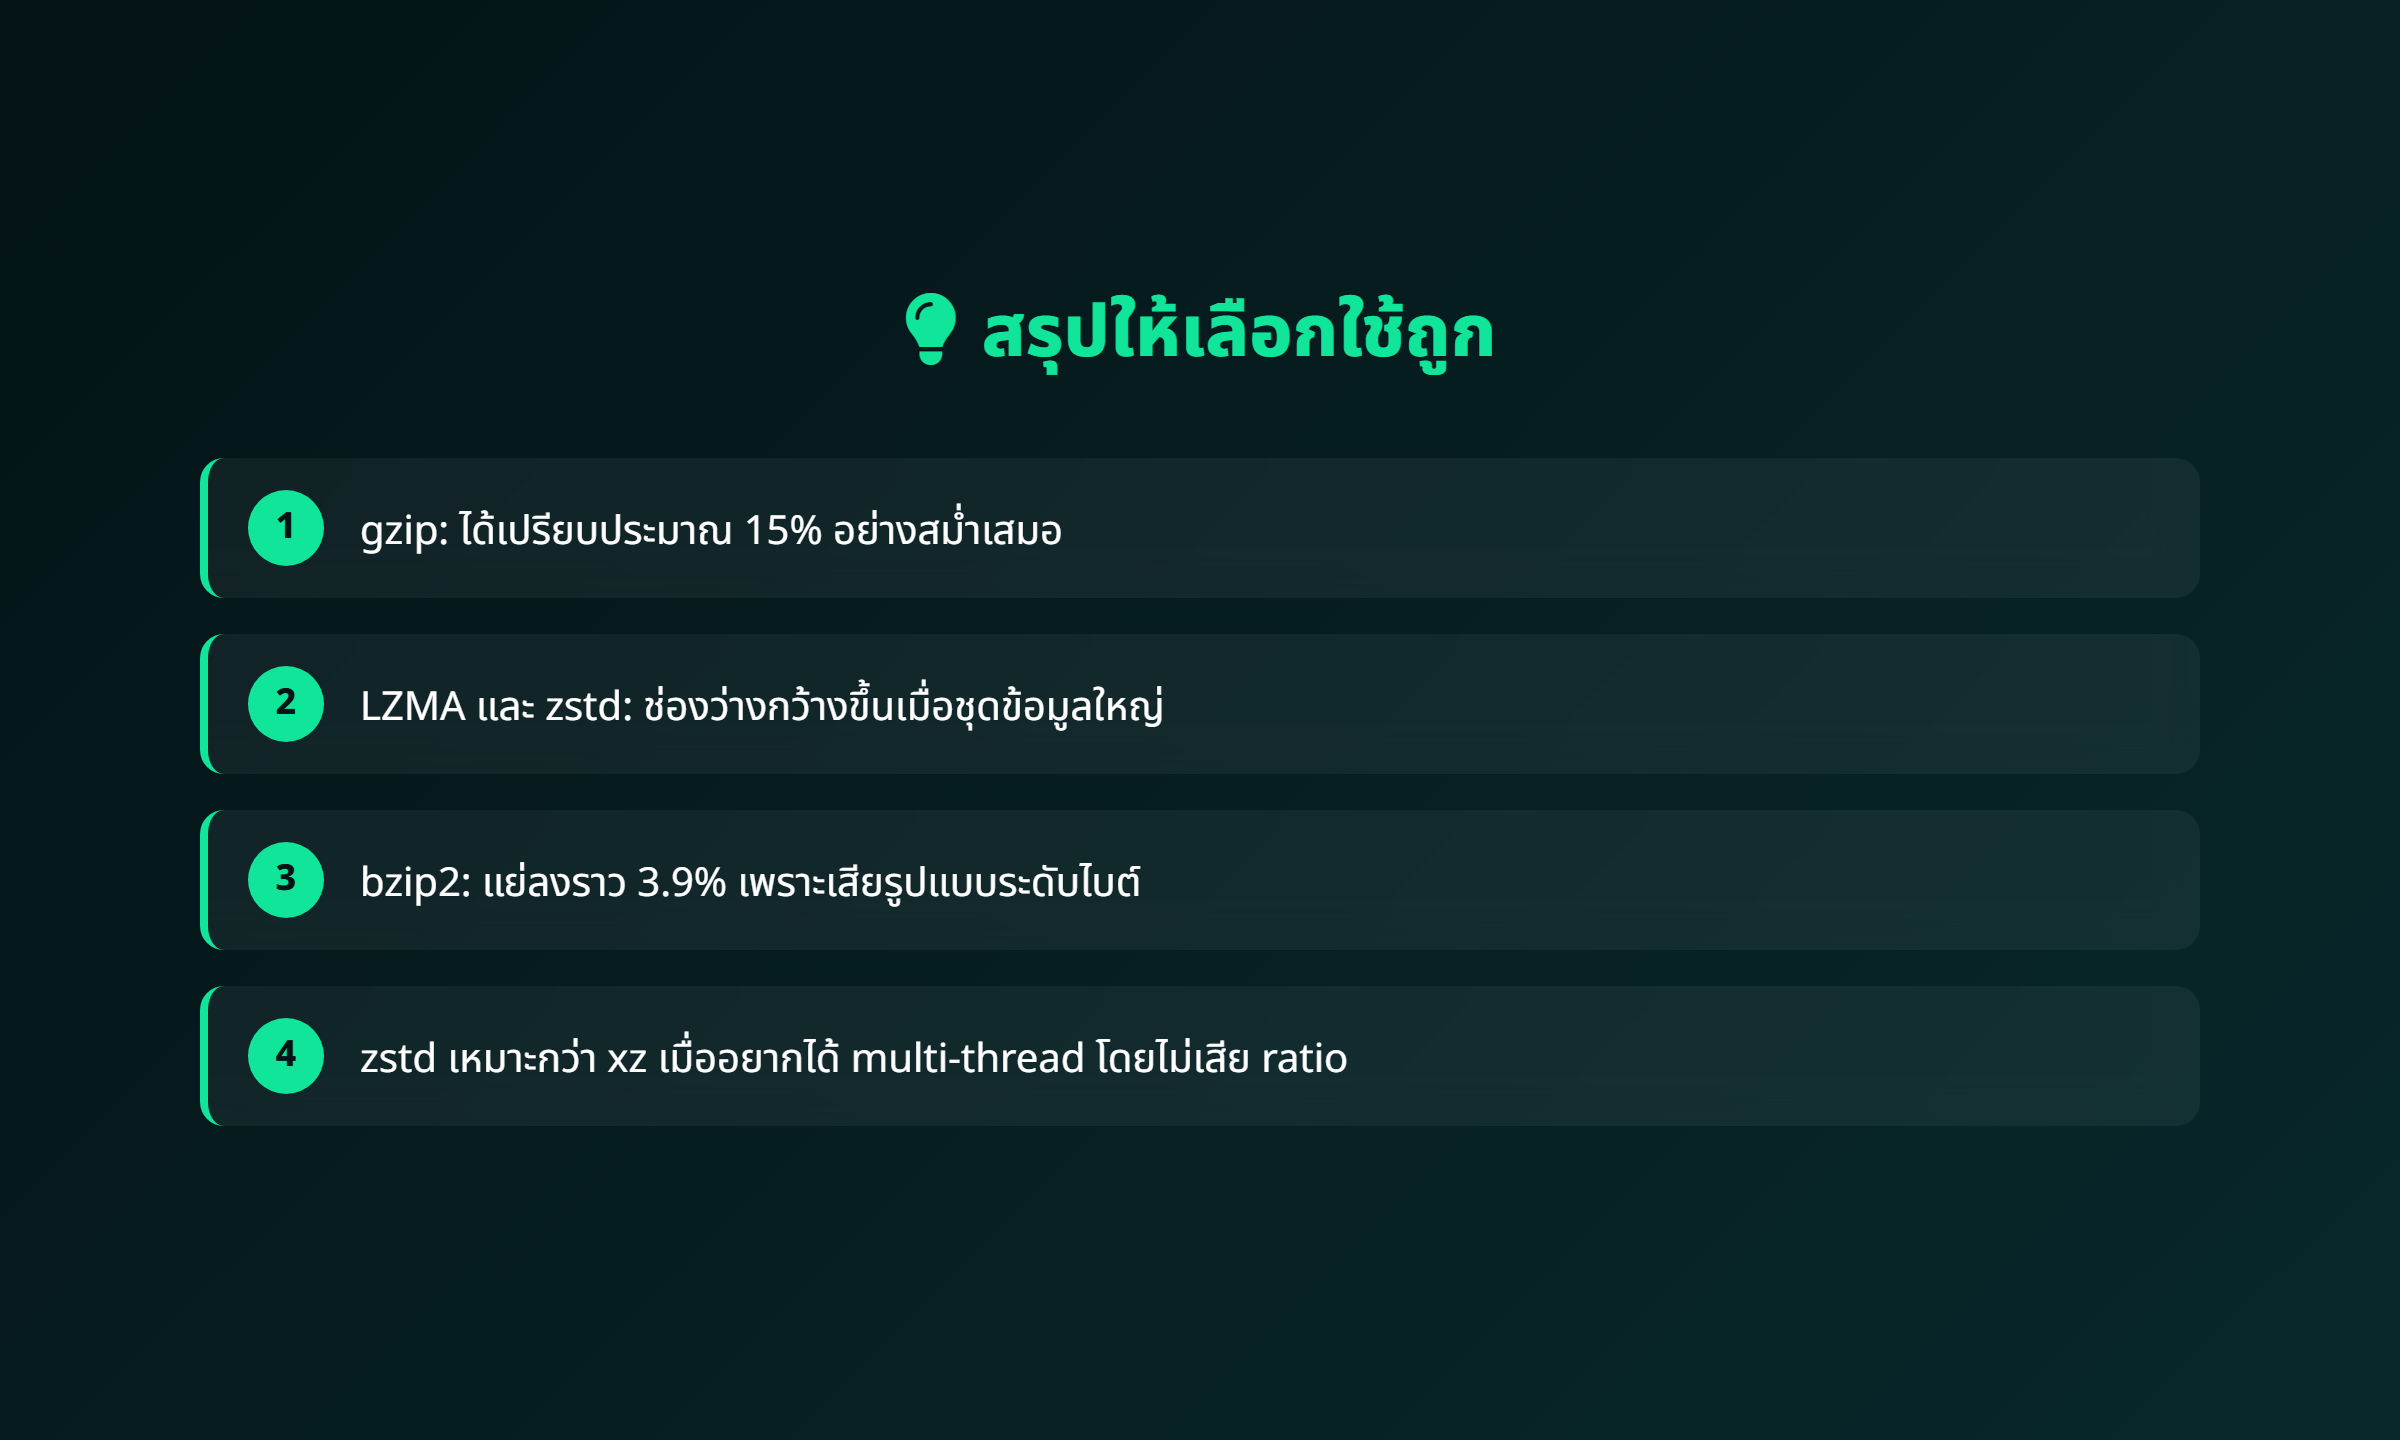
ผลไม่ได้เหมือนกันทุก compressor: gzip/LZMA/zstd ไปคนละทางกับ bzip2
ใช้กับงานไหนได้บ้าง
เหมาะกับการเก็บคลังข้อความขนาดใหญ่, ข้อมูลฝึก LLM, evaluation set หรือ retrieval corpus ที่ต้อง tokenize อยู่แล้ว และ cold storage ที่เขียนครั้งเดียวอ่านไม่บ่อย เพราะตอนคลายไฟล์ต้องใช้ tokenizer เดิมด้วย
ยังไม่ควรใช้แบบเหมารวมกับ code, JSON หรือ log เพราะยังไม่ทดสอบ และ archive นี้บันทึกเพียงชื่อ tokenizer—not vocabulary—ดังนั้นผู้ใช้ต้องมี encoding เดิมเพื่อคลายไฟล์ นอกจากนี้ SHA-256 ที่ใส่ไว้เป็นการตรวจความเสียหาย ไม่ใช่การเข้ารหัสหรือยืนยันตัวตน
สรุป
บทเรียนที่น่าสนใจไม่ใช่ “tokenize ก่อนแล้วชนะเสมอ” แต่คือการวัดให้เห็นว่าอะไรเป็นต้นเหตุของผลลัพธ์: ความหนาแน่นของ representation, ขนาด dictionary window และวิธีแบ่งงานหลาย thread มีผลต่างกันมากในแต่ละ backend
ที่มา: DEV Community และ parmar บน GitHub
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!