
หลายคนอาจเคยคิดว่า “โมเดล AI ใหญ่ ๆ อย่าง DeepSeek หรือ Qwen ระดับ 3 แสนล้านตัวแปร ต้องรันบนคลัสเตอร์หลายหมื่นล้านบาทเท่านั้น” — แต่วันนี้เรื่องนั้นไม่จริงอีกต่อไปแล้ว
มีโปรเจกต์เปิดซอร์สชื่อ FreeToken ที่ทำสิ่งที่น่าทึ่ง: เปลี่ยนเครื่องคอมพิวเตอร์ที่คุณมีอยู่ตอนนี้ ไม่ว่าจะเป็นการ์ดจอเล่นเกมหรือแล็ปท็อปธรรมดา ให้กลายเป็น ศูนย์ข้อมูล (data center) ส่วนตัว ที่รันโมเดลขนาด 380,000 ล้าน – 750,000 ล้านตัวแปรได้แบบเต็มกำลัง
เครื่องที่เคยใช้เปิดเกมตอนนี้รัน “สมอง AI” ที่ใหญ่พอจะเทียบคลัสเตอร์ราคาแพงได้แล้ว — และมันฟรี แบบ open source
ฟังดูเว่อร์ไปหน่อยใช่ไหม? วันนี้ผมจะพาคุณไปดูให้เห็นว่า ทำไมผู้ใช้เครื่องคอมพิวเตอร์ธรรมดาถึงตื่นเต้นกับ FreeToken มาก
FreeToken คืออะไร
FreeToken คือระบบให้บริการโมเดล AI (inference engine) ที่ถูกออกแบบมาเพื่อฮาร์ดแวร์ปลายทาง (edge) โดยเฉพาะ มันเกิดจากทีมนักวิจัยที่คุ้นชื่อกันดีในวงการ — ผู้เขียนคือ Shuo Yang, Ion Stoica, Matei Zaharia, Kurt Keutzer (UC Berkeley), Song Han (MIT) และ Chenfeng Xu (UT Austin) เปิดตัวภายใต้ชื่อ FlashML
หัวใจของมันคือการ “มองเครื่องคอมพิวเตอร์ของคุณทั้งเครื่อง” — ไม่ใช่แค่การ์ดจอใบเดียว แต่รวม CPU, แรม, บัส PCIe และการ์ดจอ เข้าด้วยกันเป็นแพลตฟอร์มเดียว แล้วค่อย ๆ โยนงานให้แต่ละส่วนตามที่มันถนัด
ผลลัพธ์คือโมเดลที่เคยต้องการศูนย์ข้อมูล กลับรันได้อย่างลื่นไหลบนเครื่องเดี่ยว ตั้งแต่แล็ปท็อปที่มีการ์ดจอแค่ 8GB ไปจนถึงเวิร์กสเตชันการ์ดจอใบใหญ่
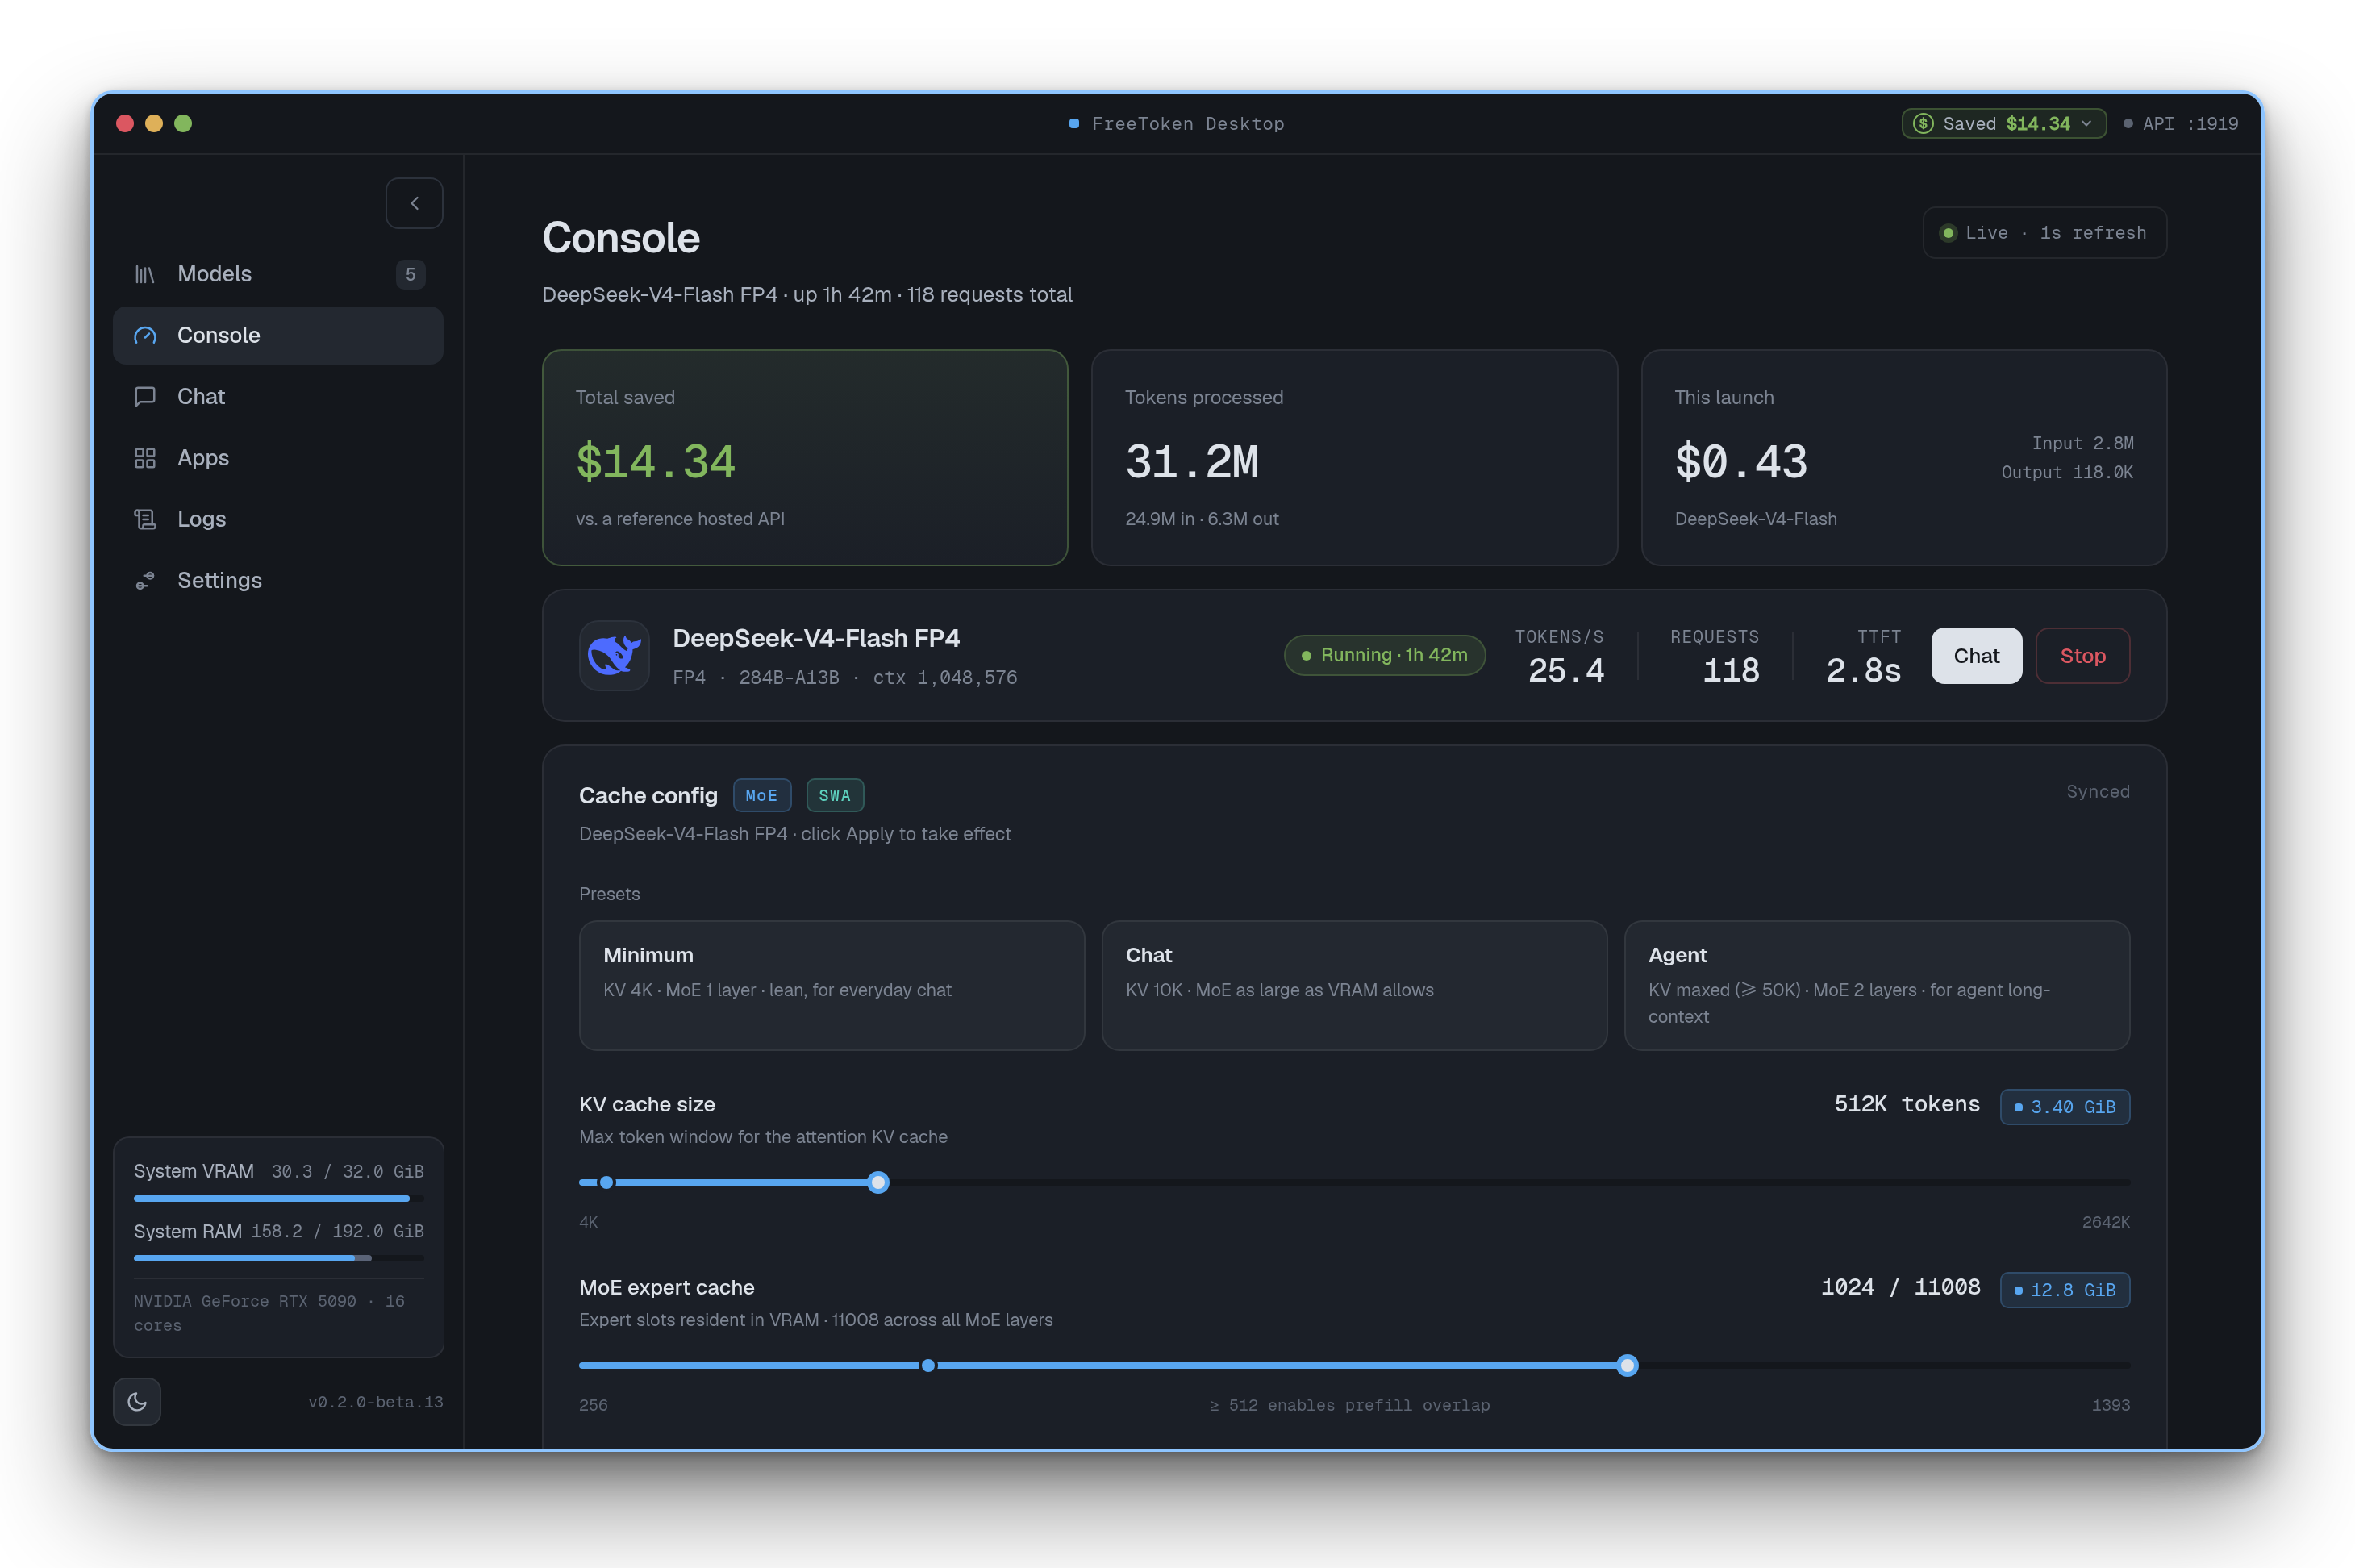
FreeToken console — รันโมเดลใหญ่จากการ์ดจอเดียว (ที่มา: FlashML-org/FreeToken)
แถมมันเป็น open source ภายใต้ Apache-2.0 — มีทั้ง GitHub, บทความวิชาการบน arXiv และหน้าเว็บ flashml.ai สำหรับดาวน์โหลดแอปเดสก์ท็อป
หัวใจไม่ใช่การ์ดจอ แต่คือสถาปัตยกรรม MoE
ก่อนจะเข้าใจว่า FreeToken ฉลาดยังไง ต้องรู้ก่อนว่าโมเดลยุคใหม่ที่ว่ารันบนเครื่องบ้านได้จริงนั้นเป็นเพราะอะไร
โมเดลเหล่าใหญ่ยุคใหม่ใช้สถาปัตยกรรมที่เรียกว่า Mixture-of-Experts (MoE) — หมายความว่าในแต่ละชั้น (layer) มันจะมี “ผู้เชี่ยวชาญ” (expert) เล็ก ๆ จำนวนมาก แต่ละคำที่เข้ามาจะถูกส่งไปให้ผู้เชี่ยวชาญเพียงไม่กี่คนเท่านั้น
ยกตัวอย่างอย่าง DeepSeek-V4-Flash ที่มีพารามิเตอร์ 284,000 ล้านตัว แต่ในการประมวลผลหนึ่งคำ มันเปิดใช้งานเพียง 6 จาก 256 ผู้เชี่ยวชาญต่อชั้น หรือคิดเป็นแค่ราว 13,000 ล้านพารามิเตอร์เท่านั้น พอรวมทั้งหมด 43 ชั้น จึงมีขนาดพอจะใส่ลงในการ์ดจอ 32GB ได้
นี่แหละคือกุญแจสำคัญ — ความเบาในการคำนวณต่อคำ ทำให้โมเดลยักษ์รันบนฮาร์ดแวร์บุคคลได้ แต่ก็มีความท้าทายตามมาคือ “กองผู้เชี่ยวชาญทั้งหมด” ยังมีขนาดมหึมา และต้องถูกส่งผ่านบัส PCIe เข้าออกอยู่ตลอดเวลา
ตัวอย่างที่ชัดเจนคือการทำงานของ DeepSeek-V4-Flash ในรูปแบบ FP4 ต้องขนย้ายน้ำหนักผู้เชี่ยวชาญราว 140GB ตลอดการทำงาน แล้วถ้าการ์ดจอช้าก็อาจเพิ่มความหน่วงเป็นวินาที ๆ — นี่คือปัญหาที่ FreeToken ถูกสร้างมาเพื่อแก้
Qwen3.6-35B-A3B โมเดล MoE ที่ FreeToken รองรับ (ที่มา: Qwen)
FreeToken แก้ 3 กำแพงของการรันโมเดลบนเครื่องบ้าน
ตามบทความต้นทาง FreeToken โคดีไซน์ระบบทั้งหมดเพื่อจัดการความท้าทาย 3 ระดับ:
- ปัญหา Prefill (ความหน่วงก่อนคำแรก): มันใช้ double-buffer — ระหว่างที่การ์ดจอคำนวณชั้นที่
lอยู่ มันก็สตรีมผู้เชี่ยวชาญของชั้นถัดไปผ่าน PCIe ล่วงหน้า ทำให้ไม่ต้องรอให้ I/O คอขวด - ปัญหา Decode (การแคชผู้เชี่ยวชาญ): มันใช้ policy ที่เรียกว่า
q*ซึ่งเป็นแบบ bandwidth-adaptive — วัดแบนด์วิธของบัสจริง ๆ แล้วตัดสินใจว่าจะส่งผู้เชี่ยวชาญที่พลาดแคช ไปทำบนการ์ดจอ หรือทำบน CPU แบบเรียลไทม์ - ปัญหา Resource (แรมไม่แน่นอน): มันใช้ elastic memory — ถ้าเปิดเกมหรือเรนเดอร์งานหนัก การ์ดจอเห็นแรมล้น มันจะอัดแคชผู้เชี่ยวชาญให้เล็กลงแล้วโยนงานไปทำบน CPU แทนแบบ 0 หยุดทำงาน ไม่ล้มทั้งที่ OOM
นอกจากนี้ยังมี semantic-aware caching — ในงาน Agent ที่แก้ไขคอนเท็กซ์บ่อย ๆ มันจะตั้งจุดเช็คพอยต์ตามขอบเขตความหมาย เช่น จุดที่ตัดบล็อกคิดหรือบล็อกเรียกเครื่องมือ แล้วพอคอนเท็กซ์ถูกแก้ ก็จะคำนวณใหม่เฉพาะส่วนที่เพิ่มเข้ามาเท่านั้น ไม่ต้องไล่คำนวณประวัติทั้งหมดซ้ำ
โมเดลใหญ่แค่ไหนก็เป็นเรื่องของเครื่องเดียว
สิ่งที่ทำให้ FreeToken ต่างจากเครื่องมืออื่นคือมัน change สิ่งที่เครื่องแต่ละระดับ “ทำได้จริง”:
- แล็ปท็อปการ์ดจอ 8GB: รันโมเดล 35B ได้
- เดสก์ท็อปเกมมิ่ง 32GB: รันโมเดล 284B ได้แบบโต้ตอบทันใจ
- เวิร์กสเตชันการ์ดจอใบเดียว: รัน GLM-5.2 (753B) ได้
โมเดลที่ใหญ่ที่สุดที่รันได้บนเครื่องเดียว: 753B
และรองรับโมเดล MoE มากกว่า 20 รุ่น เช่น Qwen3.6-35B-A3B, DeepSeek-V4-Flash, GLM-5.2 ครอบคลุมทั้งการ์ดจอ RTX 30/40/50 และรูปแบบค่่าน้ำหนักหลายแบบ เช่น MXFP4, NVFP4, FP8, BF16
ตัวเลข Benchmark ที่พูดแทนกันได้
ถึงเวลาดูผลลัพธ์จริง โดยอิงจากบทความ arXiv 2608.16157 ซึ่งเป็นตัวเลขที่ผ่านการเผยแพร่ในงานวิจัย:
- RTX 5090: รัน Qwen3.6-35B-A3B ได้ 77–83 tok/s และ DeepSeek-V4-Flash ได้ 22–25 tok/s
- แล็ปท็อป RTX 4060 (8GB): รันโมเดล 35B ได้ 39.3 tok/s — เร็วกว่าความเร็วเฉลี่ยของ Codex (33 tok/s)
- TTFT (ความหน่วงก่อนคำแรก): แย่ที่สุดไม่เกิน 44 วินาที ขณะที่คู่แข่งแย่ที่สุดเกิน 150 วินาที
- ประสิทะภาพรวม: บนเครื่องผู้บริโภค 5 เครื่องดีขึ้น 1.3–2.1 เท่า และดีกว่า system ชั้นนำราว 1.5–2.3 เท่า
สำคัญกว่านั้นคือ “ความคงที่” — เมื่อ workload กลายเป็นแบบ Agent (มี tool call เยอะ) ความเร็ว decode ของ FreeToken ยังคงต่างจากโหมดเดี่ยวแค่ 12% แต่คู่แข่งทรุดลงมาก
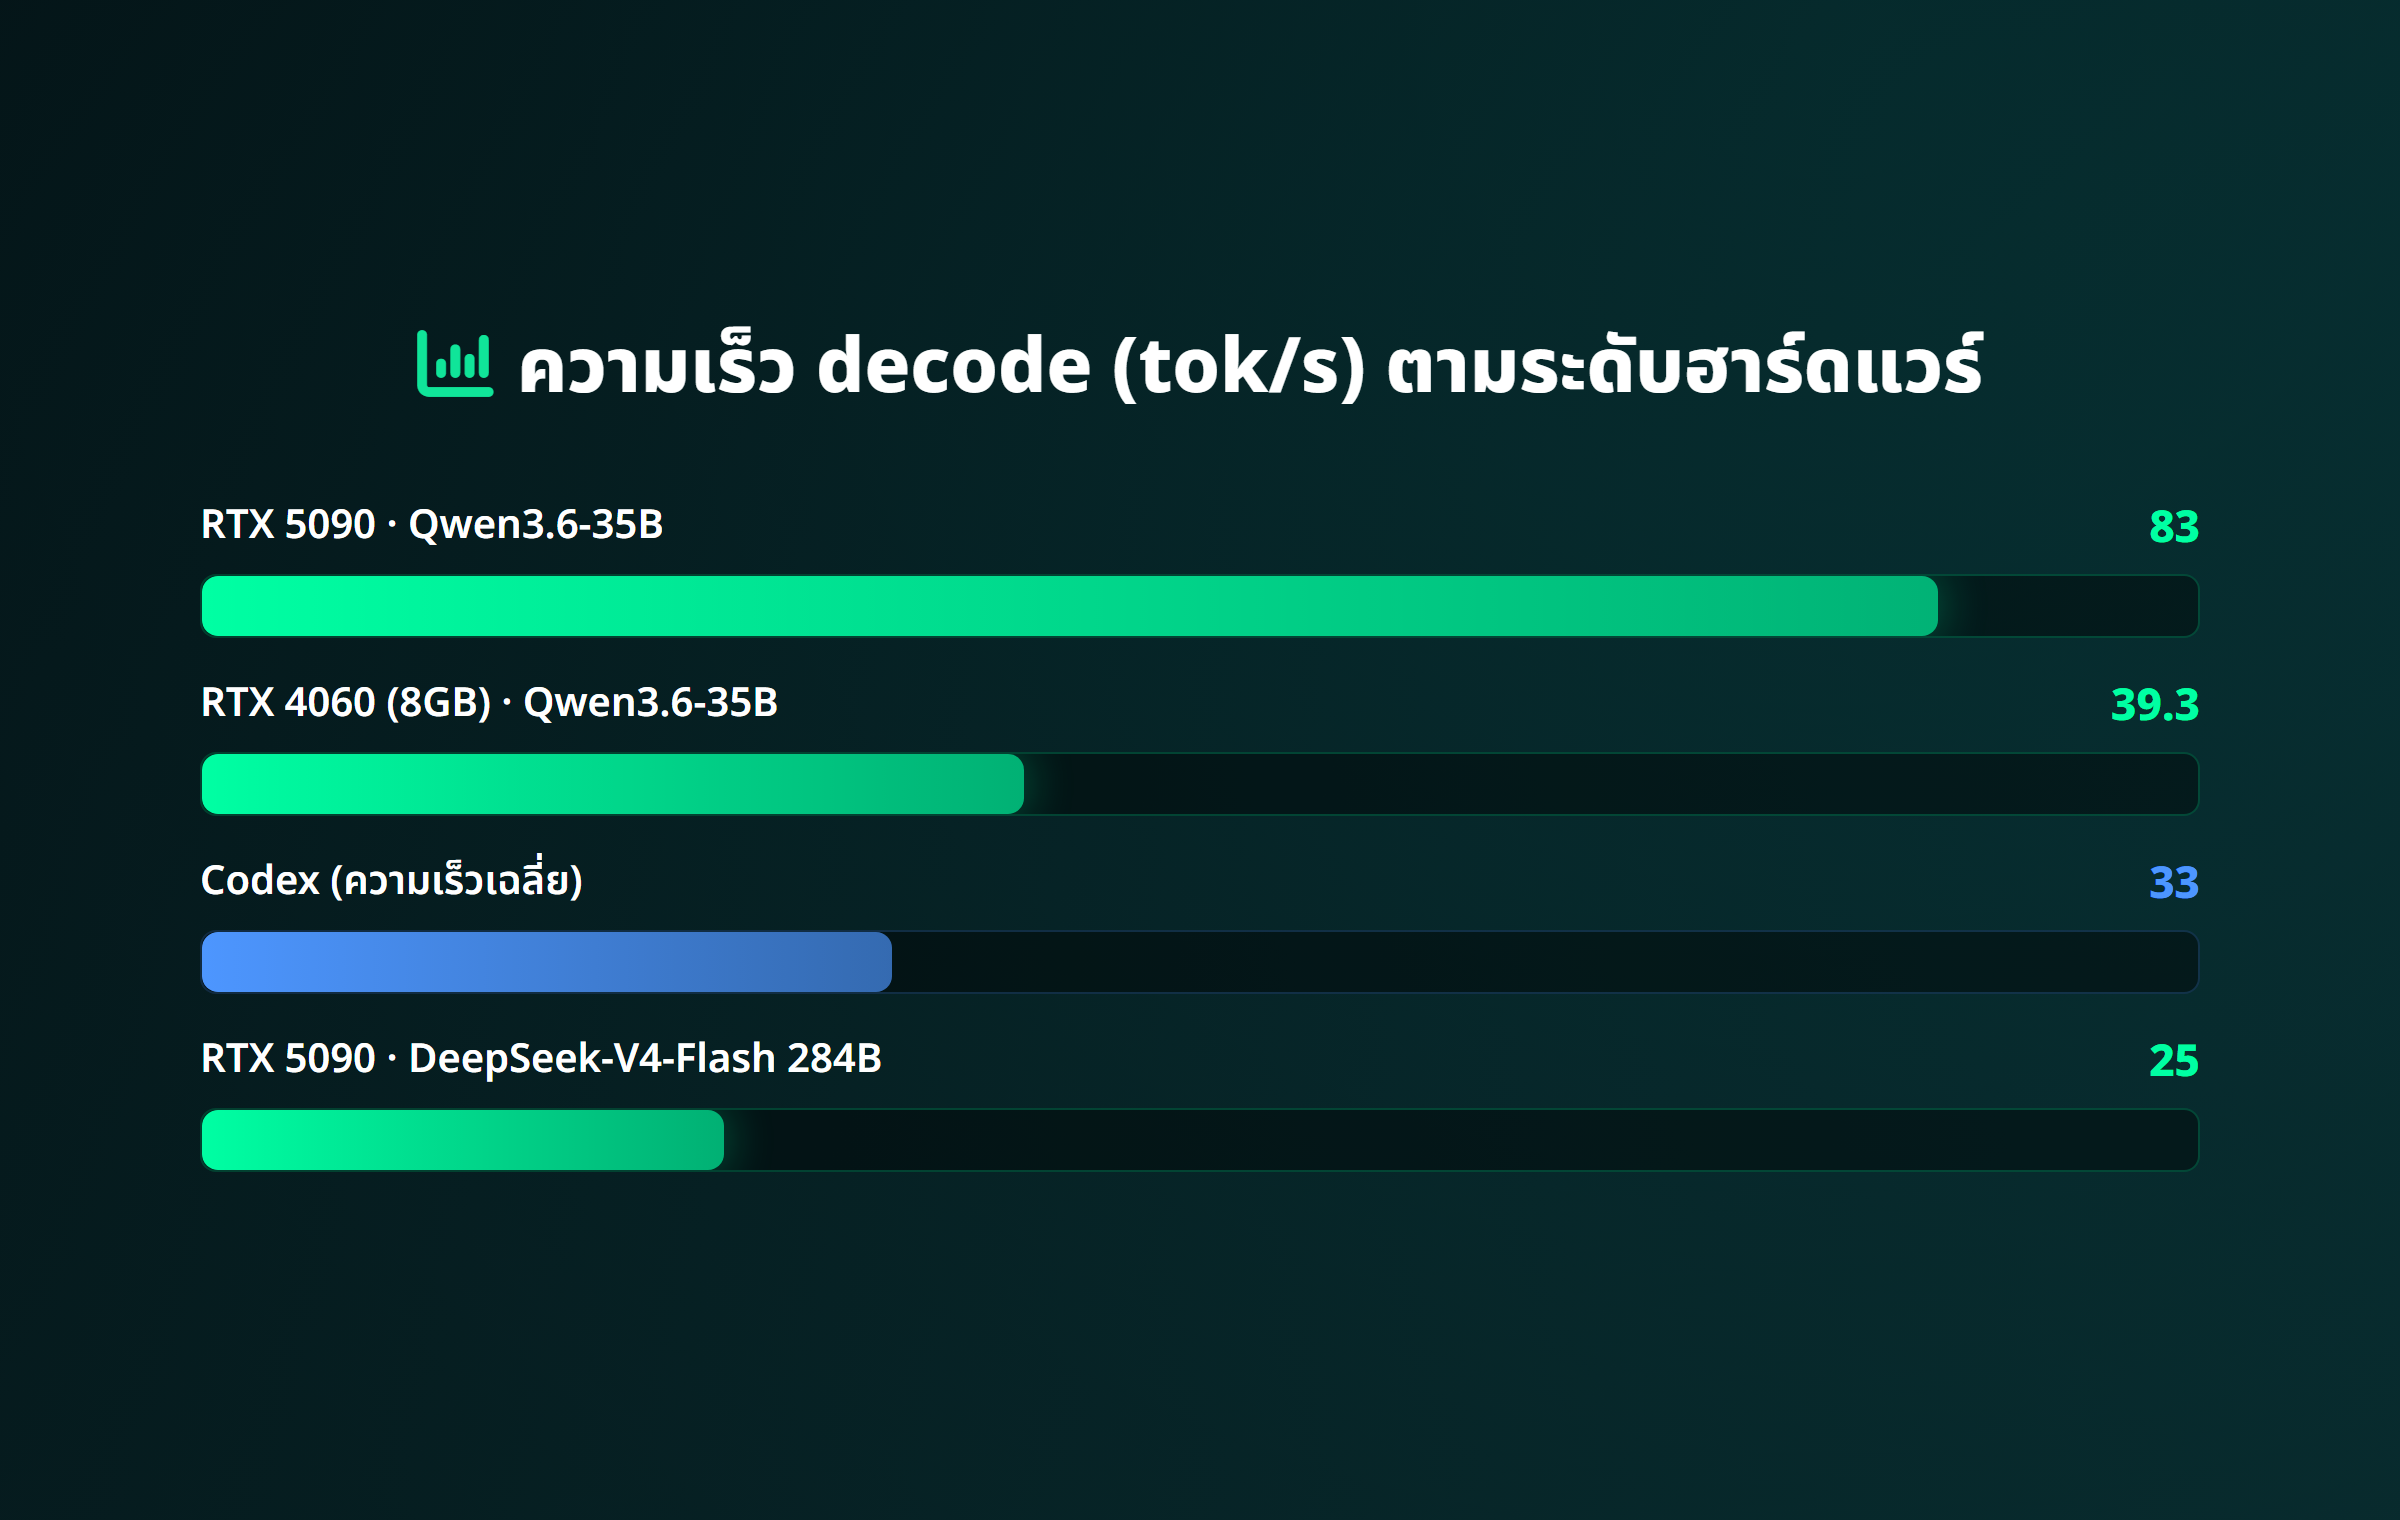
ความเร็ว decode ตามระดับฮาร์ดแวร์ (ข้อมูลจาก arXiv 2608.16157)
| มิติ | FreeToken | Ollama |
|---|---|---|
| แนวทาง | บริหารรวม CPU+แรม+PCIe+GPU | พึ่งการ์ดจอเป็นหลัก |
| รองรับโมเดล MoE | เนทีฟ 20+ รุ่น | บางรุ่นไม่รองรับ |
| ความเร็ว | เร็วกว่า 1.3–2.3 เท่า | เป็นฐานอ้างอิง |
| TTFT | น้อยกว่า 44 วิ | เกิน 150 วิในบางกรณี |
| แรมไม่พอ | ยืดหยุ่น ไม่ล้ม | เสี่ยง CUDA OOM |
วิธีใช้: ติดตั้งในไม่กี่บรรทัด
ถ้าอยากลองเองก็ไม่ยาก มีทั้งแบบแอปเดสก์ท็อปสำหรับ Windows/Linux และแบบ command line
uv pip install "freetoken[accel]"หรือสร้างจาก source:
git clone https://github.com/FlashML-org/FreeToken.git && cd FreeToken
uv venv && source .venv/bin/activate
uv pip install -e ".[accel]"
ใครอยากได้ GUI ก็โหลดแอปได้จาก flashml.ai แล้วเลือกโมเดลที่รองรับ ระบบจะจัดสรร CPU-GPU และปรับค่าตามแบนด์วิธให้อัตโนมัติ
ข้อควรรู้สำหรับรุ่นใหญ่อย่าง DeepSeek-V4-Flash — ผู้พัฒนาระบุว่าควรมี การ์ดจอราว 32GB พร้อมแรมระบบ 192GB ขึ้นไปเพื่อความเสถียร แต่ก็มีระบบยืดหยุ่นชดเชยได้ในระดับหนึ่ง
โมเดล Qwen3.6-35B-A3B บนฮาร์ดแวร์ปลายทาง (ที่มา: Jetson AI Lab)
ใช้งานจริงทำอะไรได้บ้าง
- รัน Coding Agent ในเครื่อง — ใช้งานร่วมกับ Claude Code, OpenCode, OpenClaw, Codex ฯลฯ สำหรับเขียนและดีบักโค้ดแบบหลายรอบ โดยไม่ต้องอัปโหลดข้อมูลขึ้นเน็ต
- เล่นเกมไปด้วย ทำงาน AI ไปด้วย — ระบบ elastic memory จะกันแรมให้ AI แม้เปิดเรนเดอร์ 3D หรือเกมแย่งการ์ดจอ
- ทำงานวิจัยบนเครื่องประจำ — ทดสอบโมเดลเปิดซอร์สตัวใหม่ได้ทันทีโดยไม่ต้องขอจัดสรรคลัสเตอร์
- ให้บริการแชทหลายรอบ — ใช้จุดเช็คพอยต์ลดการคำนวณซ้ำในงานที่ต้องแก้คอนเท็กซ์บ่อย
สรุป 3 ประเด็นที่ควรจำ
เรื่องนี้สำคัญต่อผู้ใช้ปลายทางอย่างไร ผมสรุปเป็น 3 จุด:
- เครื่องที่มีอยู่ก็พอ — ไม่ต้องมีคลัสเตอร์ FreeToken เปลี่ยนการ์ดจอ+แรมที่คุณมีเป็นแพลตฟอร์มรันโมเดลยักษ์ ตั้งแต่ 35B ถึง 753B
- แก้ปัญหาจุดคอขวดที่แท้จริง — MoE เองทำให้โมเดลเบา แต่การขนผู้เชี่ยวชาญผ่าน PCIe คือตัวกินเวลา FreeToken จึงออกแบบ double-buffer, q*, state reuse และ elastic memory มาแก้ตรงจุด
- ตัวเลขมันพูดตรง ๆ — RTX 4060 รัน Qwen3.6-35B ได้ 39.3 tok/s เร็วกว่า Codex และ TTFT ไม่เกิน 44 วิ จึงเป็นเรื่องจริง ไม่ใช่เวทมนตร์
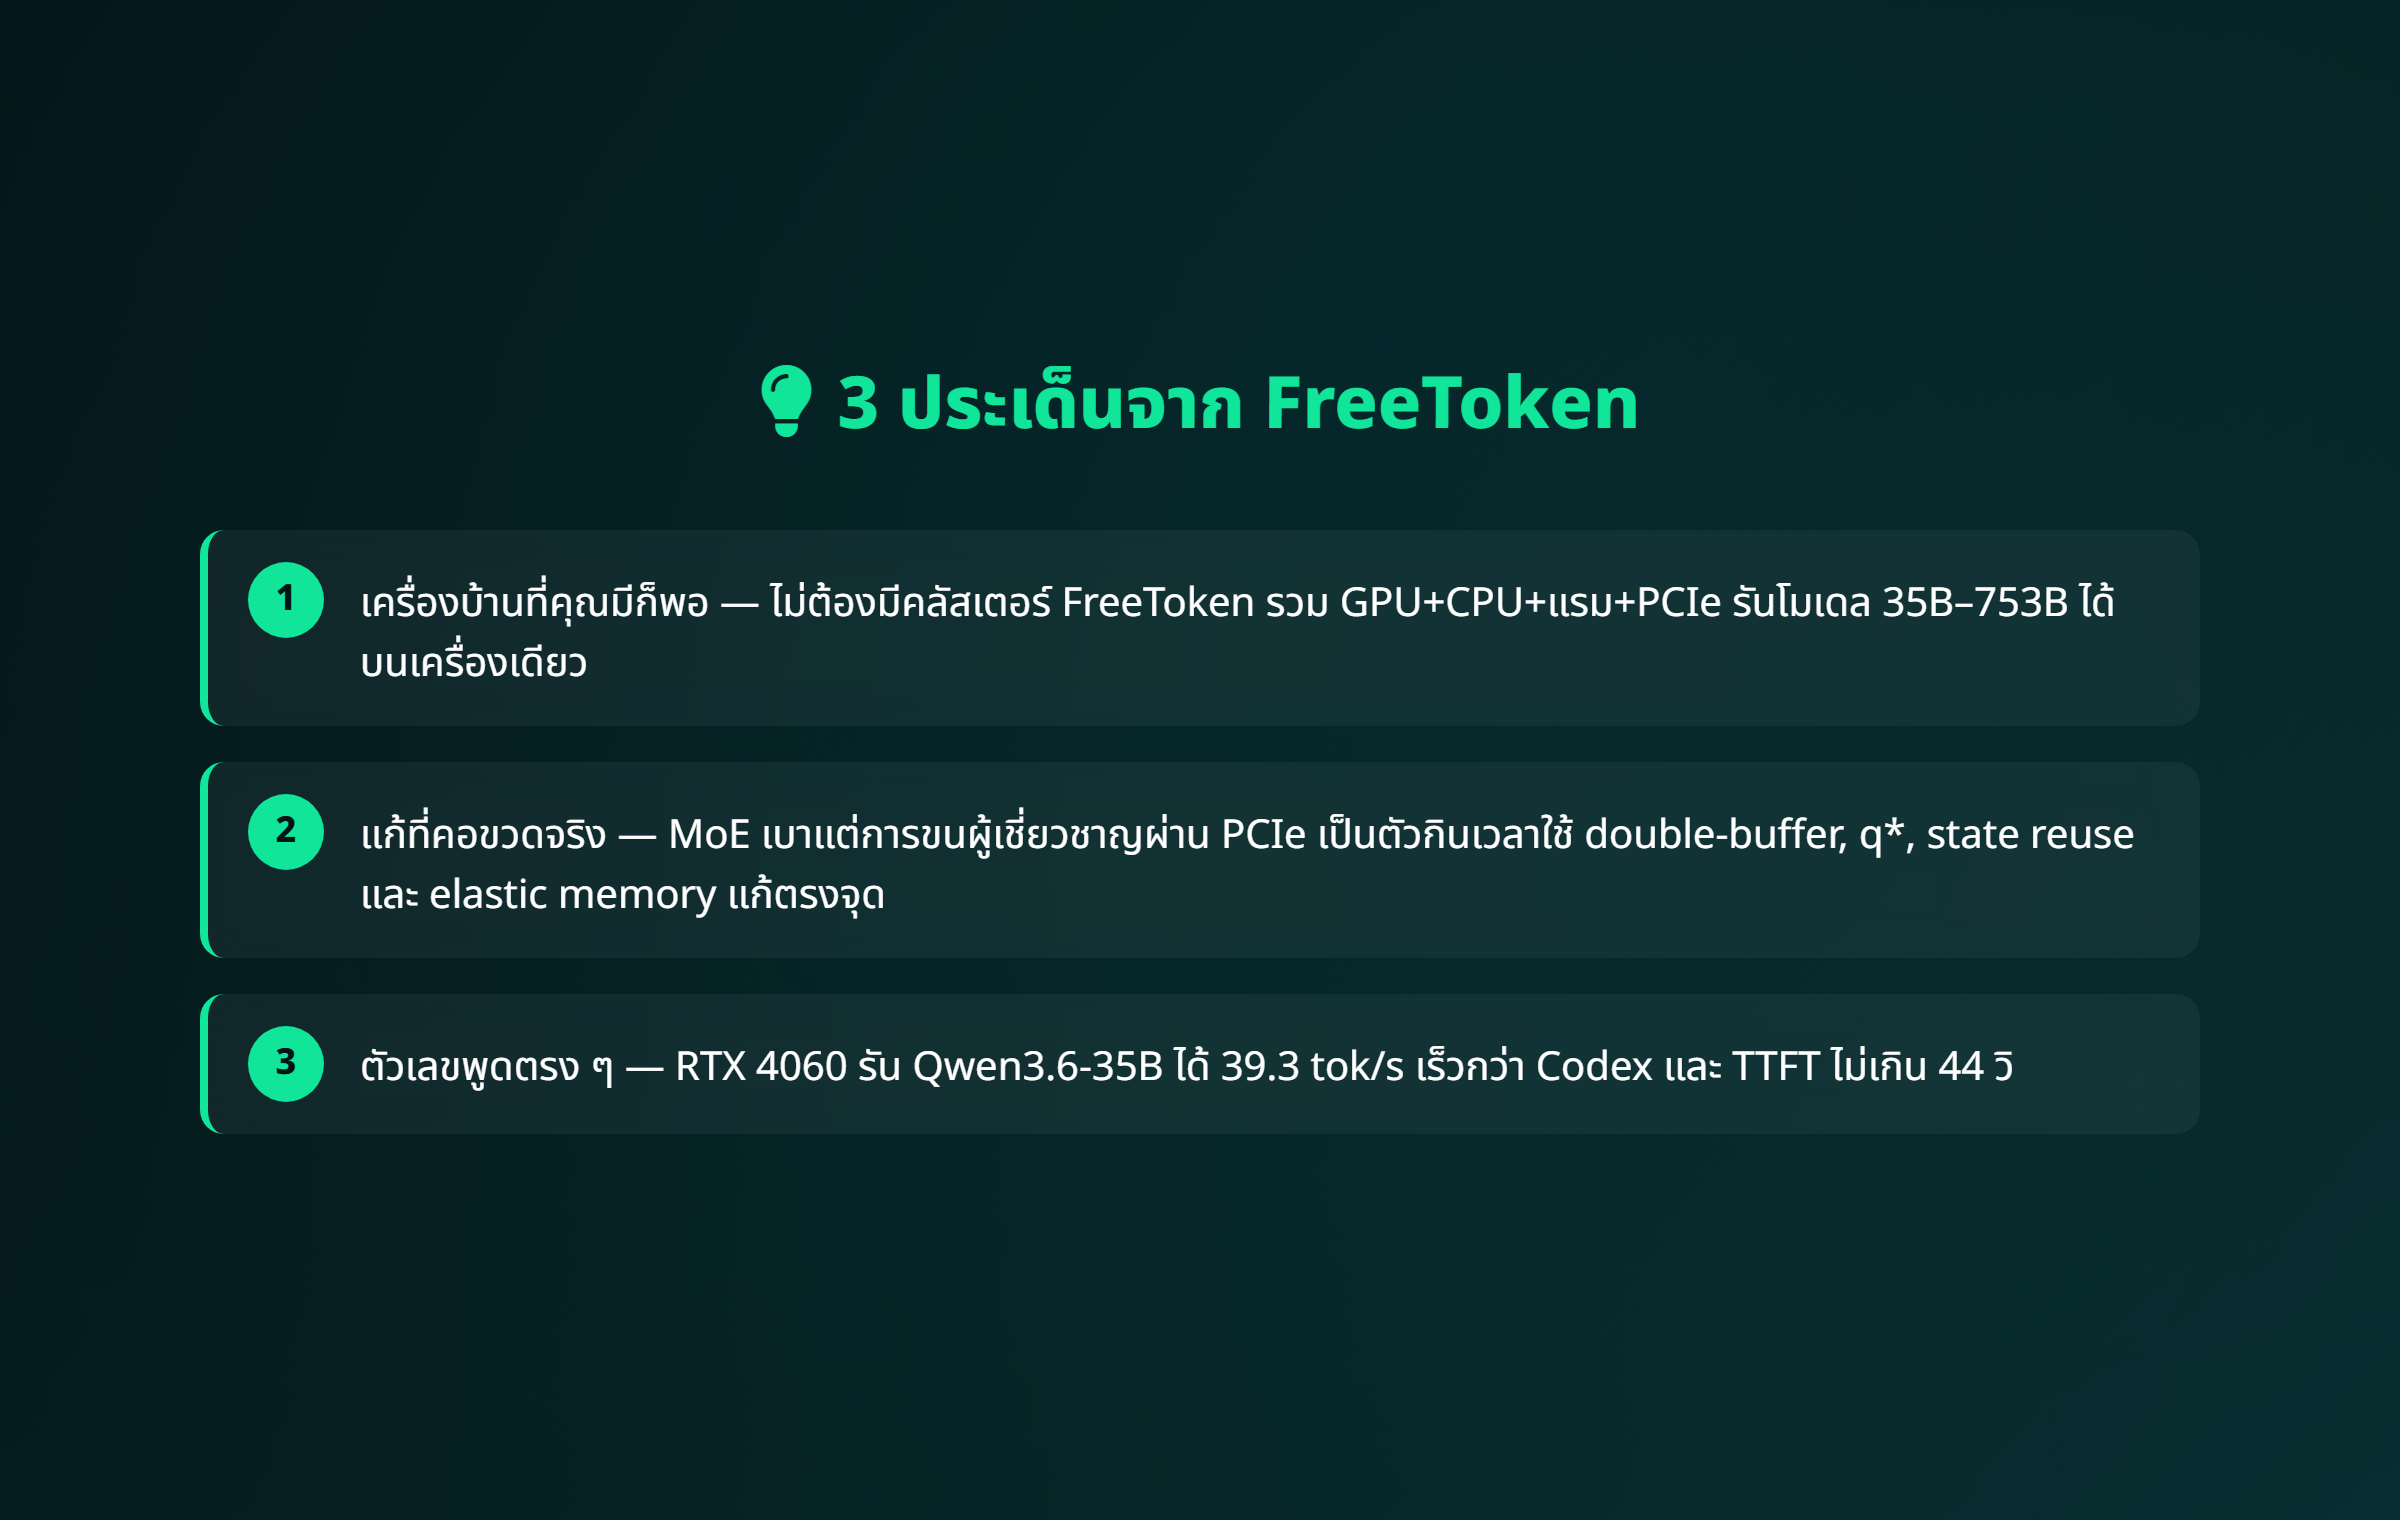
3 ประเด็นจาก FreeToken
ผมว่าสิ่งนี้น่าสนใจมาก เพราะมันขยับเส้นแบ่ง “ใครมีปัญญาใช้ AI แบบโฟรนเทียร์” จากเฉพาะบริษัทใหญ่ที่เช่าคลัสเตอร์ ไปสู่คนธรรมดาที่มีการ์ดจออยู่ในเครื่องนั่นเอง — และนั่นอาจเป็นทิศทางที่ท้องถิ่นและสตาร์ตอัพเล็ก ๆ จะได้ประโยชน์มากที่สุด
ที่มา: ai-bot.cn — FreeToken: 开源端侧 MoE 大模型推理系统, GitHub — FlashML-org/FreeToken, arXiv — FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution, flashml.ai
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!