
ผมเพิ่งเจอข่าว AI อันนึงที่อ่านแล้วรู้สึกว่า "นี่แหละสิ่งที่ทำให้หุ่นยนต์ / รถยนต์ไร้คนขับ / หม้อหุงอัจฉริยะ ยังดูงง ๆ แตกสติอยู่" — และคำตอบมันไม่ใช่โมเดลที่ฉลาดขึ้นเฉย ๆ แต่คือ โมเดลที่มองเห็น "สิ่งที่มองไม่เห็น" ได้ มาเล่าให้ฟังเป็นเรื่องแบบเพื่อนคุยกัน
เรื่องคือ LingBot-Depth 2.0 โมเดล "เติมความลึก" (depth completion) จากทีม LingBot ของ Ant Group ซึ่งประกาศพร้อมเปิดซอร์สตัวเข้ารหัสฐาน (backbone) อย่าง LingBot-Vision ให้ใครก็ได้เอาไปต่อยอด
ลองนึกภาพหุ่นยนต์เก็บของในบ้าน แล้วจู่ ๆ เจอ "กระจกเงาบานใหญ่" หรือ "ตู้กระจกใส" — กล้องวัดระยะทั่วไปจะเกิดช่องว่างตรงนั้น เพราะแสงทะลุ/สะท้อนจนอ่านความลึกไม่ได้ หุ่นยนต์ก็เลย "งง" ทั้งที่ตาคนเห็นชัดว่ามีอะไรอยู่ตรงหน้า
LingBot-Depth 2.0 ถูกฝึกมาเพื่อแก้ปัญหานี้โดยเฉพาะ นี่ไม่ใช่โมเดล "ฉลาดขึ้นนิดหน่อย" แต่คือการเปลี่ยนระดับของความเข้าใจเชิงพื้นที่ของเครื่องจักร ผมว่ามันสำคัญกว่าโมเดลภาษาที่คนพูดถึงเยอะเสียอีก ในมุมของหุ่นยนต์และระบบอัตโนมัติ
LingBot-Depth 2.0 คืออะไร — และทำไมต่างจากเดิม
พูดสั้น ๆ มันคือโมเดลที่รับภาพ RGB (ภาพสีธรรมดา) + ค่าความลึกแบบ "ห่าง ๆ" (sparse depth) จากเซนเซอร์ แล้ว เติมเต็มให้เป็นแผนที่ความลึกแบบละเอียด (dense depth) ไม่ใช่แค่บอกว่า "ตรงนั้นห่างเท่าไหร่" แต่ทำให้ภาพโครงสร้าง 3 มิติของทั้งฉากสมบูรณ์และต่อเนื่อง
ความต่างที่ผมว่าเจ๋งที่สุดคือ มันไม่ได้ทำตัวเป็น "โมเดลอ่านภาพธรรมดา" อีกต่อไป แต่ใช้แนวทางที่เรียกว่า masked boundary modeling — สอนโมเดลให้รู้จัก "ขอบ/ขอบเขตของวัตถุ" ก่อน แล้วค่อยเรียนรู้ความหมายเชิงพื้นที่โดยรอบ ซึ่งเป็นสิ่งที่ทำให้มันเข้าใจขอบเขตระหว่าง "กระจกกับของข้างหลัง" หรือ "ผนังกับเฟอร์นิเจอร์" ได้ดีกว่าวิธีเดิมมาก
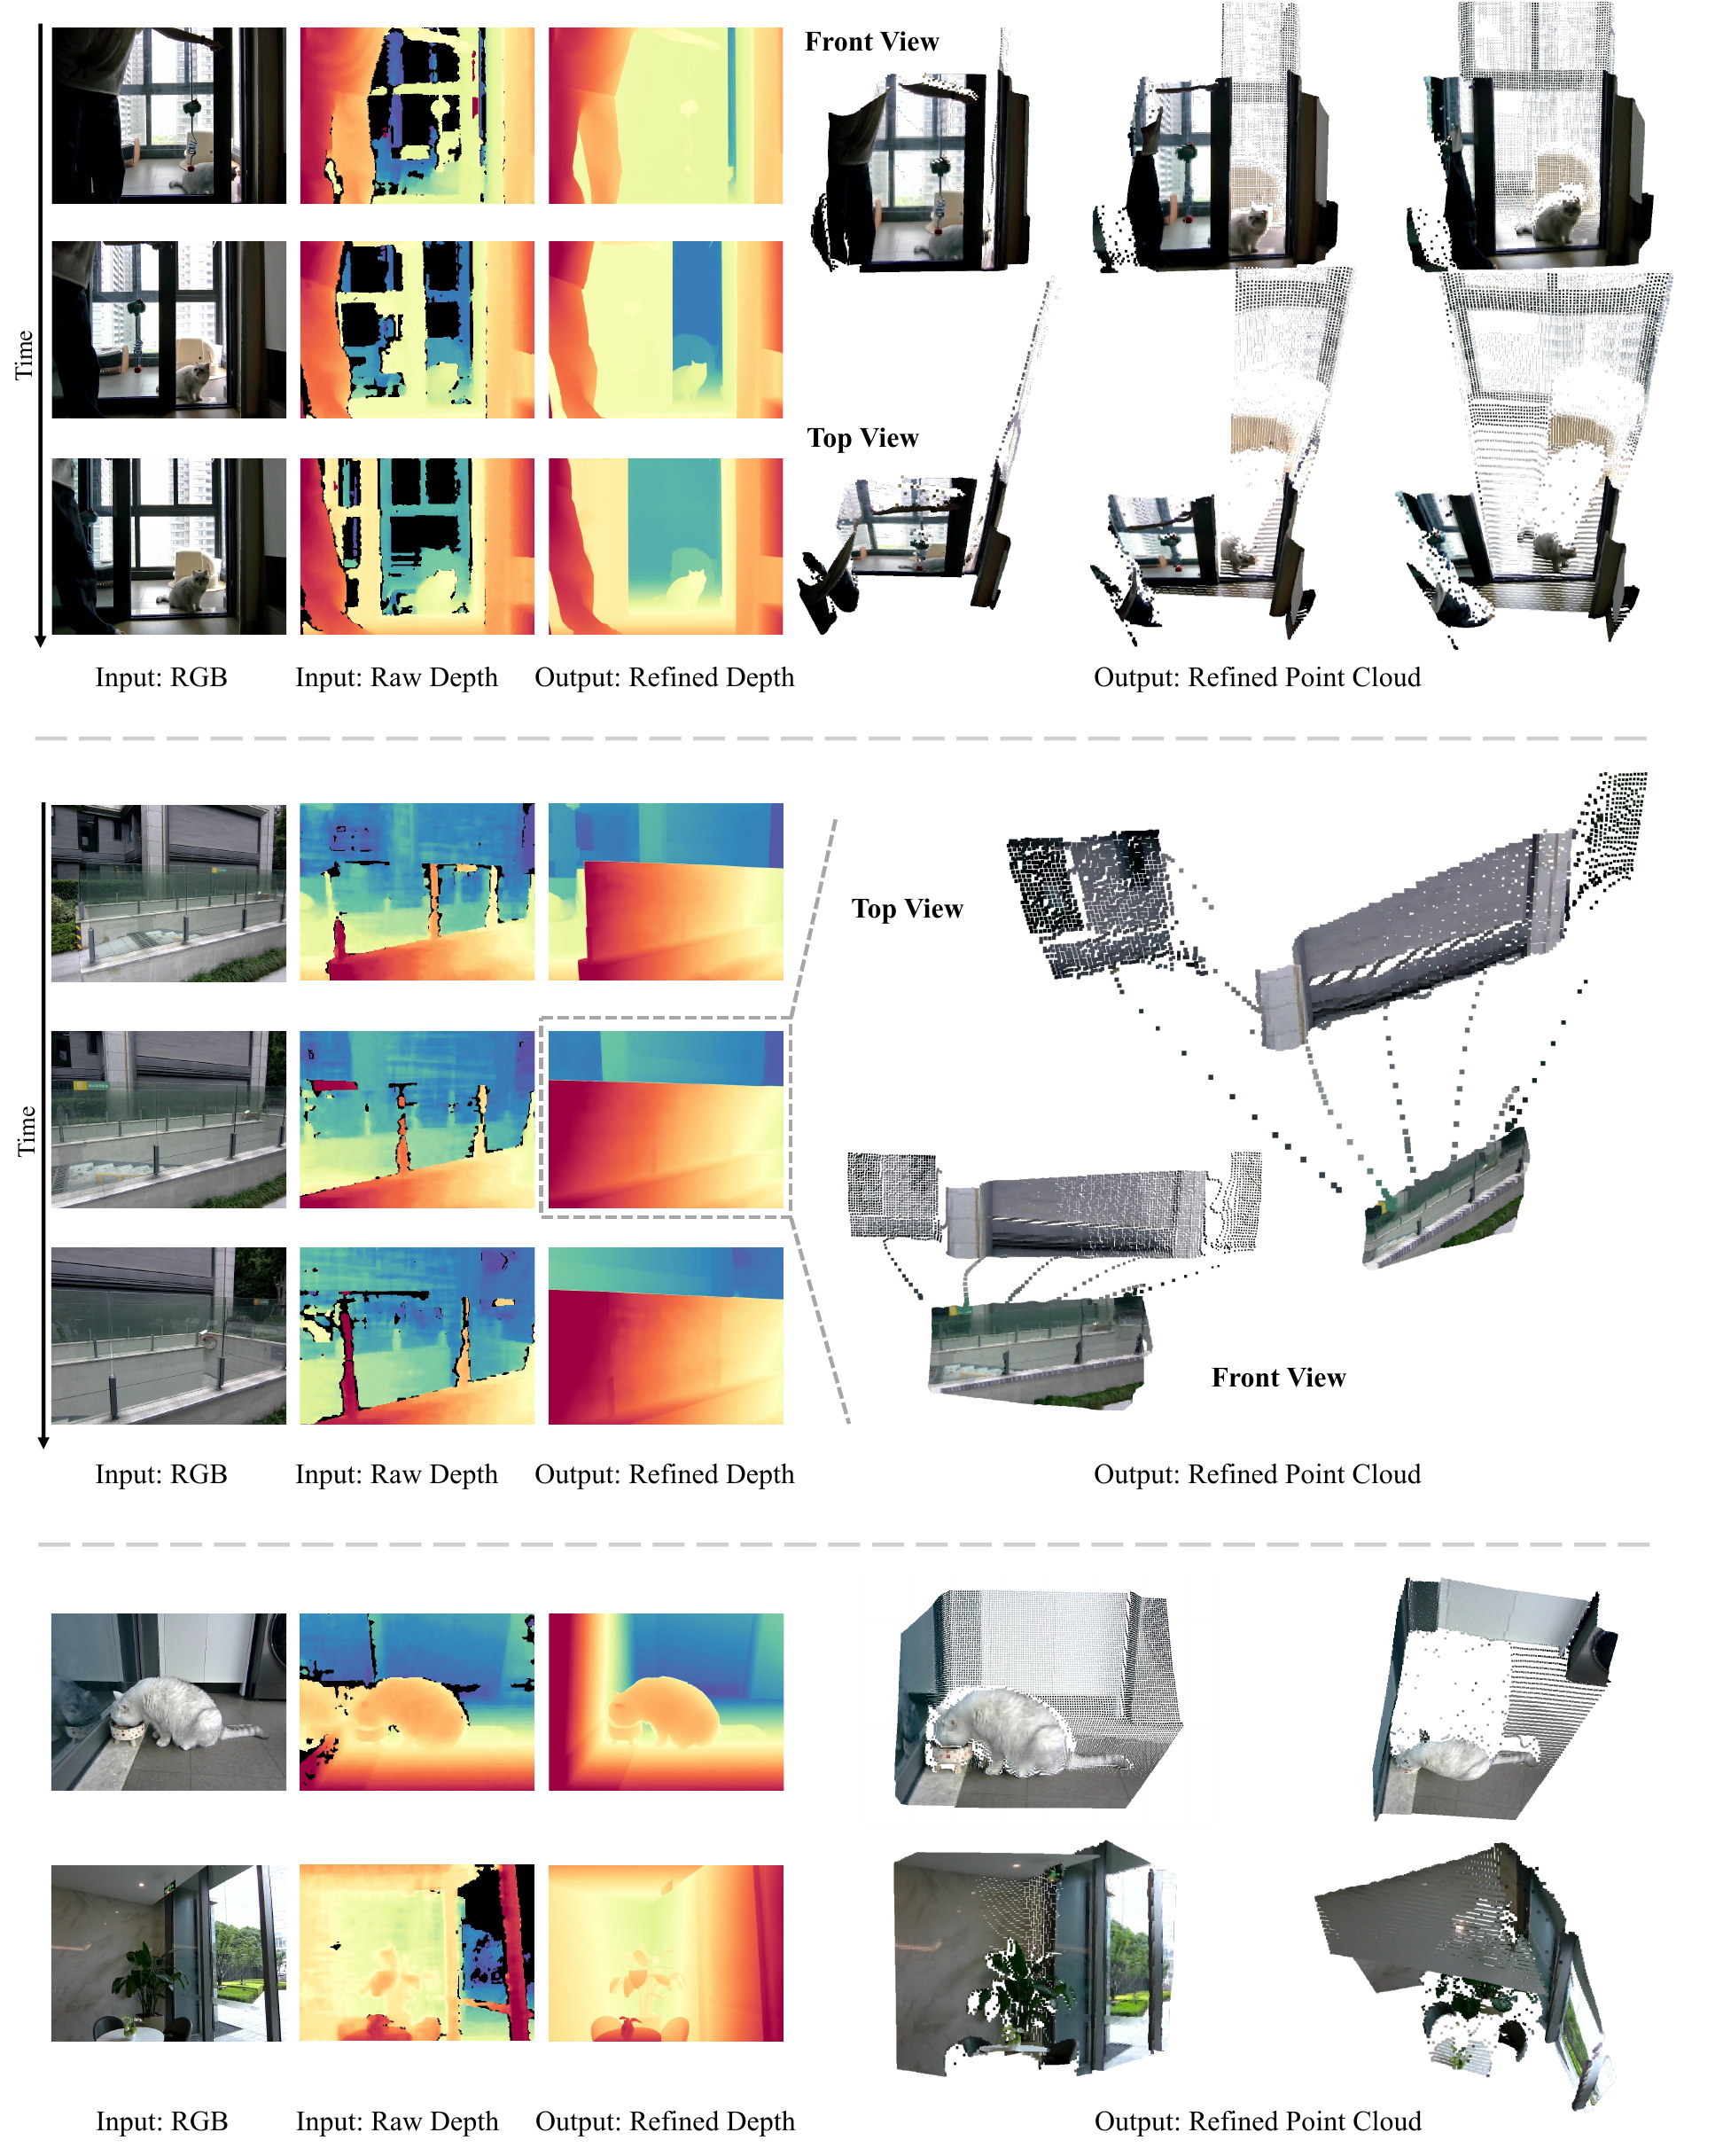
ภาพ: ผลจริงบนฉากกระจก/กระจกเงา — สังเกตว่าจุดที่ 'เซนเซอร์มีรูดำ' ถูกเติมให้เป็นพื้นผิวต่อเนื่อง (ที่มา: GitHub ทางการ)
ภาพบนคือตัวอย่างจริงจากทีมผู้พัฒนา แต่ละกลุ่มแสดงผลเทียบ: ภาพ RGB ที่เห็นด้วยตา → ความลึกดิบจากเซนเซอร์ (มีช่องว่างดำตรงจุดที่แสงสะท้อน/ทะลุ) → ความลึกที่ถูกเติมแล้ว → จุดคลาวด์ (point cloud) 3 มิติที่สมบูรณ์
สังเกตตรง "พื้นกระจก กระจกเงานานบาน ราวบันไดกระจก" ซึ่งเป็นจุดที่กล้อง depth ปกติ "มีรูดำ" — LingBot-Depth 2.0 เติมให้กลายเป็นพื้นผิวที่ต่อเนื่องและเสถียรตลอดทั้งเฟรมของวิดีโอ
ภาพ: LingBot-Depth 2.0 ชนะ 12/16 benchmark depth completion · RMSE ลดจาก 0.132 → 0.062
ตัวเลขที่ทำให้ "หันไปมอง"
ทีมผู้พัฒนาอ้างว่าใน 16 รายการ benchmark depth completion โมเดลทำได้ 12 อันดับ 1 และที่สำคัญที่สุดคือ ในฉากในร่มที่แสงสะท้อน/โปร่งใสแล้ววัดความลึกพลาด (อย่างที่เห็น) ค่า RMSE ลดจาก 0.132 → 0.062 หรือลดลงเกือบครึ่ง
ตัวเลขแบบนี้อ่านแล้วอาจไม่ "ว้าว" เท่าแชทบอท แต่ถ้าคุณเป็นคนที่ตัดสินใจใช้หุ่นยนต์หยิบของในห้องครัวจริง ๆ ค่า RMSE ที่ลดลงครึ่งนี่แปลว่า หุ่นยนต์จะหยิบผิด/ชนของน้อยลงเท่าตัว — นี่คือความต่างระหว่าง "ของเล่นสาธิต" กับ "ของใช้จริง"
สิ่งที่ช่วยให้แม่นขึ้นคือการขยายข้อมูลฝึกซ้อมอย่างมหาศาล: จาก 3 ล้านภาพ เป็น 150 ล้านภาพ (ขยาย 50 เท่า) และ "เทรนด้วยข้อมูลจริง" ที่มีฉากหลากหลายกว่าเดิม
เบื้องหลังความแม่น: LingBot-Vision backbone
LingBot-Depth 2.0 ไม่ได้เกิดมาเดี่ยว ๆ มันพึ่งพาตัวเข้ารหัสฐาน LingBot-Vision ซึ่งเป็นชุด Vision Transformer ที่ฝึกแบบ self-supervised ตั้งแต่ขนาดเล็กถึงใหญ่
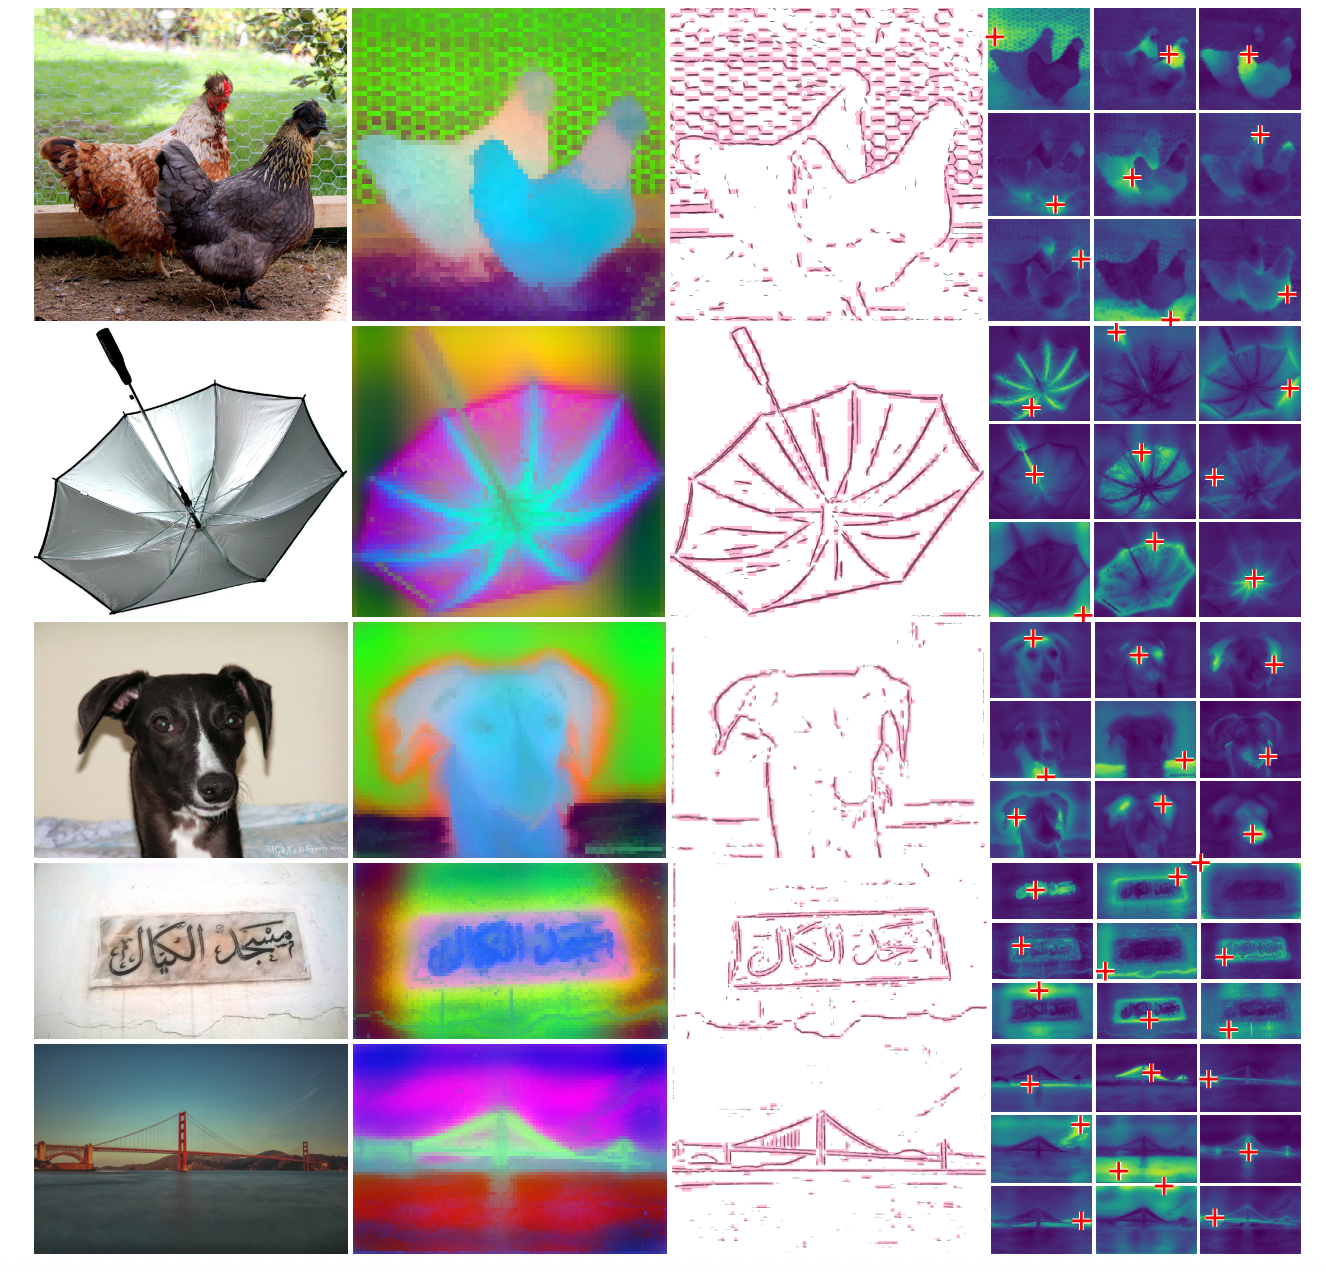
ภาพ: boundary-centric masked modeling — ตัวเข้ารหัสเรียนรู้ขอบเขต/โครงสร้างเชิงพื้นที่ของวัตถุ (ที่มา: GitHub ทางการ)
ภาพนี้แสดง "boundary-centric masked modeling" — แต่ละแถวคืออินพุต → projection ของ feature → ขอบเขตที่โมเดลค้นพบ → แผนที่ความคล้ายคลึงจากคำถามบนขอบเขต จะเห็นว่ามันจับทั้ง "การจัดกลุ่มความหมาย" และ "โครงสร้างเรขาคณิต" ได้พร้อมกัน
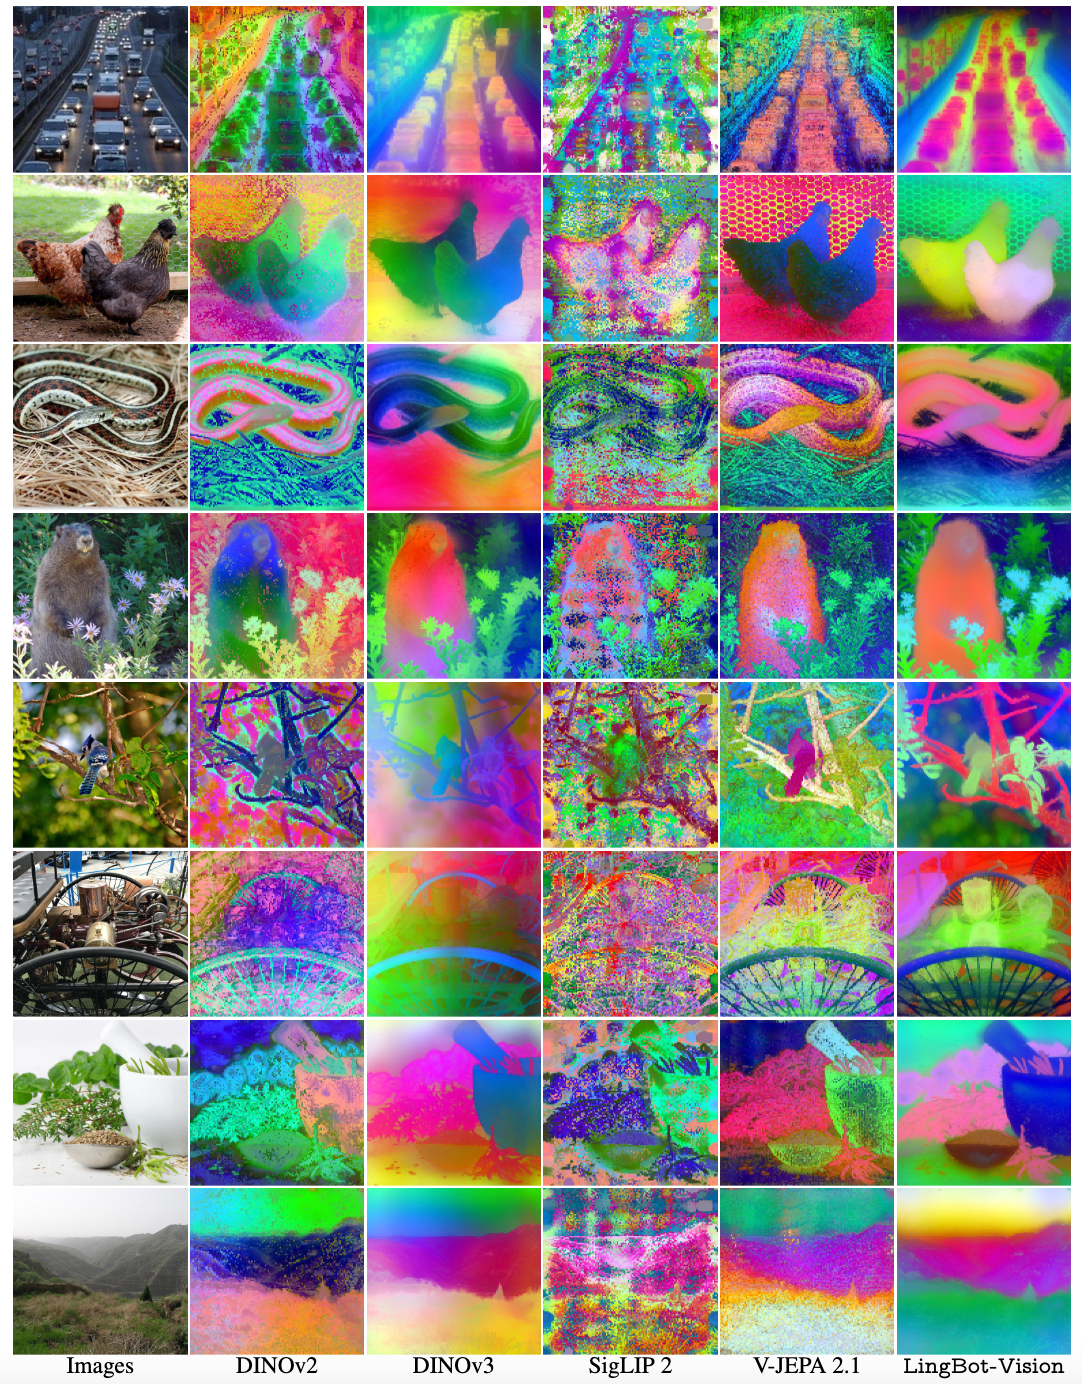
ภาพ: PCA map ของ patch tokens เผยความคมชัดในการแบ่งเขตวัตถุ (ที่มา: GitHub ทางการ)
และนี่คือ PCA map ของ frozen patch tokens ที่เผยให้เห็นว่า feature ของโมเดล "แบ่งเขต" วัตถุได้คมชัดแค่ไหน แม้ไม่ได้ผ่านการฝึกแบบเฉพาะทาง — จุดนี้เองที่ทำให้มันเป็นตัวเลือกที่ดีสำหรับงาน vision ต่อเนื่องอื่น ๆ ต่อจาก depth
ที่ต้องเล่ายาวเพราะมันคือ "ตัวคุณค่า" ที่แท้จริง: แทนที่จะสร้างโมเดล depth ทิพย์แบบจับจด ทีมพัฒนาเลือกสร้าง backbone ที่ดีแล้วเอาไปต่อยอด ทำให้ตัวเดียวกันใช้ทำงานได้หลายอย่าง — depth estimation, semantic segmentation, video object segmentation, และ depth completion
เปิดซอร์ส แบบที่ใครก็เอาไปใช้
LingBot-Vision เปิด Apache-2.0 พร้อมน้ำหนัก 4 ขนาดให้เลือกตามกำลังเครื่อง:
- Giant — ViT-g/16 · 1.1B พารามิเตอร์ · embed 1536 (คุณภาพสูงสุด)
- Large ⭐ — ViT-L/16 (กลั่นจาก Giant) · embed 1024 (แนะนำ: แรงพอ + ใช้ได้จริง)
- Base — ViT-B/16 · embed 768 (สมดุล)
- Small — ViT-S/16 · embed 384 (เบา ใช้สาธิต)
"Giant" เป็นตัวสอน (teacher) จำนวนราว 1.1B พารามิเตอร์ แล้วกลั่น (distill) ตัวเล็กลงมาสำหรับใช้งานจริง — ทุกตัวเปิดทั้งบน Hugging Face และ ModelScope
เทียบ Depth Anything V2 — ต่างกันตรงไหน
ถ้าคุณคุ้นกับ Depth Anything V2 (ที่ใช้โมเดล DINOv2 สไตล์判别) งานนี้ต่างอย่างชัดเจน:
- แนวทาง: LingBot ใช้ "backbone ฝึกแบบ boundary-centric + depth completion" ส่วน Depth Anything V2 ใช้โมเดล判别 (DINOv2) + สังเคราะห์ข้อมูล/ป้ายเทียม
- ข้อมูล: LingBot ใช้ 150M ภาพจริงแนวว้าง ๆ ส่วน DA2 ใช้ 59.5 万ภาพสังเคราะห์ + 62M ภาพป้ายเทียม
- จุดเด่น: LingBot เก่งกับ "ของโปร่งใส/สะท้อนแสง + ขอบละเอียด + ฉากหุ่นยนต์" ส่วน DA2 เก่งเรื่อง "depth ต่อตาเดียว + เร็ว + บางเบา"
- เปิดซอร์ส: LingBot-Vision เปิดทั้ง 4 ขนาด Apache-2.0 ส่วน DA2 เปิด S ตัวเดียว (Apache-2.0) ตัวใหญ่เป็น CC-BY-NC
- ลงสนามจริง: LingBot ร่วมมือกับ Orbbec 中光 ทำ SDK + กล้องรวม ส่วน DA2 เน้นงานวิจัย/ใช้งานทั่วไป
แล้วใช้ทำอะไรได้บ้าง
จุดที่ "ของโปร่งใส/สะท้อนแสง" เป็นปัญหา คือจุดที่โมเดลนี้แสดงคุณค่า:
- หุ่นยนต์บริการบ้าน: ห้องครัว/ห้องน้ำมีกระจก สะท้อนแสง ต้องนำทางและหยิบจับแม่น
- ตรวจงานอุตสาหกรรม: วัดขนาด 3 มิติของชิ้นส่วนโปร่งใส/โลหะสะท้อนแสง + ตรวจหาข้อบกพร่อง
- คลังสินค้า/โลจิสติกส์: จำแนกขอบสินค้าและชิ้นเล็กในแสงซับซ้อน ช่วยแขนกลหยิบจับ
- รถยนต์ไร้คนขับ: เติมความลึกของถนน + รับรู้สิ่งกีดขวางโปร่งใส (เช่น กระจกกันเสียง)
- อุปกรณ์เก็บข้อมูล: รวมกับกล้อง RGB-D อย่าง Orbbec EGO เป็นต้น
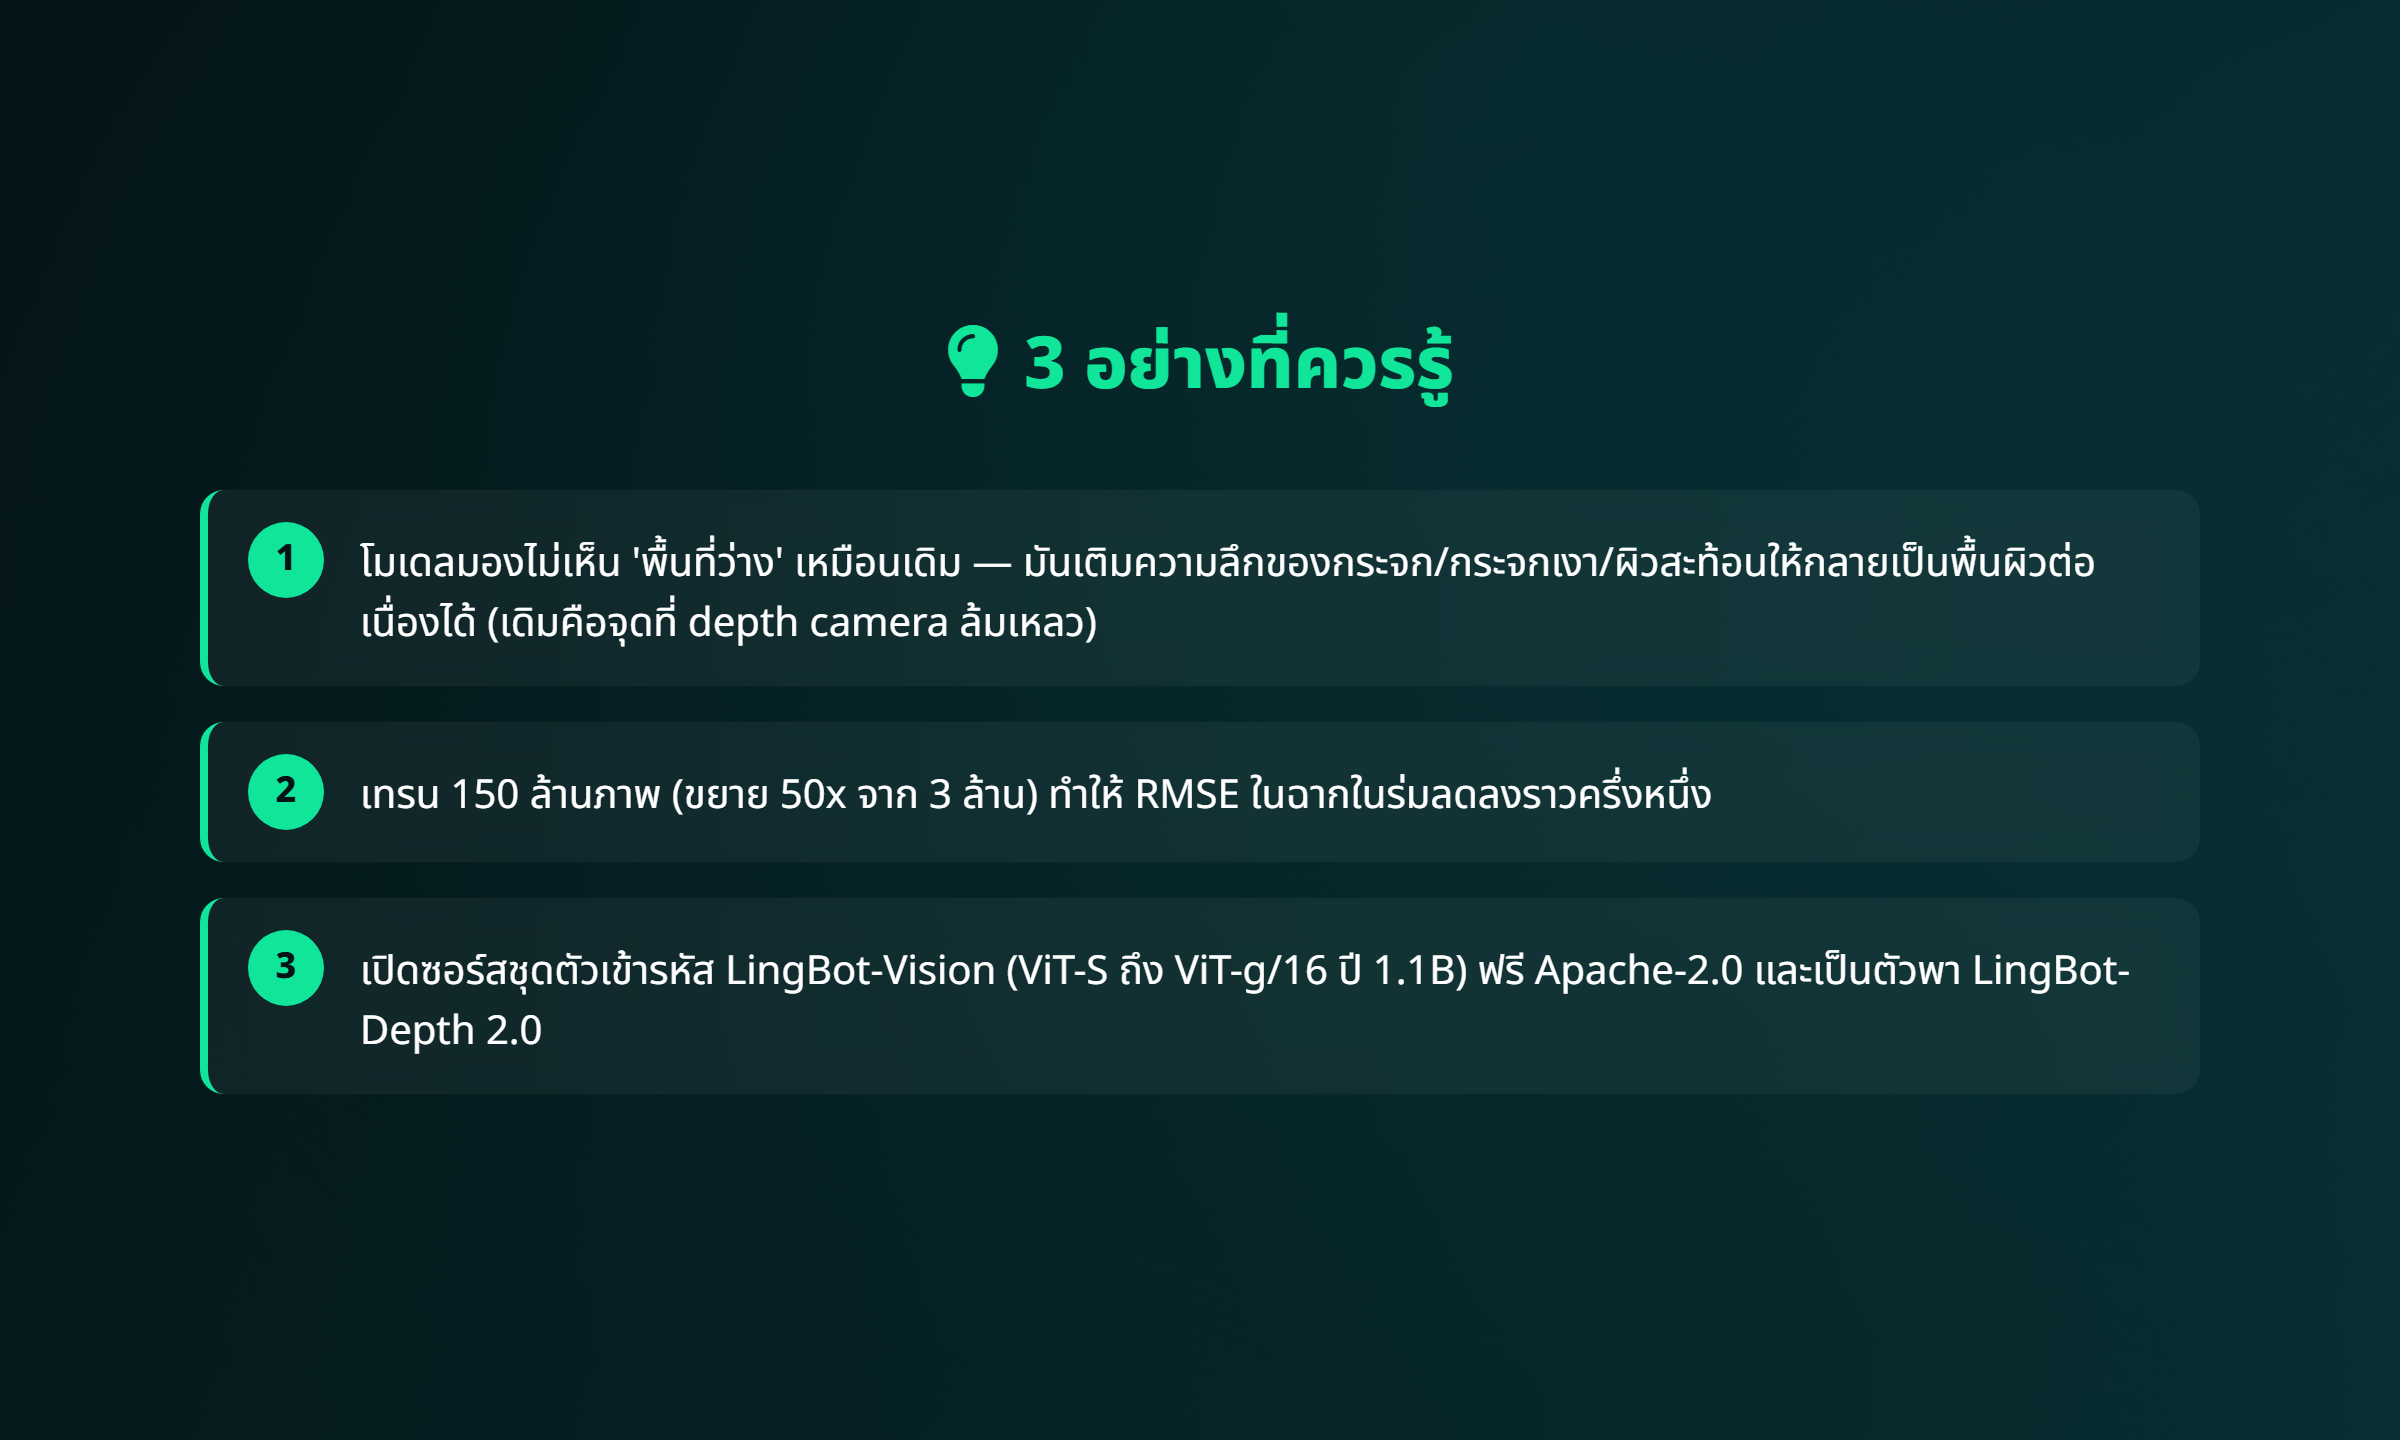
ภาพ: 3 สิ่งที่ควรรู้เกี่ยวกับ LingBot-Depth 2.0
สรุป 3 อย่างที่ควรจำ
- โมเดลนี้ "เห็น" สิ่งที่กล้อง depth ปกติมองไม่เห็น — กระจก/กระจกเงา/พื้นสะท้อนแสงไม่ใช่ "หลุมดำ" อีกต่อไป
- เคล็ดลับคือ backbone ที่ดี ไม่ใช่โมเดลจับจด — ฝึก LingBot-Vision ด้วย boundary-centric masking แล้วเอาไปต่อยอดงานอื่นได้หลายทาง
- เปิดซอร์ส จริงจัง — 4 ขนาด ViT ฟรี Apache-2.0 บน Hugging Face + ModelScope ใครก็ต่อยอดได้
ผมว่าข่าวแบบนี้คือ "ข่าวเทคนิคที่น่าเอ็นจอย" ที่ไม่หวือหวาแต่เปลี่ยนเกม — มันทำให้หุ่นยนต์เข้าใกล้ "มองเห็นโลก 3 มิติแบบคน" มากขึ้นอีกก้าว และการที่มันเปิดซอร์สแบบนี้ ยิ่งทำให้คนตัวเล็ก ๆ ต่อยอดได้ด้วย
ที่มา: AI-toolset — LingBot-Depth 2.0 (蚂蚁灵波科技) และ GitHub repository ทางการ
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!