
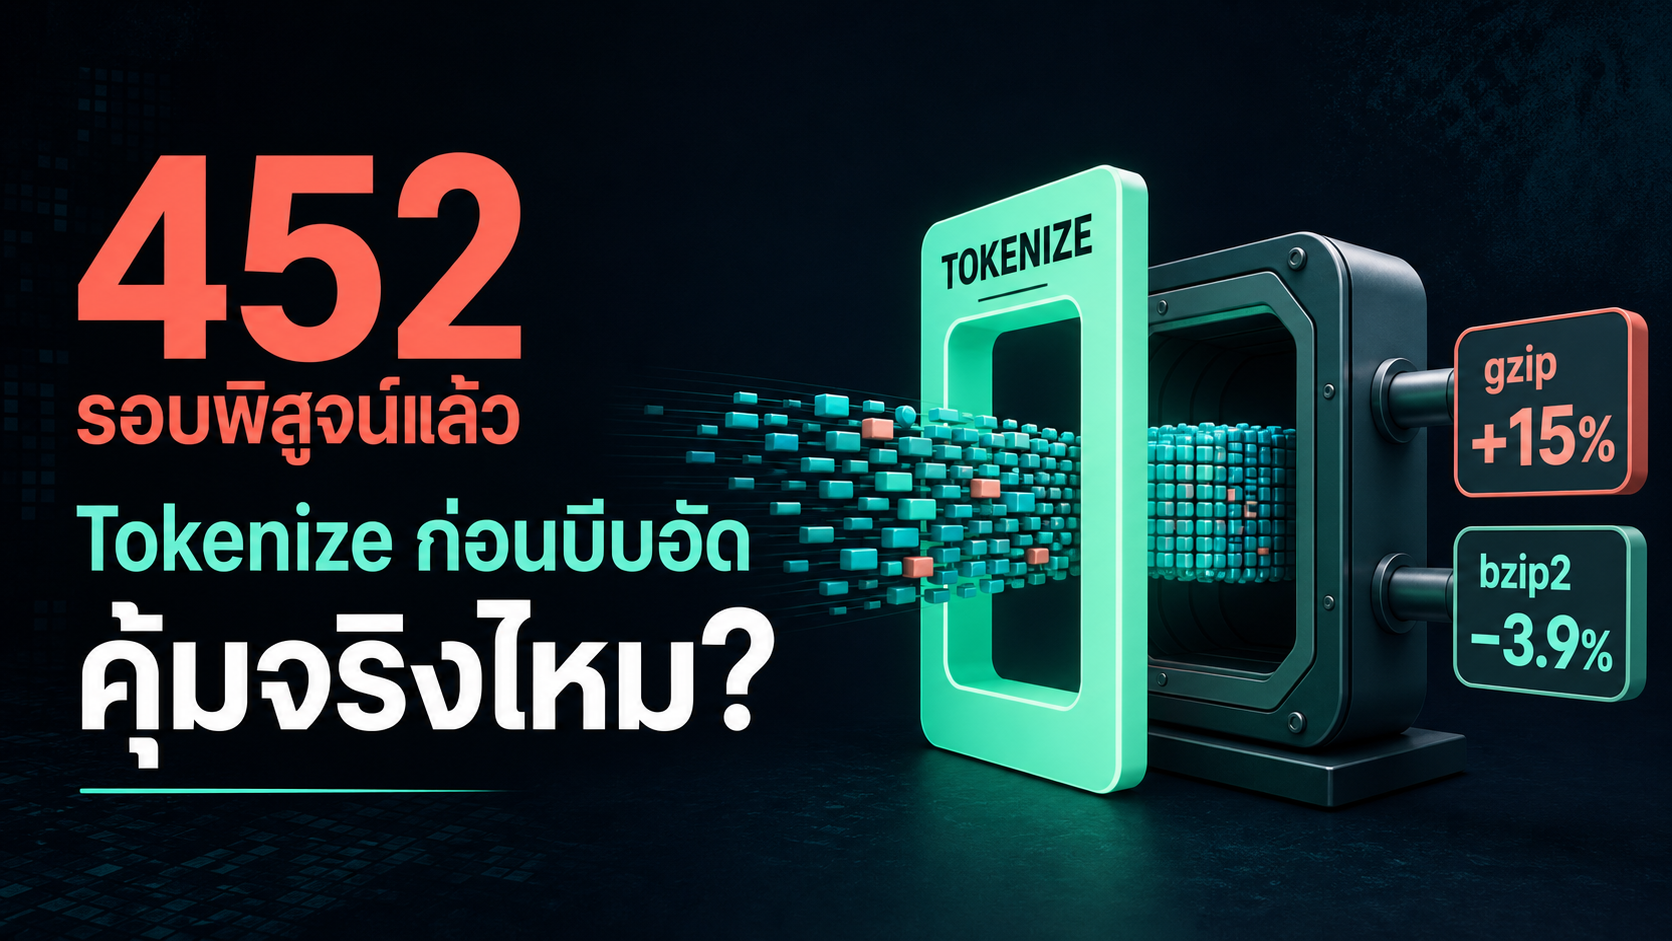
ถ้าข้อความต้องถูกบีบอัดอยู่แล้ว เราควรแปลงมันเป็น token แบบที่โมเดลภาษาใช้ก่อนหรือไม่? ฟังดูเหมือนเทคนิคเล็ก ๆ แต่คำตอบมีผลกับคลังข้อมูลข้อความขนาดใหญ่ ตั้งแต่ชุดข้อมูลฝึก AI ไปจนถึง archive ที่เก็บเป็นปี ๆ เพราะทุกเปอร์เซ็นต์ที่ลดได้หมายถึงพื้นที่และค่าใช้จ่ายที่หายไปจริง
บทความนี้พาไปดู parmar โปรเจกต์ทดลองที่ไม่ตอบด้วยความรู้สึก: เขารันชุดการตั้งค่า 452 แบบ กับข้อความจาก PG-19 ตั้งแต่ 64 MB ถึง 4 GB แล้วบีบอัด คลายกลับ และตรวจ hash ทุกครั้ง คำตอบคือ pre-tokenization ช่วยได้บ่อยครั้ง แต่ไม่ใช่คาถาที่ใช้ได้กับทุก compressor
เริ่มจากภาพง่าย ๆ: เรากำลังทำอะไรกับข้อความ?
ข้อความปกติบนดิสก์อยู่ในรูป byte ของ UTF-8 ส่วน tokenizer จะตัดข้อความเป็นหน่วยที่พบบ่อย เช่น คำ รากคำ หรือช่องว่าง แล้วแทนแต่ละหน่วยด้วยรหัสตัวเลข การแทนแบบนี้ไม่ได้ทำให้ “ความหมาย” หายไป—หากมี tokenizer หรือ encoding เดิมก็แปลงกลับเป็นข้อความเดิมได้ครบ
ลองนึกถึงประโยคภาษาอังกฤษที่มีคำซ้ำ ๆ: UTF-8 ต้องเก็บตัวอักษรทุกตัว แต่ tokenizer อาจแทนกลุ่มตัวอักษรที่พบประจำด้วยรหัสสั้นกว่า เมื่อสตรีมก่อนเข้าตัวบีบอัดสั้นลง ตัวบีบอัดที่มีหน้าต่างค้นหาลวดลายขนาดจำกัดก็เหมือนได้มองเนื้อหาต้นฉบับไกลขึ้น โดยไม่ต้องขยายหน้าต่างของมันเอง
ประโยชน์ไม่ได้มาจาก “token วิเศษ” แต่มาจากหน้าต่างที่คุ้มขึ้น
นี่คือจุดที่ทำให้แนวคิดนี้น่าสนใจมากกว่าคำโฆษณาเรื่อง AI ตัว compressor อย่าง gzip, zstd หรือ LZMA ล้วนค้นหาช่วงข้อมูลซ้ำภายในหน้าต่าง (window/dictionary) ของตัวเอง หาก token stream เล็กกว่า UTF-8 ราว 45% สำหรับภาษาอังกฤษ หน้าต่างขนาดเดิมจึงครอบคลุมข้อความต้นฉบับได้มากขึ้น
แต่ข้อสรุปนี้มีเงื่อนไขสำคัญ: ถ้าไฟล์เล็กจนทุกอย่างยังพอดีในหน้าต่างอยู่แล้ว การย่อ representation ก่อนแทบไม่ได้เปิดข้อมูลใหม่ให้ค้นหา ผลดีจึงปรากฏเด่นขึ้นเมื่อ dataset เริ่มใหญ่กว่าหน้าต่างนั้น และอาจค่อย ๆ แบนลงอีกครั้งเมื่อโตเกินขอบเขตที่ประโยชน์เพิ่มได้
452 การตั้งค่า เขาวัดอะไรบ้าง?
ผู้เขียนไม่ได้ลองเพียง gzip สองสามครั้ง แต่เปลี่ยนหลายมิติพร้อมกัน: tokenizer, รูปแบบการ pack token, backend สำหรับบีบอัด, ขนาดข้อมูล, ขนาด chunk และจำนวน thread โดยใช้ PG-19 ซึ่งมีเอกสารราว 10,600 ชิ้นเป็น corpus หลัก
ที่สำคัญ ทุกผลต้องผ่านการเดินทางไป-กลับ: บีบอัดแล้วคลายกลับจริง ตรวจ SHA-256 ที่ footer และนับเฉพาะงานที่คืนข้อมูลได้ครบ ผลคือ 452 round trips ผ่านทั้งหมด ไม่มี failure นี่ไม่ได้แปลว่า archive ปลอดภัยจากทุกความเสี่ยง แต่แปลว่าตัวเลข compression ratio ในรายงานไม่ปนกับข้อมูลที่คลายกลับไม่ได้
ผลที่ชัดที่สุด: gzip ได้กำไรสม่ำเสมอ
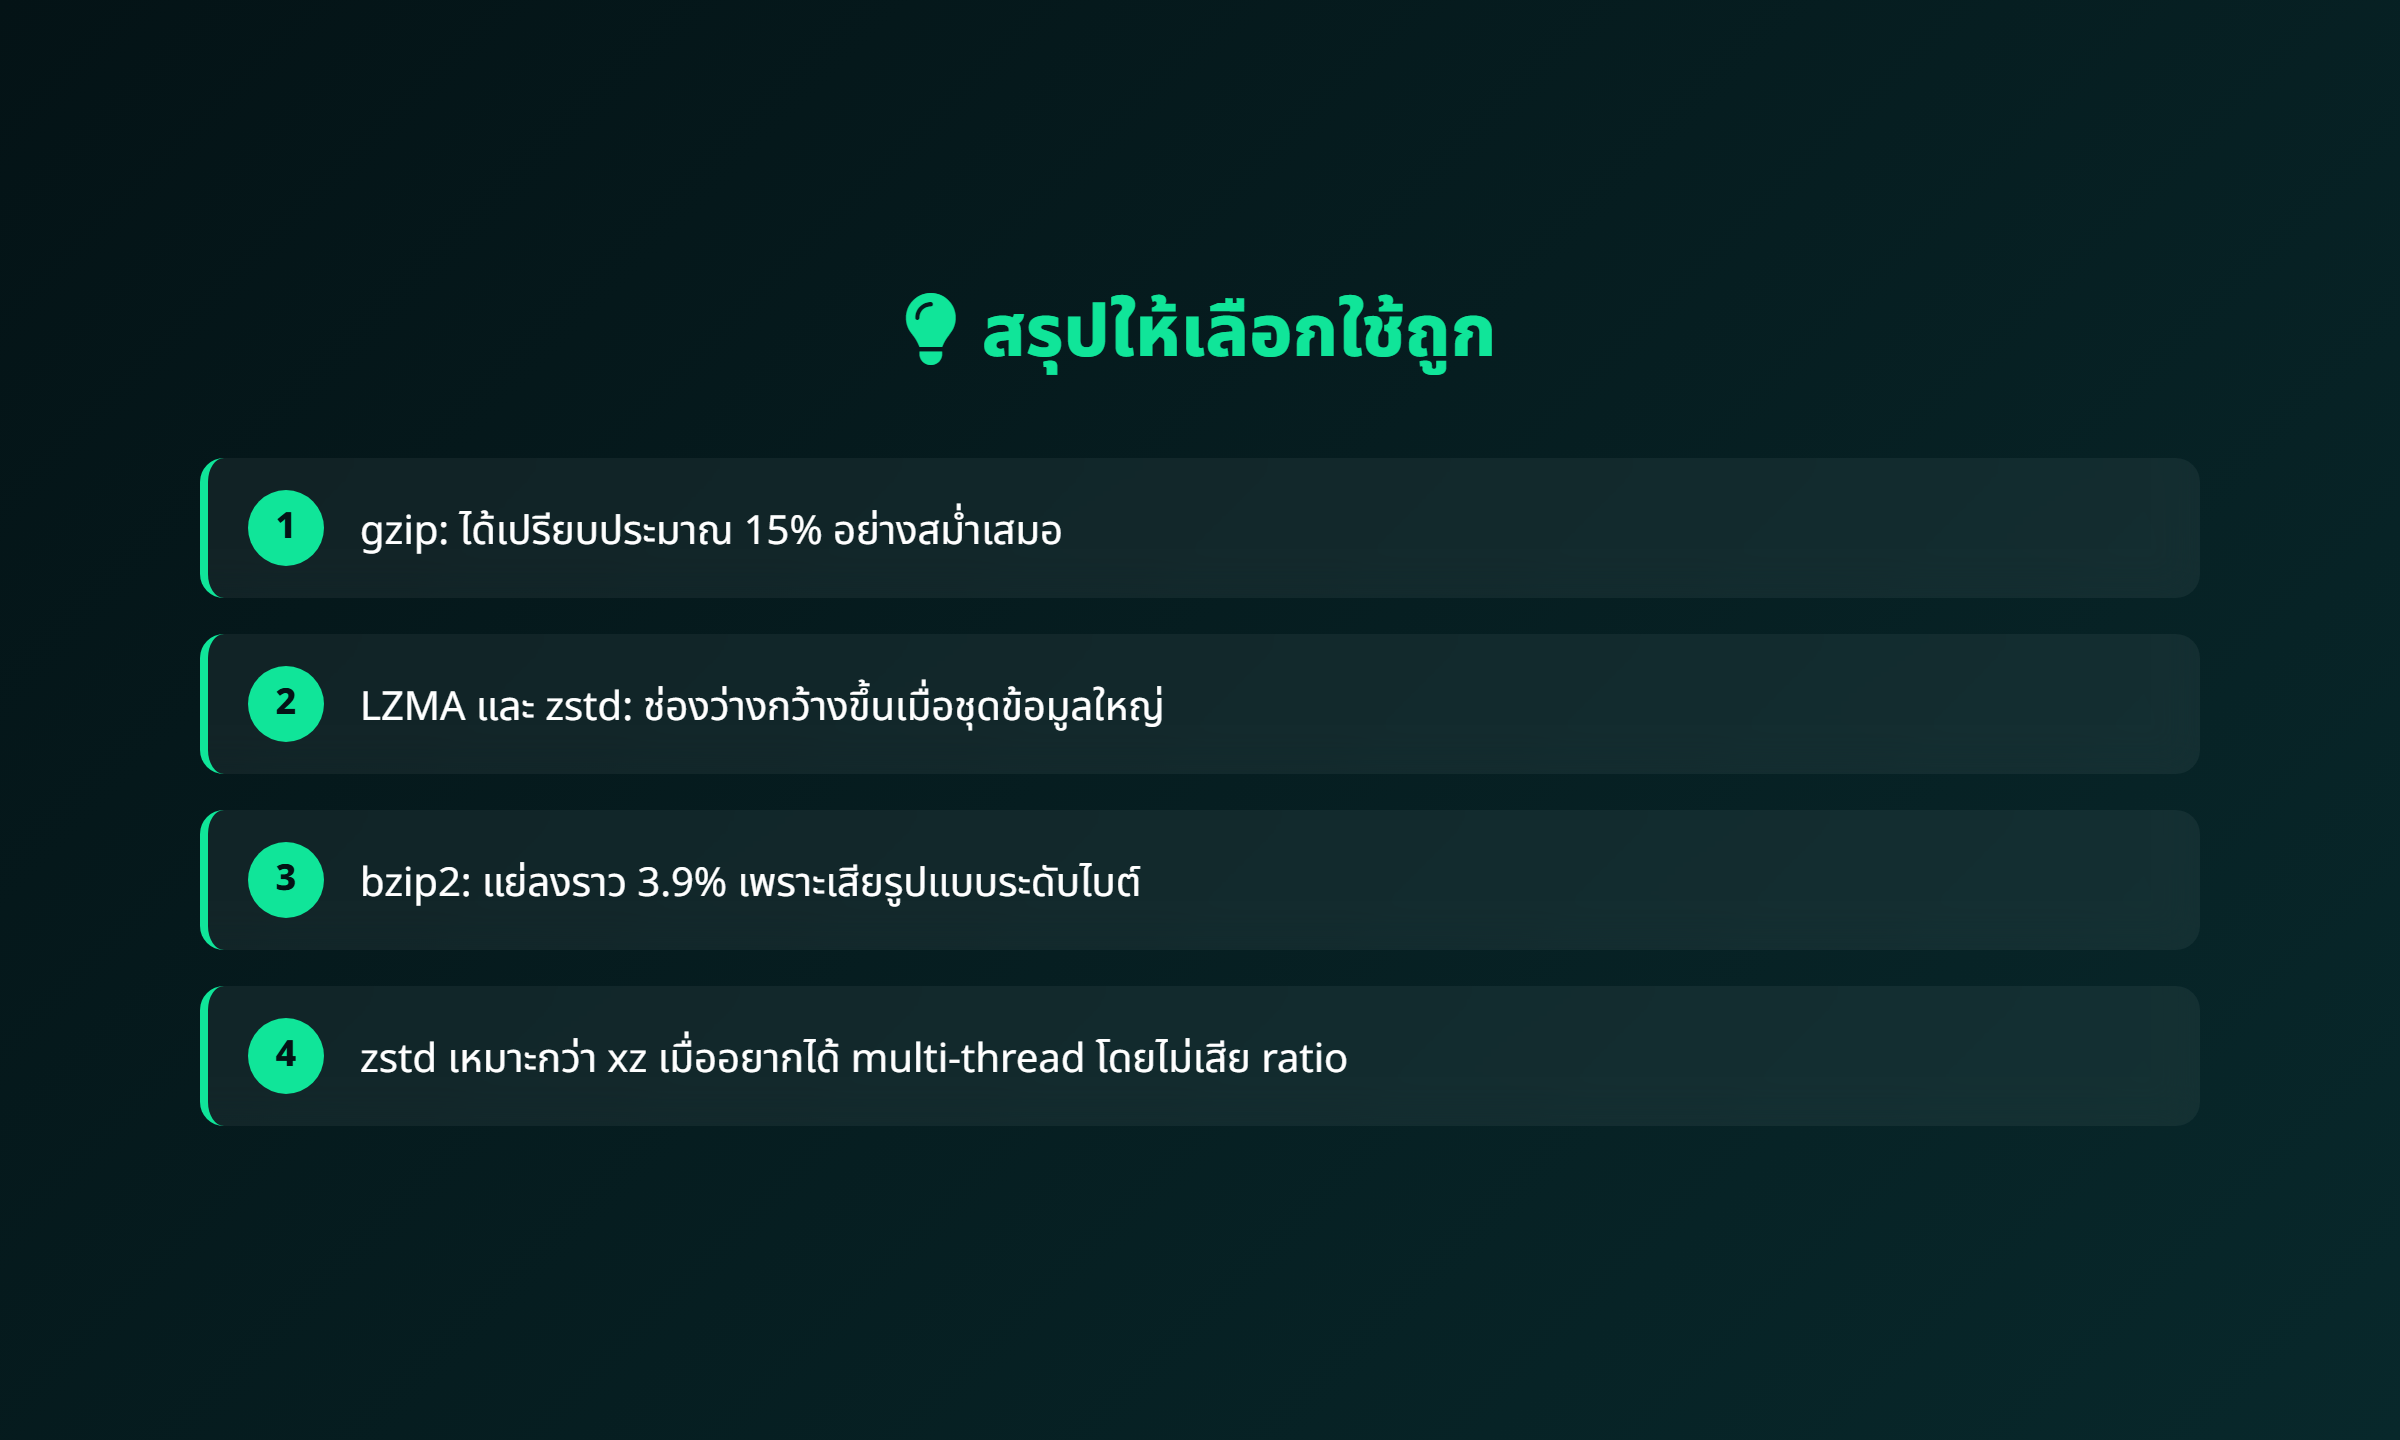
gzip เป็นกรณีที่เข้าใจง่ายที่สุด เพราะหน้าต่างของมันค่อนข้างเล็กและอิ่มตัวเร็ว เมื่อสตรีมถูก tokenize ก่อน ผลที่รายงานคือขนาดไฟล์ดีขึ้นประมาณ 15% อย่างค่อนข้างคงที่ตั้งแต่ 64 MB จนถึง 4 GB นั่นคือชุดข้อมูลใหญ่ขึ้นมาก แต่ข้อจำกัดของหน้าต่าง gzip ยังเหมือนเดิม และ representation ที่หนาแน่นช่วยมันต่อเนื่อง
สำหรับ LZMA และ zstd ภาพไม่เหมือนกันทั้งหมด เพราะทั้งคู่ปรับหน้าต่างได้ใหญ่กว่า ผลดีมีแนวโน้มเพิ่มตามขนาดข้อมูลในช่วงแรก ก่อนเข้าใกล้ plateau เมื่อข้อมูลใหญ่จนข้อได้เปรียบจากหน้าต่างเริ่มถูกใช้เต็มแล้ว ส่วน zstd ที่ตั้งค่าเร็วมากอาจไม่ได้เร็วขึ้นเสมอ เพราะขั้นตอน tokenize เองกลายเป็นคอขวดได้
ข้อยกเว้นที่ต้องจำ: bzip2 กลับแย่ลง
ผลที่ทำให้การทดลองนี้มีค่าคือมันไม่ได้พยายามเล่าเรื่องให้สวยเพียงด้านเดียว bzip2 แพ้ประมาณ 3.9% แบบคงที่เมื่อ tokenize ก่อน ผู้เขียนอธิบายว่ากลไกของ bzip2 พึ่งพาโครงสร้างระดับ byte ของข้อความในแบบที่ pre-tokenization ทำให้เปลี่ยนไป
บทเรียนจึงไม่ใช่ “tokenize แล้วชนะ” แต่เป็น “representation กับอัลกอริทึมต้องเข้ากัน” หากกำลังเลือกเทคนิคเพื่อ production อย่าใช้ผลของ gzip เป็นใบอนุญาตให้เปิดกับทุก backend โดยไม่วัดจริง
ความเร็วก็มีเรื่องเล่า: ไฟล์เล็กลง อาจแบ่งงานได้น้อยลง
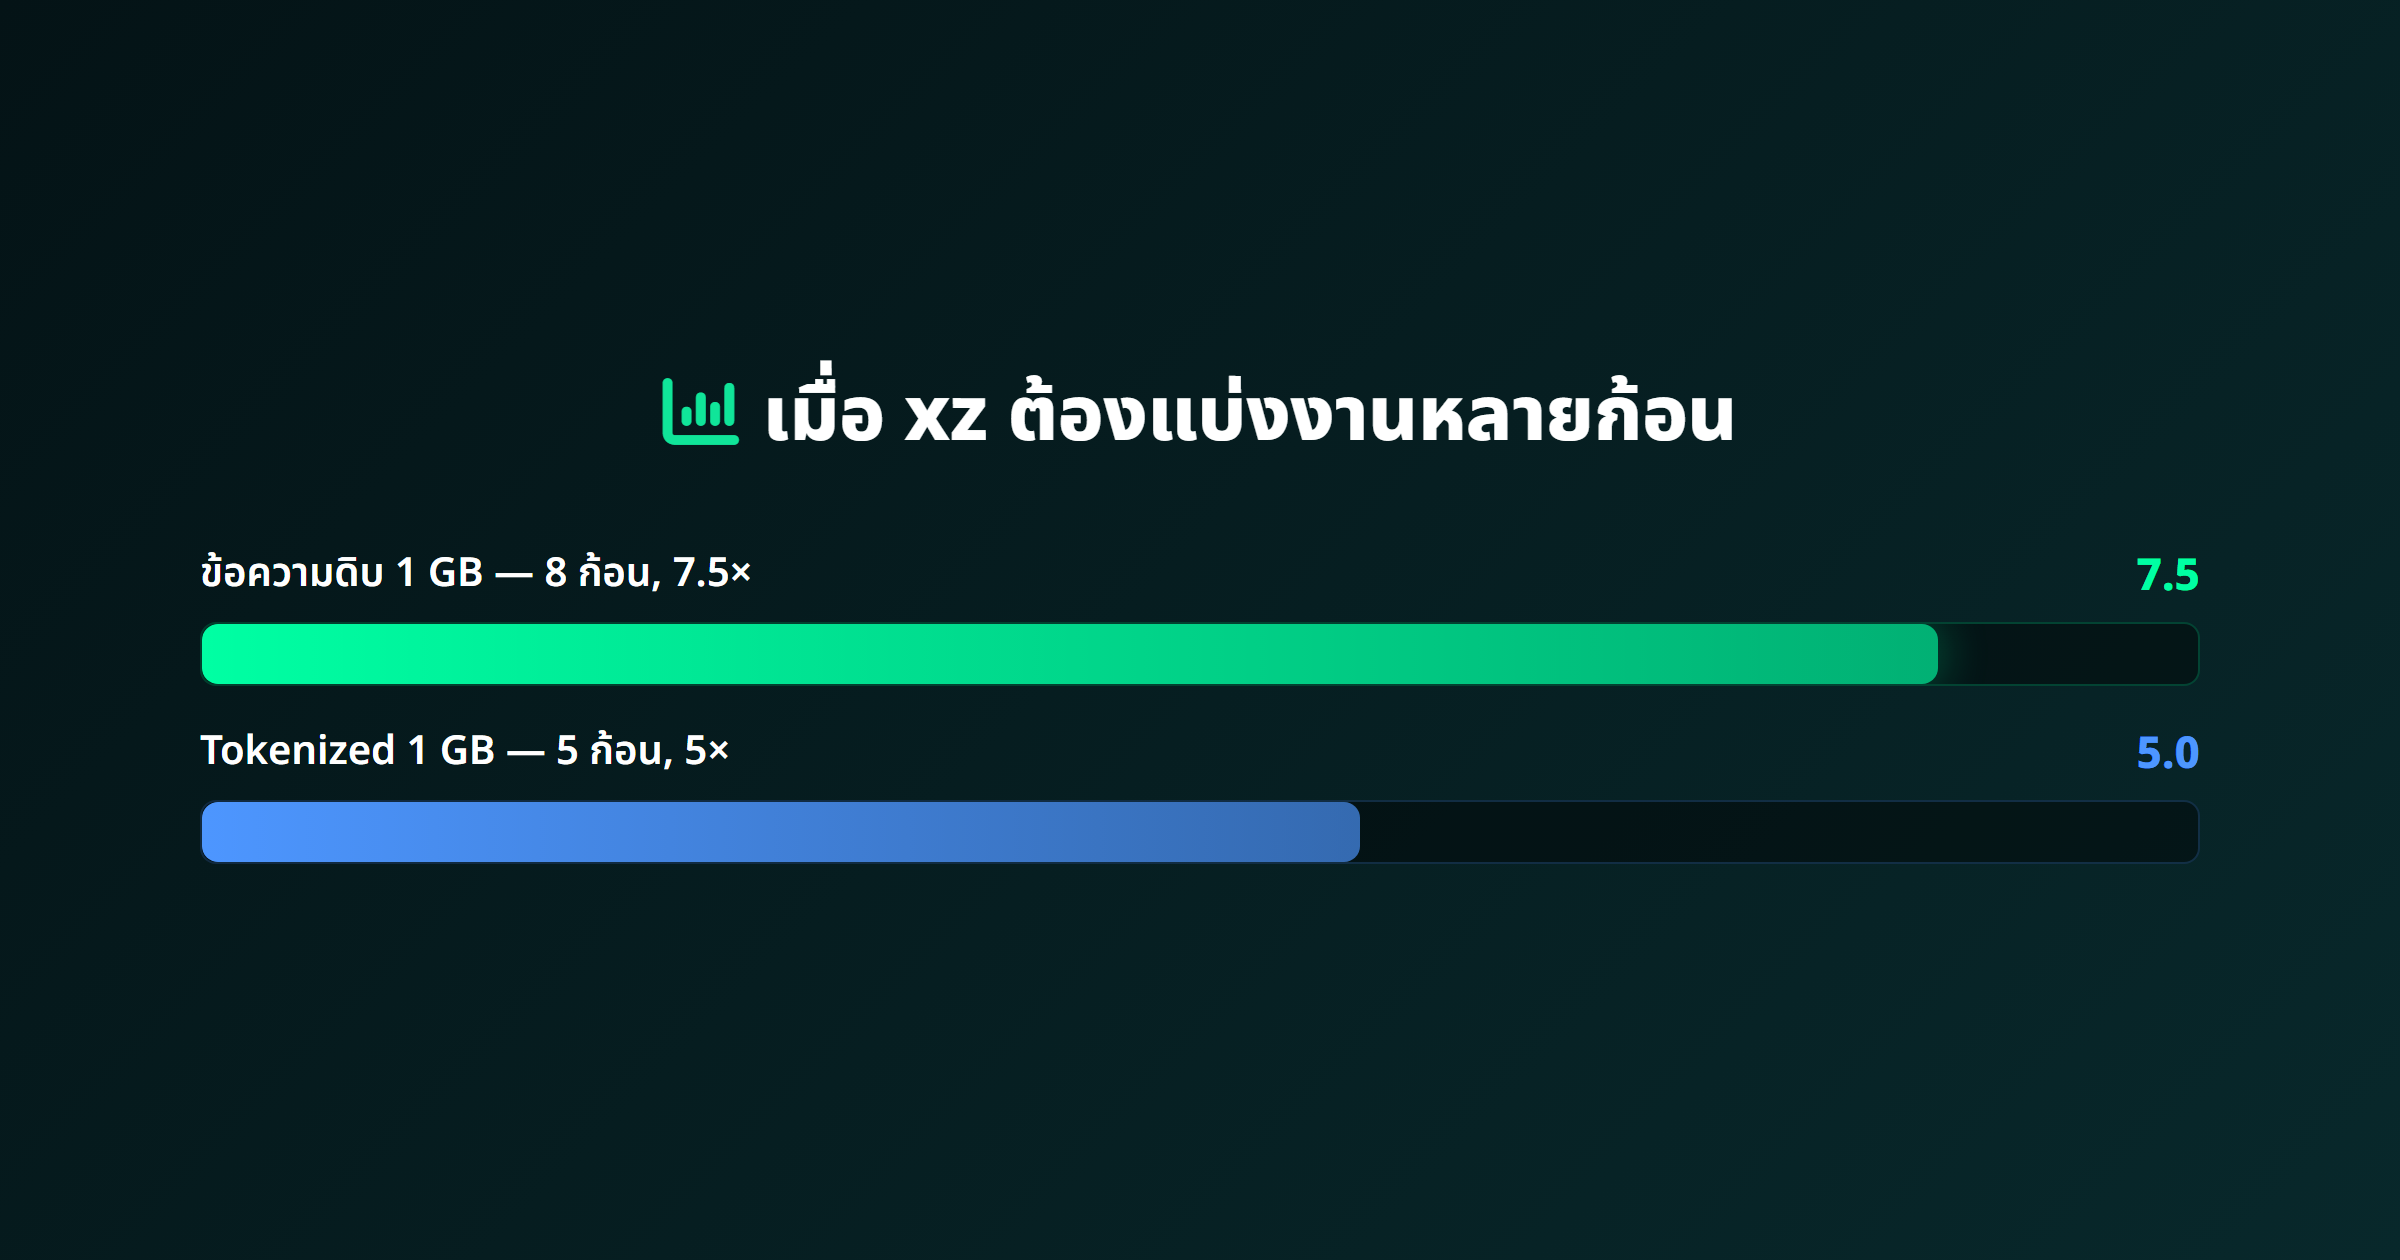
การใช้หลาย thread ไม่ได้เป็นโบนัสอัตโนมัติ ในตัวอย่าง xz ที่ข้อมูลดิบขนาด 1 GB ถูกแบ่งเป็น 8 ก้อนและได้สเกลความเร็ว 7.5× แต่กรณี tokenized ถูกแบ่งเป็น 5 ก้อนและได้ 5× เท่านั้น เหตุผลไม่ใช่วิธีนั้นผิด; เมื่อ representation สั้นลง งานทั้งหมดมีขนาดเล็กลงและตัวแบ่งงานอาจมีโอกาสแตกเป็นก้อนขนานน้อยลงด้วย
นี่เป็น trade-off ที่ดีต่อการจำ: ดูทั้ง size และ throughput พร้อมกัน โดยเฉพาะ pipeline ที่ต้องเขียนและอ่านข้อมูลบ่อย ๆ หรือใช้ CPU เต็มเครื่องอยู่แล้ว
เหมาะกับงานแบบไหน และงานแบบไหนยังไม่ควรเหมารวม?
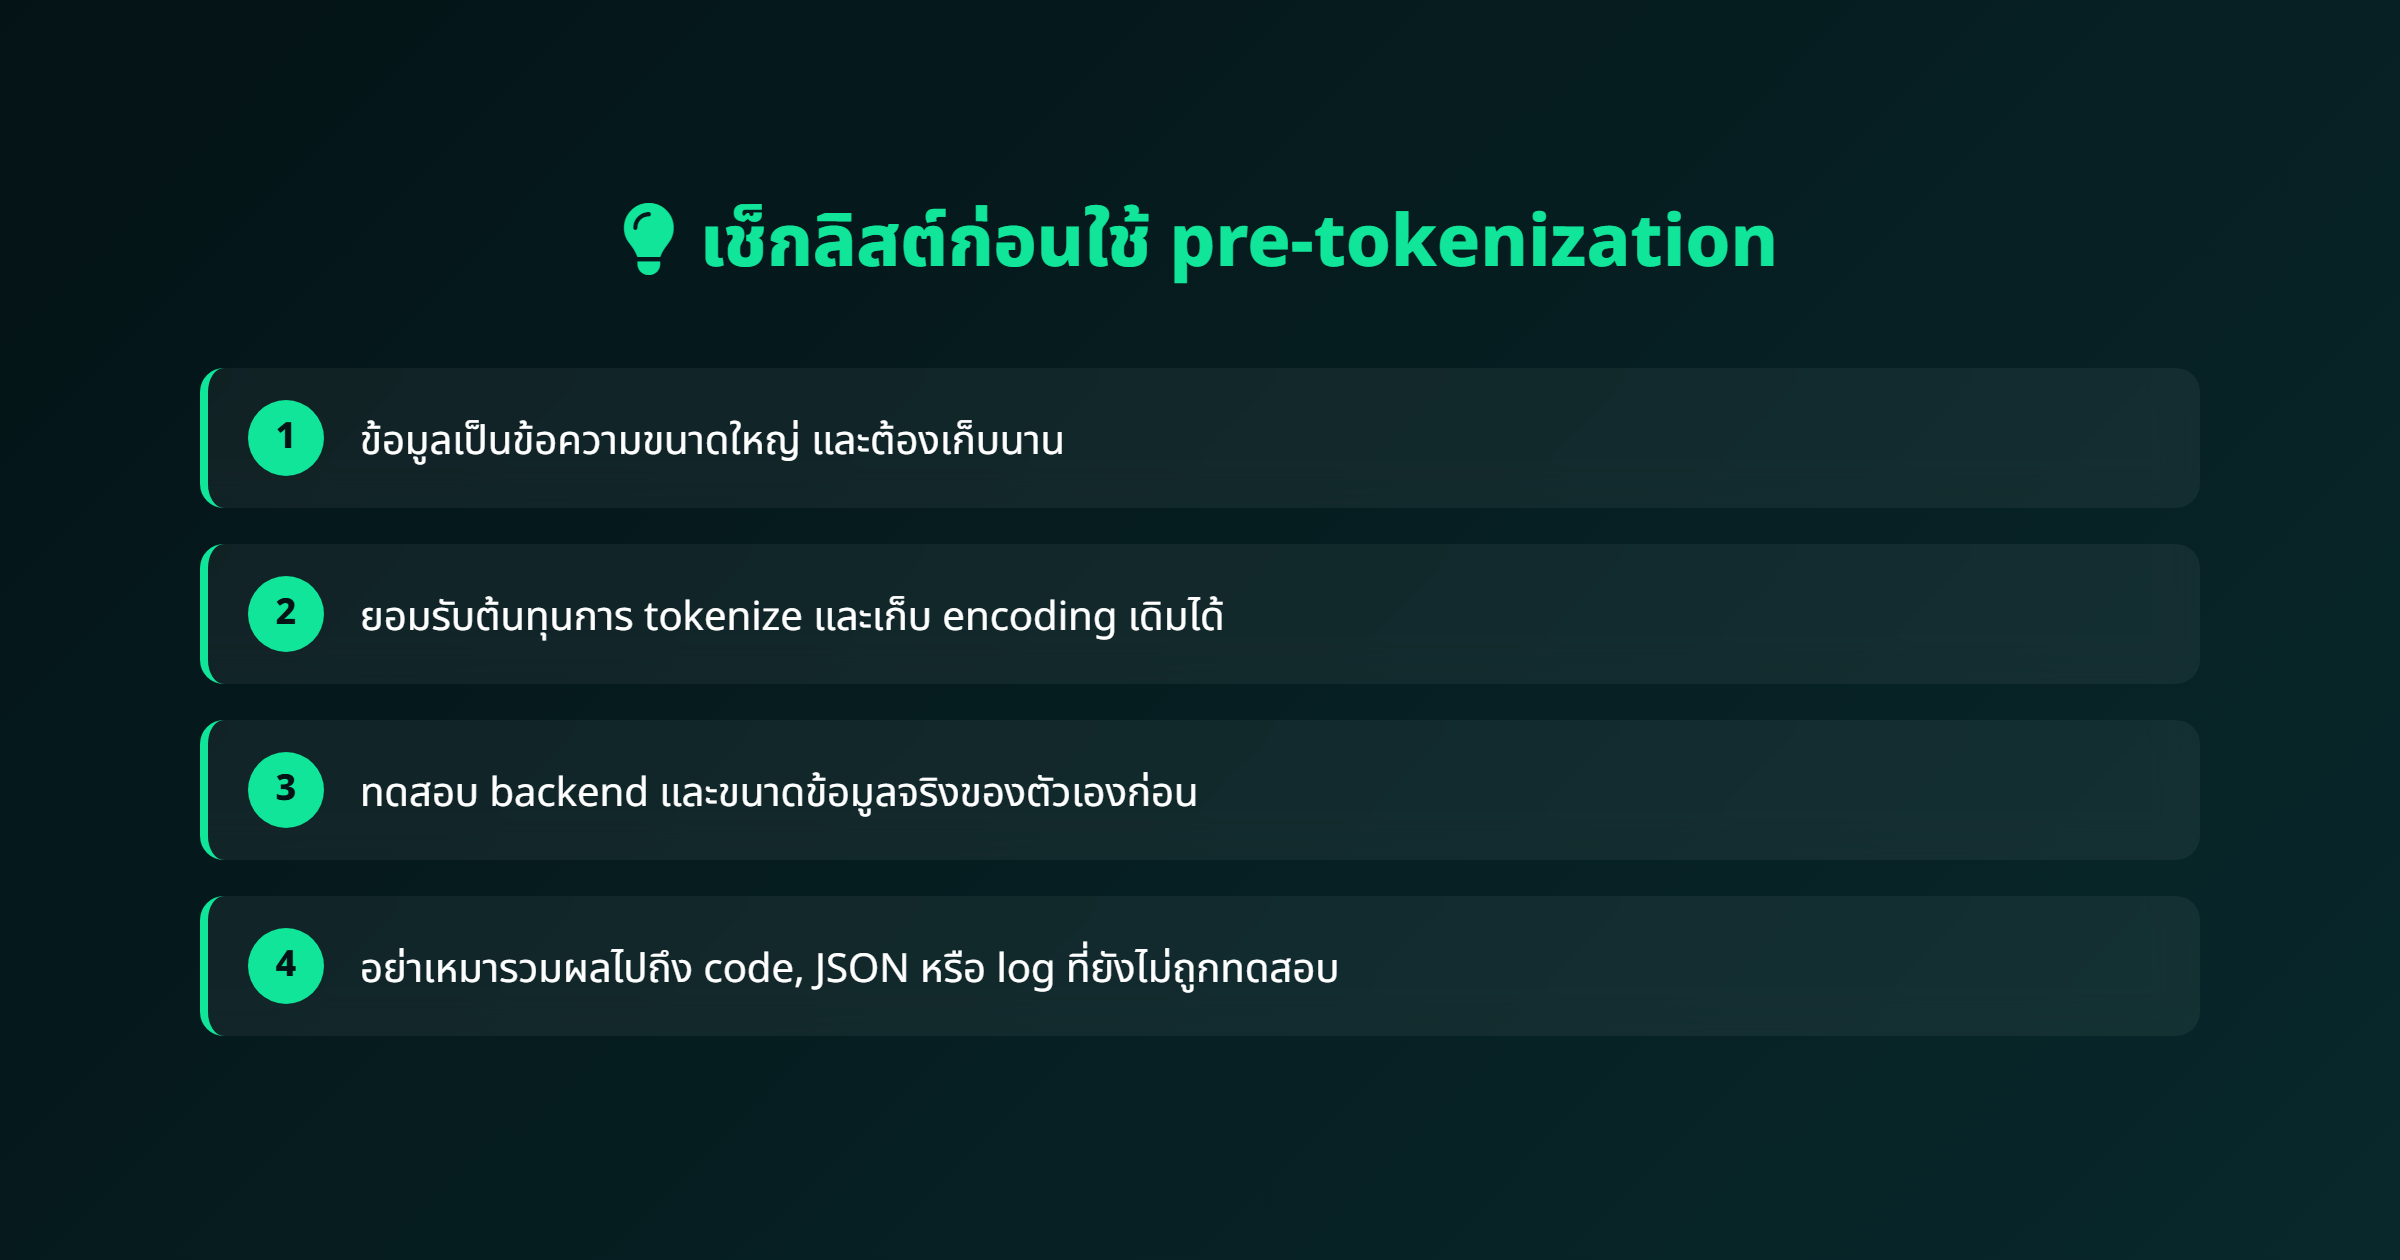
กรณีที่น่าลองที่สุดคือ archive ของข้อความภาษาอังกฤษขนาดใหญ่, corpus สำหรับงาน ML, evaluation set หรือข้อมูล retrieval ที่ระบบต้อง tokenize อยู่แล้ว หากข้อมูลเป็น cold storage—เขียนครั้งเดียวแล้วอ่านไม่บ่อย—ยิ่งมีเหตุผลให้แลกเวลาประมวลผลเพิ่มเพื่อไฟล์ที่เล็กลง
แต่ยังไม่ควรโยงผลนี้ไปถึง code, JSON, log หรือภาษาที่ tokenizer มีพฤติกรรมต่างออกไป เพราะการทดลองไม่ได้ครอบคลุมสิ่งเหล่านั้น และ archive บันทึกชื่อ tokenizer ไม่ได้ฝัง vocabulary ไว้ครบในตัวมันเอง: คนที่จะคลายไฟล์ต้องมี encoding เดิมด้วย นอกจากนี้ SHA-256 ใน workflow ใช้ตรวจความเสียหาย ไม่ใช่การเข้ารหัสหรือการยืนยันตัวตน
เก็บ “ตัวแทนข้อมูล” พร้อมข้อมูลเวอร์ชัน tokenizer ไว้เสมอ เพราะไฟล์ที่เล็กที่สุดไม่มีประโยชน์ หากทีมในอนาคตเปิดกลับไม่ได้
วิธีตัดสินใจแบบไม่หลงตัวเลข
- เลือกข้อมูลจริง ไม่ใช่ sample สั้น ๆ: ขนาดและรูปแบบภาษามีผลมาก
- วัดอย่างน้อยสองค่า: compression ratio และเวลารวมตั้งแต่ tokenize จนเขียนไฟล์
- ทดสอบการคลายกลับ และเก็บ version ของ tokenizer/encoding ไว้กับ archive
- เปรียบเทียบ backend ที่จะใช้จริง: gzip, zstd, LZMA และ bzip2 ให้คำตอบต่างกัน
- ตรวจต้นทุน operation: จำนวน thread, RAM, การติดตั้ง dependency และการกู้คืนหลายปีข้างหน้า
สรุป: การทดลองที่ดี ไม่ได้มีคำตอบเดียว
parmar ทำให้เห็นกลไกที่จับต้องได้: เมื่อ tokenization ทำให้ข้อความหนาแน่นขึ้น compressor ที่ถูกจำกัดด้วยหน้าต่างก็อาจเห็นลวดลายซ้ำได้ไกลขึ้น และ gzip ได้ผลประโยชน์ที่น่าสนใจราว 15% แต่ในเวลาเดียวกัน bzip2 ยืนยันว่าการทำลายโครงสร้างระดับ byte อาจทำให้ผลแย่ลง และการแบ่งงานหลาย thread ก็มีข้อแลกเปลี่ยนของมันเอง
ถ้าจะหยิบไปใช้จริง ประโยคที่ปลอดภัยที่สุดคือ: เริ่มจาก benchmark ของข้อมูลและ backend ของเราเอง แล้วค่อยให้ตัวเลขเป็นคนตัดสิน ไม่ใช่ความรู้สึกว่า token ฟังดูฉลาดกว่า byte
อ่านรายละเอียดการทดลองจาก บทความต้นทางบน DEV Community และตรวจ implementation ได้ที่ GitHub: shallowbyte/parmar
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!