
ถ้าติดตาม DeepSeek มาตลอด จะรู้ว่าข่าวนี้ใหญ่มาก — 21 ส.ค. 2026 DeepSeek เปิดตัว DeepSeek-V4-Flash-Vision-Exp โมเดล มองเห็นได้ ตัวแรกบน DeepSeek API นั่นแปลว่า V4-Flash ที่คนใช้ทำ Agent กันอยู่ ตอนนี้อ่านสกรีนช็อต กราฟ หน้าจอ และเอกสารได้แล้ว โดยที่ความเก่งด้านข้อความ ไม่ตกเลย
DeepSeek V4 Flash Vision Exp เปิดตัวครั้งแรก — โมเดลมองเห็นได้ตัวแรกบน DeepSeek API (vision-reader ยืนยันภาพตรงเรื่อง)
สรุปสั้นๆ แบบเพื่อนเล่า: เอา V4-Flash ตัวเดิมที่เร็วและถูก ไปติด "ตา" เพิ่มมาเป็น vision module แบบ modular เลยคงความเก่งเดิมไว้ครบ แล้วเพิ่มความสามารถดูรูปเข้าไป ผลคือ Multimodal Agent ที่เก่งใกล้ Opus 4.8 แต่ราคาถูกกว่าเป็นสิบเท่า
ภาพละ 384 tokens สูงสุด — ประหยัดกว่าคิด (1M context / 384K output)
มันคืออะไร เอาแบบเข้าใจง่าย
Vision ใหม่นี้ไม่ได้เทรนใหม่ทั้งตัว — DeepSeek ใช้วิธี ขยายแบบโมดูล เติม vision encoder + adapter ให้ภาพถูกแปลงเป็นชุด token แล้วไปต่อกับภาษาได้เลย ภาพหนึ่งใบใช้สูงสุด 384 tokens (ประหยัดมาก) และยังรองรับ 1M context / 384K output เหมือนเดิม เหมาะกับงาน Agent ที่ต้องโยนสกรีนช็อตหลายใบ + เอกสารยาวๆ เข้าไปพร้อมกัน
ที่ชอบมากคือความยืดหยุ่น:
- ส่งภาพได้ 3 ทาง: base64 แนบตรงๆ, URL ภายนอก, หรืออัปโหลดผ่าน Files API แล้วใช้
file_idเรียกซ้ำได้ไม่ต้องอัปโหลดใหม่ - Files API ฟรี: อัปโหลดภาพเอา file_id ไป reuse ได้หลายรอบ ประหยัดทั้งแบนด์วิดท์และค่า token
- 3 ฟอร์แมต API: Chat Completions / Messages / Responses ใช้แบบไหนก็ได้
- 2 โหมดคิด: Thinking Mode (คิดลึกก่อนตอบ) กับ Non-thinking Mode (ตอบเร็ว) สลับได้ตามงาน
- Harness 0.1.1: เฟรมเวิร์ก Agent ของ DeepSeek รองรับทันที ไม่ต้องแก้โค้ดเยอะ
Same Price, One Sees — เทียบ V4-Flash vs V4-Flash-Vision-Exp ราคาเท่าเดิมแต่เพิ่มตา (vision-reader ยืนยัน)
เก่งแค่ไหน? เทียบกับ Opus 4.8 ตรงๆ
DeepSeek เคลมว่า ข้อความล้วน เท่ากับ V4-Flash ทุกเบนช์มาร์ก ส่วน multimodal Agent นี่แหละที่กระโดด — ดูตัวเลข vendor เทียบ Opus 4.8 ได้เลย
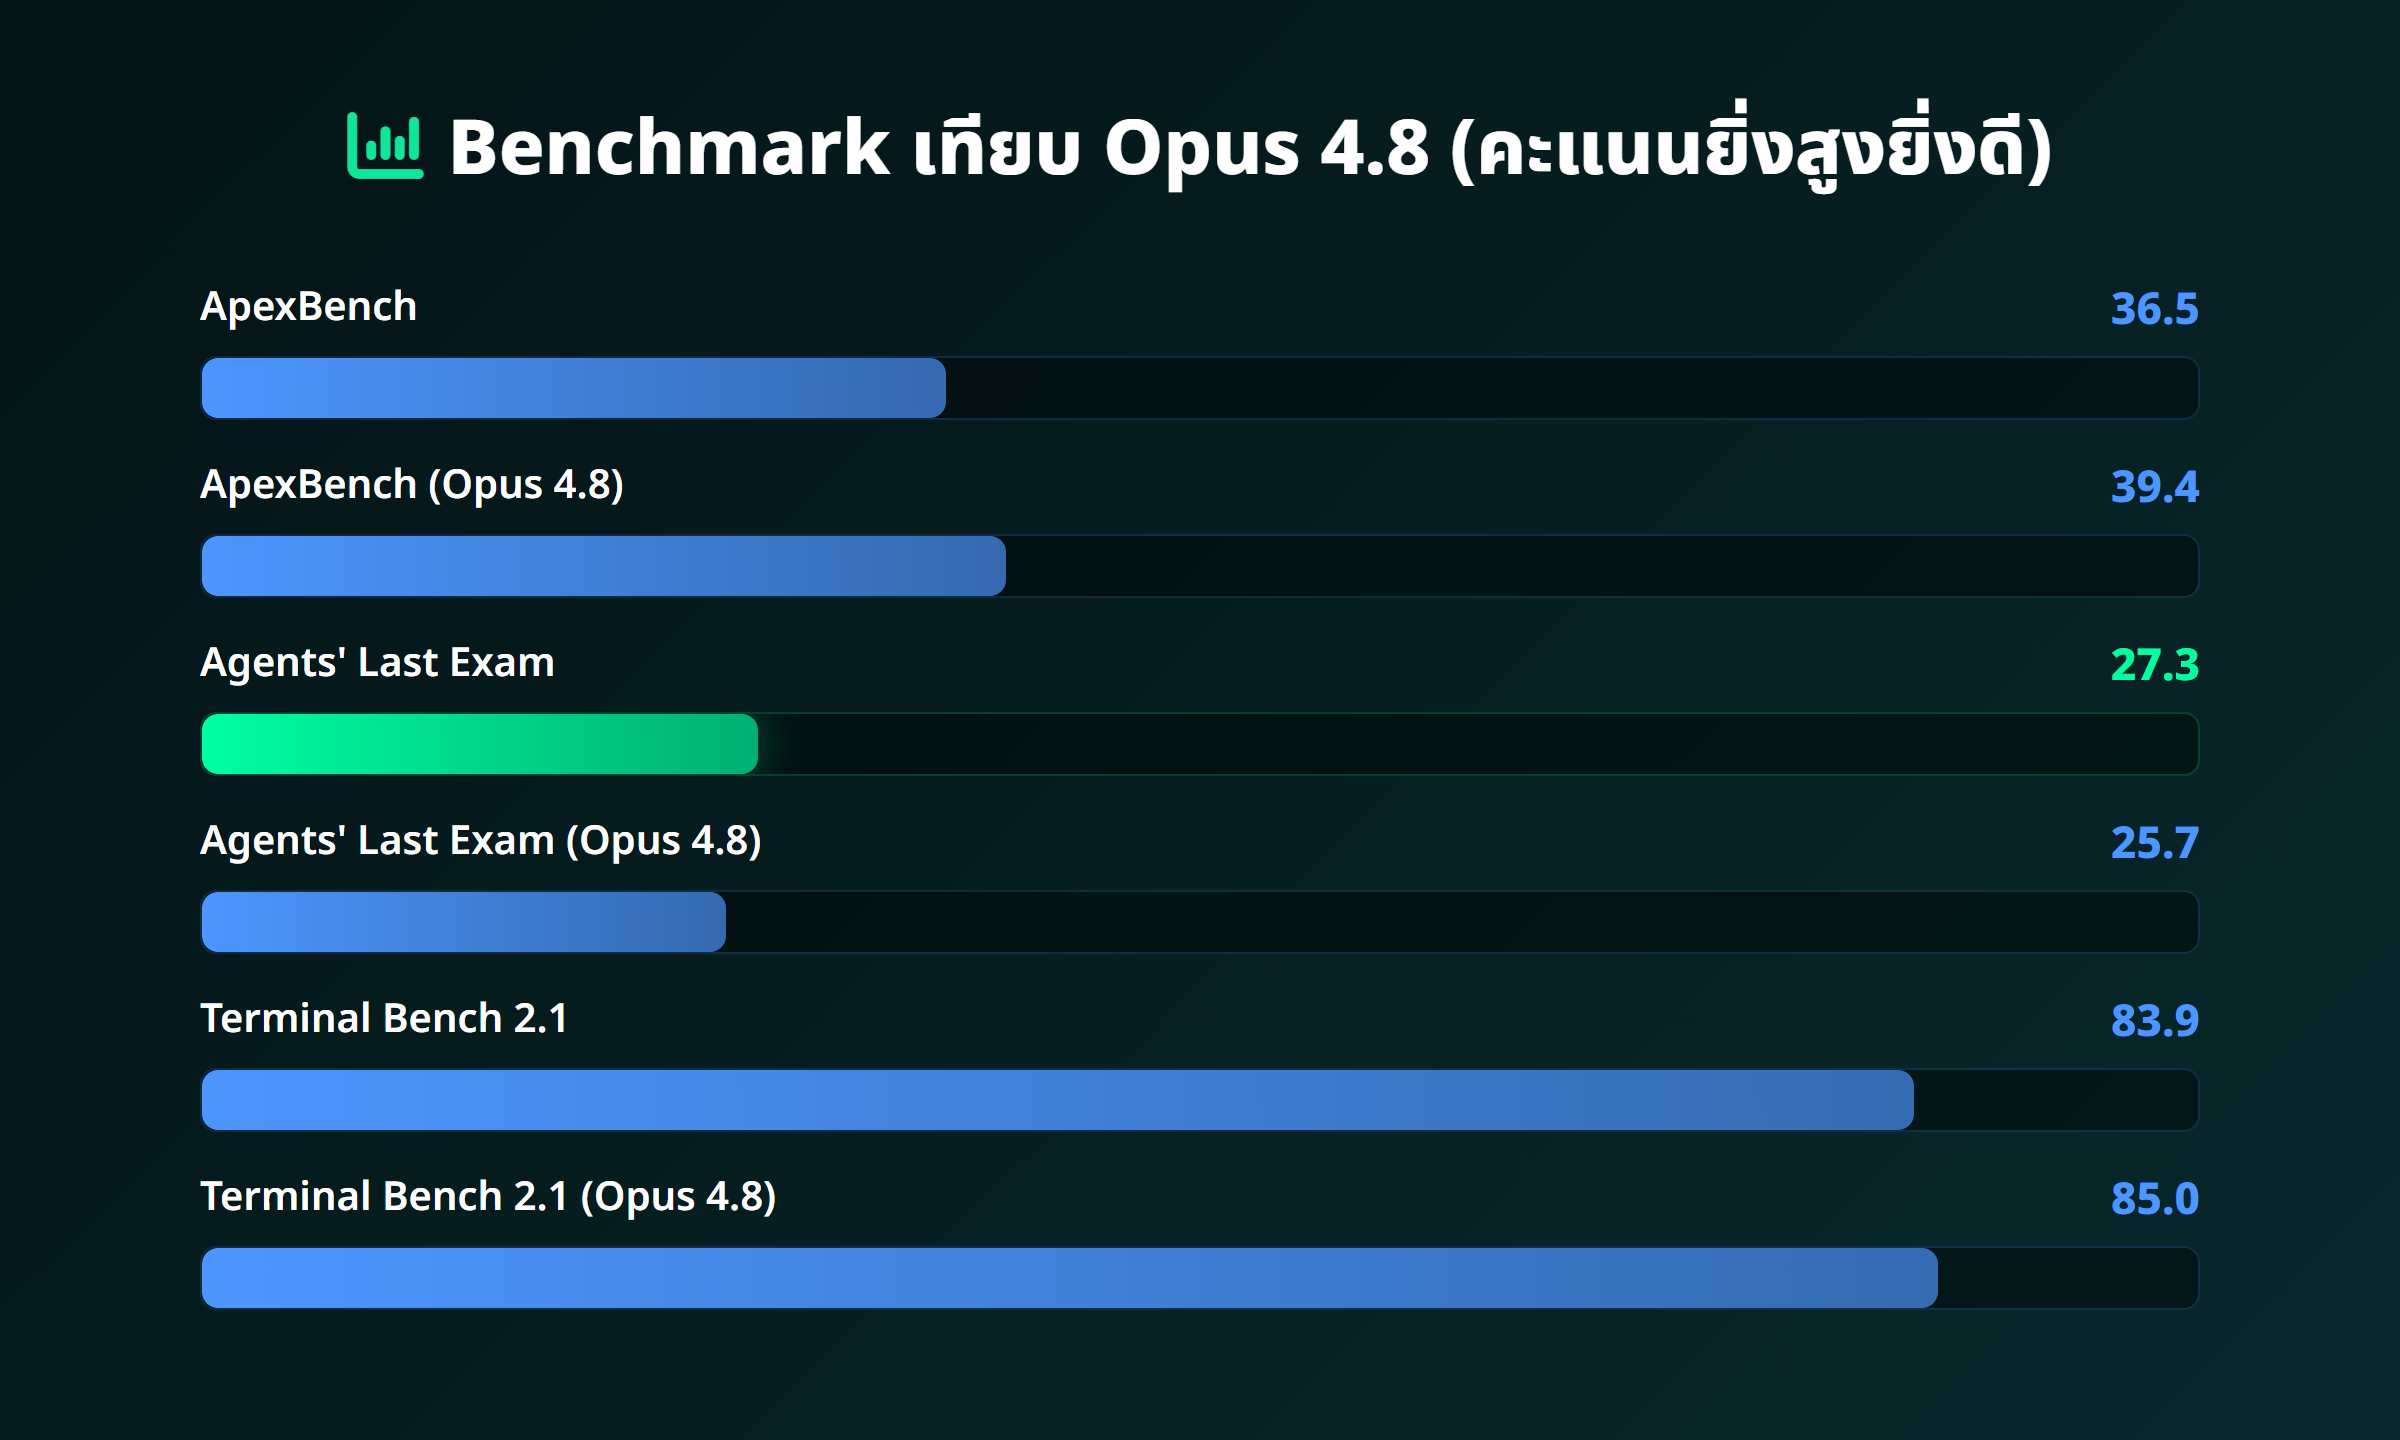
เทียบ Opus 4.8: ApexBench 36.5 vs 39.4 / Agents' Last Exam 27.3 vs 25.7 / Terminal Bench 83.9 vs 85.0
อ่านกราฟแบบไม่อวย: ApexBench ตามอยู่ 2.9 แต้ม (36.5 vs 39.4), Terminal Bench 2.1 ตาม 1.1 แต้ม (83.9 vs 85.0) แต่ Agents' Last Exam แซง 27.3 vs 25.7 — แถม DeepSWE/ZeroBench ก็ชนะ Opus ด้วย มีแค่ NL2Repo ที่ยังตาม 12 แต้ม ถือว่า "ใกล้เคียง" แบบมีลุ้นจริง
ราคา: ดีสุดในเรื่องนี้ — เท่าเดิม ไม่บวกเพิ่ม
Vision at Text Prices — ราคาเท่า V4-Flash ไม่บวกเพิ่ม (ภาพ ref ตรงหัวข้อ ราคา)
Vision ไม่ชาร์จเพิ่ม ราคาเท่ากับ V4-Flash เป๊ะ ภาพคิดตามขนาดแปลงเป็น token (สูงสุด 384) — ตัวอย่างช่วงเวลาปกติ input ¥0.05-3.0 / ล้าน tokens, output ¥4.5-9.0 / ล้าน tokens เทียบกับ Opus 4.8 ที่เป็น flagship ราคาต่างกันเป็นสิบเท่า ใครทำ Agent ที่ต้องดูจอเยอะๆ นี่คือ game changer เรื่องต้นทุน
ลองใช้ยังไง? ง่ายมาก
from openai import OpenAI
client = OpenAI(
  base_url="https://api.deepseek.com",
  api_key="YOUR_API_KEY"
)
resp = client.chat.completions.create(
  model="deepseek-v4-flash-vision-exp",
  messages=[{
    "role": "user",
    "content": [
      {"type": "text", "text": "ช่วยอธิบายภาพนี้แล้วสรุปเป็นสไลด์"},
      {"type": "image_url", "image_url": {"url": "https://example.com/slide.png"}}
    ]
  }]
)
print(resp.choices[0].message.content)
หรือถ้าอยาก reuse ภาพ: อัปโหลดผ่าน Files API เอา file_id มาใส่แทน URL ได้เลย — ไม่ต้องส่ง base64 ซ้ำทุกครั้ง
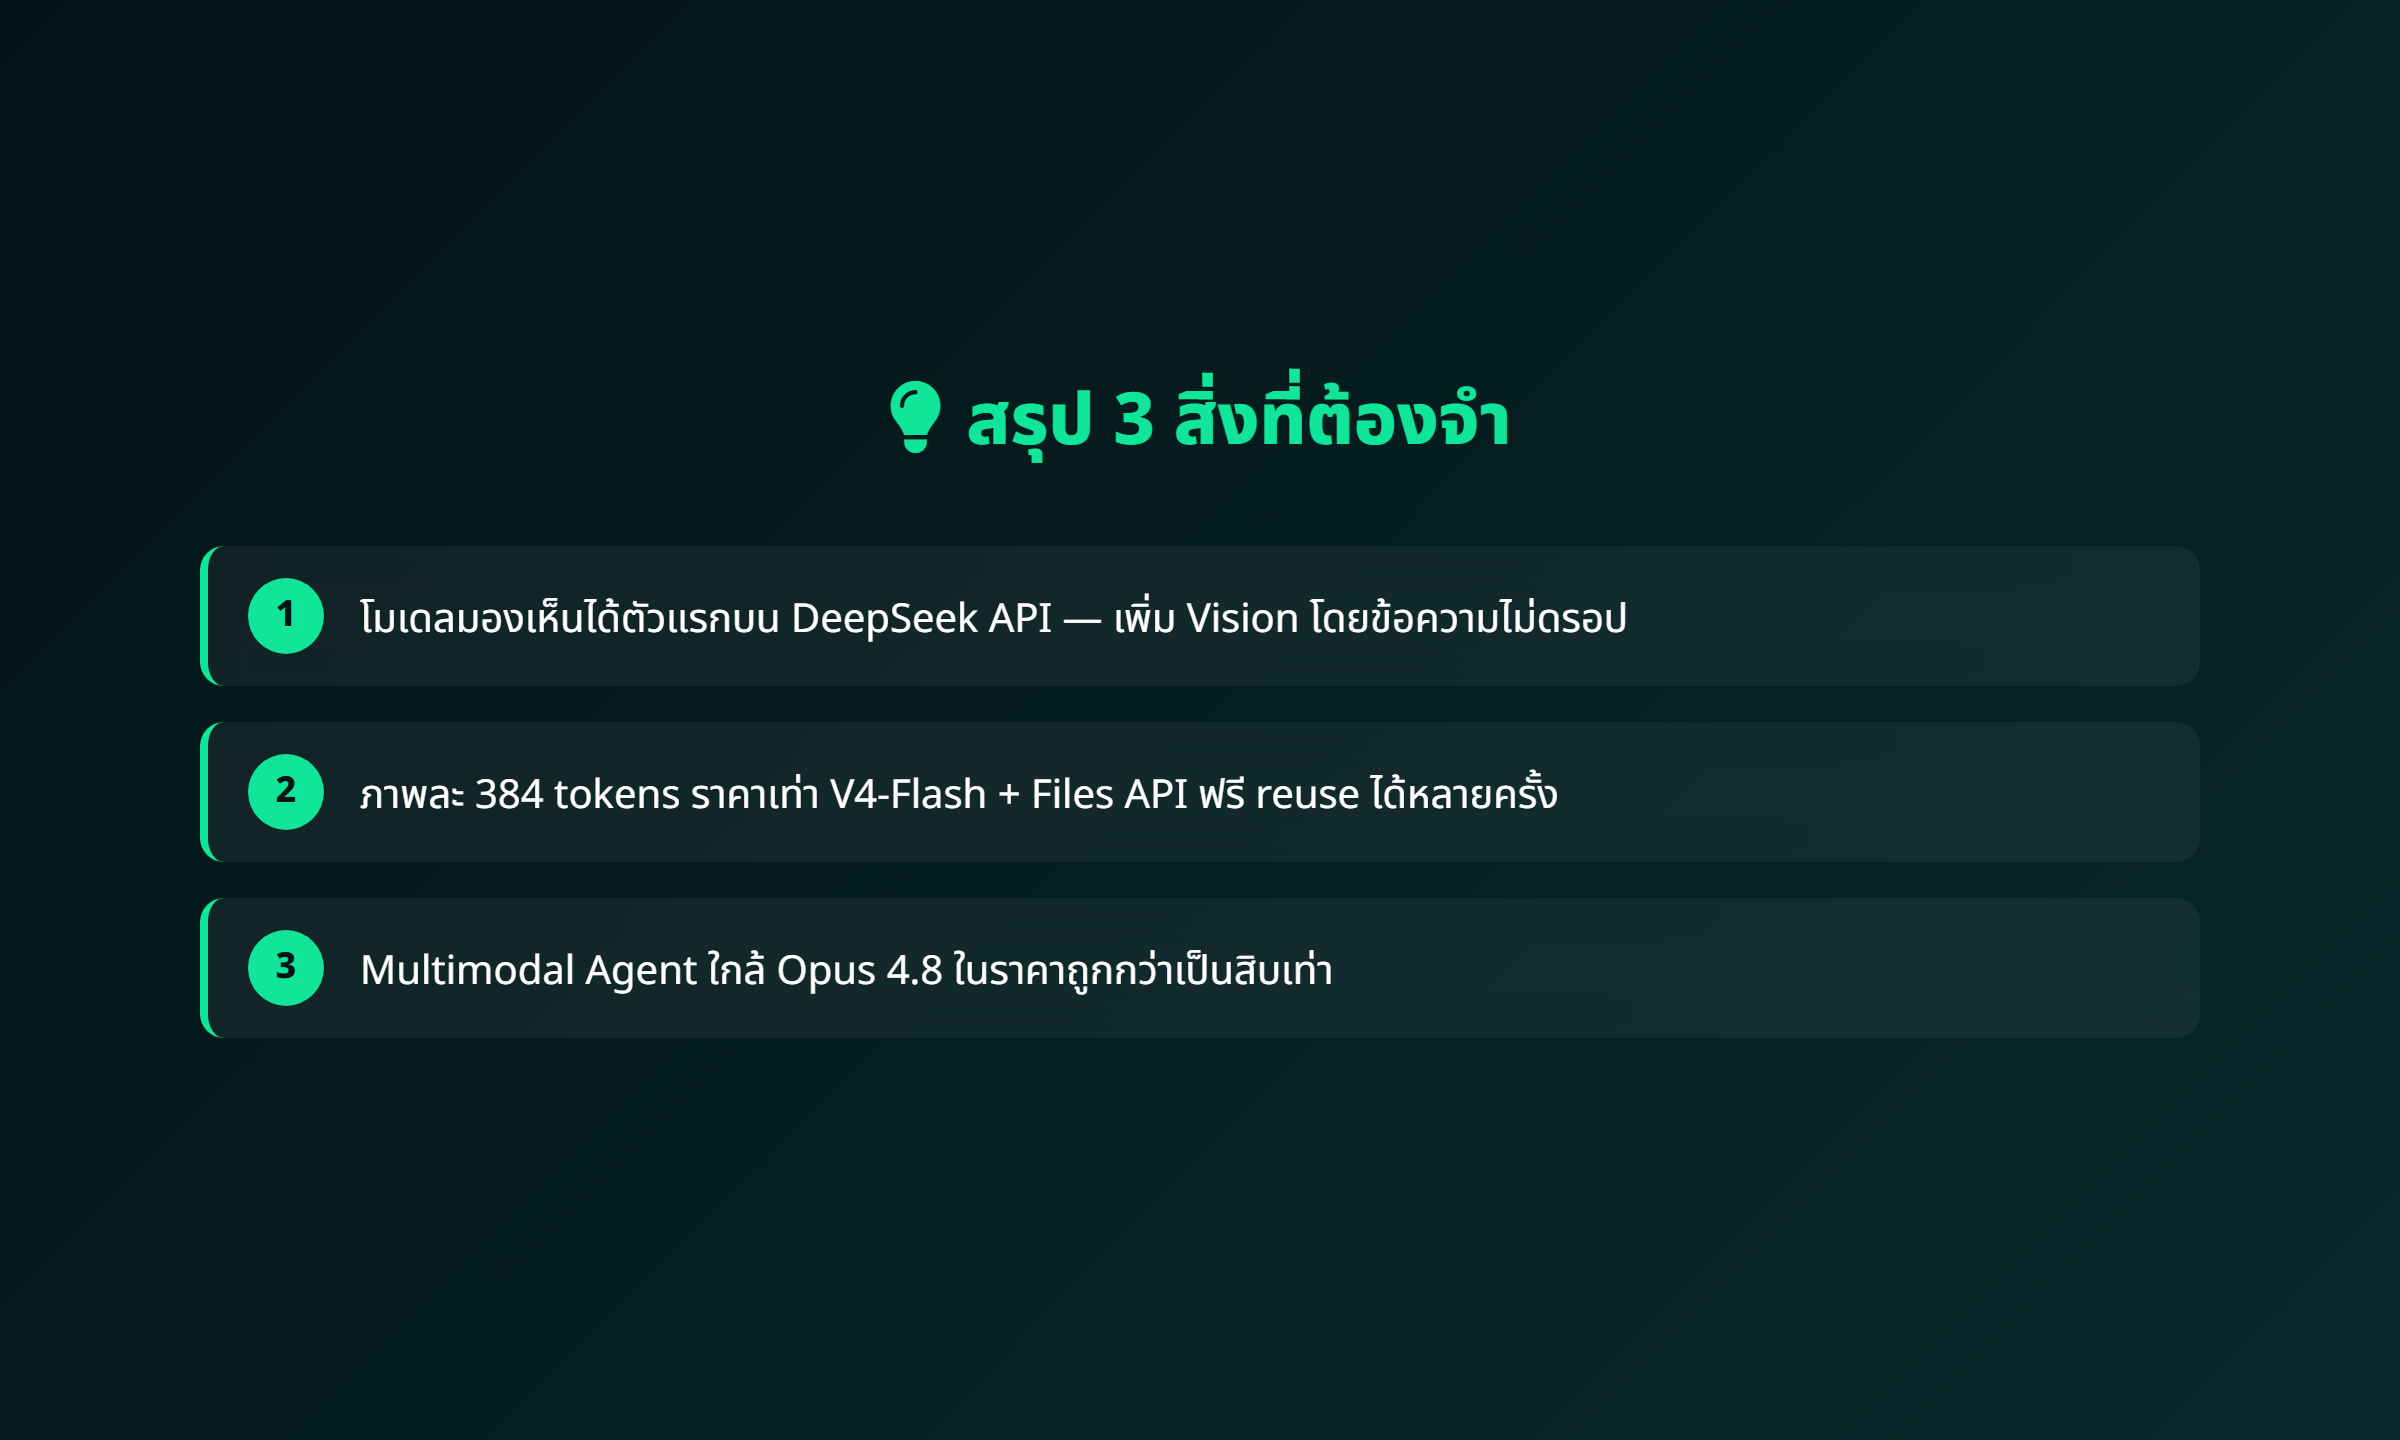
3 ประเด็นหลัก: Zero-cost Text + ราคาเดิม + Files API ฟรี
ใช้ทำอะไรได้บ้าง
คิดแบบไทยๆ: ร้านอีคอมเมิร์ซเอารูปสินค้าให้มันเขียนคำขายหลายภาษา + จัดหน้าเว็บให้, ครูเอาภาพสไลด์/กระดานให้มันทำสไลด์สอนพร้อมแบบฝึกหัด, สตูดิโอเกมเอาสเก็ตช์ให้มันออกเอกสารดีไซน์ตัวละคร, หรือทีมซัพพอร์ตเอาสกรีนช็อตแชต + หน้าออเดอร์ให้มันตรวจคุณภาพอัตโนมัติ — งานที่ต้อง "ดูแล้วทำ" คือทางของมัน
ที่มา: ai-bot.cn — DeepSeek-V4-Flash-Vision-Exp (21 ส.ค. 2026), ข้อมูลเสริมจาก DeepSeek Platform Docs และ Berri AI Benchmark
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!