
ถ้าคุณตามข่าว AI มาตลอด จะเห็นว่าช่วงหลังทุกคนพูดคำว่า Agent กันมาก แต่คำถามที่แท้จริงไม่ใช่ 'โมเดลตอบเก่งแค่ไหน' อีกต่อไปแล้ว — มันกลายเป็น 'มันทำงานแทนเราได้จริงหรือยัง'
รายงานฉบับล่าสุดจาก Goldman Sachs ที่เพิ่งเดินสายสำรวจซิลิคอนแวลลีย์มาเอง สรุปว่า AI กำลังก้าวจากยุค 'ตอบคำถาม' เข้าสู่ยุค 'ลงมือทำ' และสนามแข่งขันไม่ได้อยู่ที่ใครมีโมเดลเก่งกว่า แต่อยู่ที่ใครครองเวิร์กโฟลว์ได้อยู่หมัด
ผมว่าภาพรวมมันชวนคิดมาก เลยอยากเล่าให้ฟังแบบเพื่อนเล่าให้เพื่อนฟัง พร้อมตัวเลขที่ทำให้หยุดอ่านสักแป๊บ
รายงานนี้มาจากไหน แล้วน่าเชื่อถือแค่ไหน
ก่อนจะเชื่อ ให้ดูที่มาของข้อมูลก่อน — Goldman Sachs ไม่ได้นั่งเขียนสรุปในห้องประชุม แต่ลงพื้นที่จริง โดยไปเยี่ยมสตาร์ตอัป AI ผู้บริหารกองทุน VC ชั้นนำ และนักวิจัยจาก Stanford, UC Berkeley และ UC San Francisco (UCSF) ในช่วงวันที่ 18–19 สิงหาคม ที่ผ่านมา
ไฮไลต์คือ นี่คือปีที่ สามติดต่อกัน ที่ทีม Goldman ลงไปสำรวจสายการผลิต AI ของซิลิคอนแวลลีย์แบบเจาะลึก แปลว่ามุมมองของเขาไม่ได้มาจากการดูเทรนด์ผ่านหน้าจอ แต่มาจากการคุยกับคนที่ลงมือทำจริง
ข้อสรุปหลักของรายงานมีอยู่ 3 เรื่องใหญ่ ๆ ที่ผมจะไล่ให้ฟังทีละชั้น
เรื่องที่ 1: AI ขยับจาก 'ตอบคำถาม' เป็น 'ลงมือทำ'
Goldman บอกว่าโมเดลธุรกิจ AI กำลังเปลี่ยนจากเดิมที่คิดราคาแบบ 'เช่าที่นั่ง' (seat-based subscription) ไปเป็นการคิดเงินตามปริมาณการใช้ จำนวนธุรกรรม และผลลัพธ์แทน — คือถ้าไม่ได้ใช้จริงก็ไม่ต้องจ่าย แถมยังวัดผลได้จริงด้วย
พร้อมกันนั้น ตัว Agent ก็เปลี่ยนบทบาทจาก 'เครื่องมือช่วยทำงาน' กลายเป็น 'คนที่ทำงานนั้นจนจบ' ไปแล้ว
AI กำลังเลิกเป็น 'คนที่ตอบคำคุณ' แล้วกลายเป็น 'คนที่จัดการงานคุณให้เสร็จ'
แต่การจะให้ Agent ลงมือทำจริงในองค์กรใหญ่ ๆ นั้น Goldman ชี้ว่า อุปสรรคสำคัญไม่ใช่ 'โมเดลเก่งไม่พอ' อีกต่อไป แต่คือความรับผิดชอบจะแบ่งยังไง และควบคุมกระบวนการได้หรือเปล่า
นักวิจัยจาก Stanford ที่รายงานอ้างถึง บอกว่าตอนนี้บริษัทส่วนใหญ่ยังอยู่ในโหมด 'มนุษย์คอยเฝ้าดู' อยู่เลย โดยเฉพาะงานสายกฎหมาย ความเสี่ยง (risk) ประกันภัย และตรวจสอบบัญชี ซึ่งเป็นงานที่ถ้าโมเดลพลาดแล้ว ใครรับผิดชอบ ตามรอยย้อนกลับได้ไหม แก้ไขทันไหม — พวกนี้สำคัญพอ ๆ กับความเก่งของโมเดล
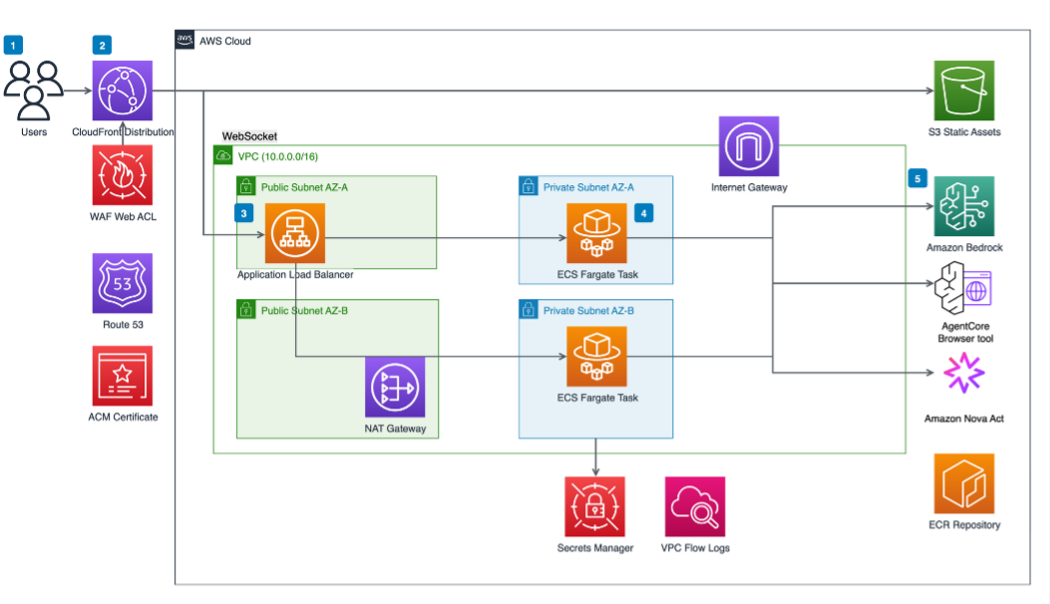
ภาพ: เอเจนต์ AI ที่ทำงานอัตโนมัติในเวิร์กโฟลว์องค์กร (ที่มา: AWS)
เวิร์กโฟลว์แบบไหนที่ 'ถูกทำให้อัตโนมัติก่อน'
Goldman สรุปไว้ว่า งานที่ถูกนำไปทำอัตโนมัติก่อน มักมี 3 ลักษณะร่วมกัน
- ขอบเขตการตัดสินใจชัดเจน — รู้ว่าตรงไหนคือจุดตัดสินใจ
- ผลลัพธ์ตรวจสอบได้ — วัดได้ว่าได้หรือไม่ได้
- ผิดแล้วย้อนกลับได้ — มีทางแก้ ไม่ทำแล้วพังทั้งระบบ
ตัวอย่างที่ยกมาคือ งานประมวลผลใบแจ้งหนี้ (invoice) ให้ AI ดึงข้อมูลและตรวจสอบก่อน โดยกรณีที่ความมั่นใจต่ำส่งให้คนตรวจซ้ำ แล้วค่อยผ่านเข้าระบบ ERP ที่ย้อนกลับได้
เรื่องที่ 2: ต้นแบบกับโอเพนซอร์ส ไม่ใช่ขั้วตรงข้าม แต่เป็นจุดแบ่งงาน
ประโยคที่ผมติดใจที่สุดจากรายงานนี้คือ 'ข้อถกเถียงระหว่าง open source กับ closed source ไม่ใช่การเลือกอย่างใดอย่างหนึ่ง' — มันคือการแบ่งกันทำตามระดับของงานต่างหาก
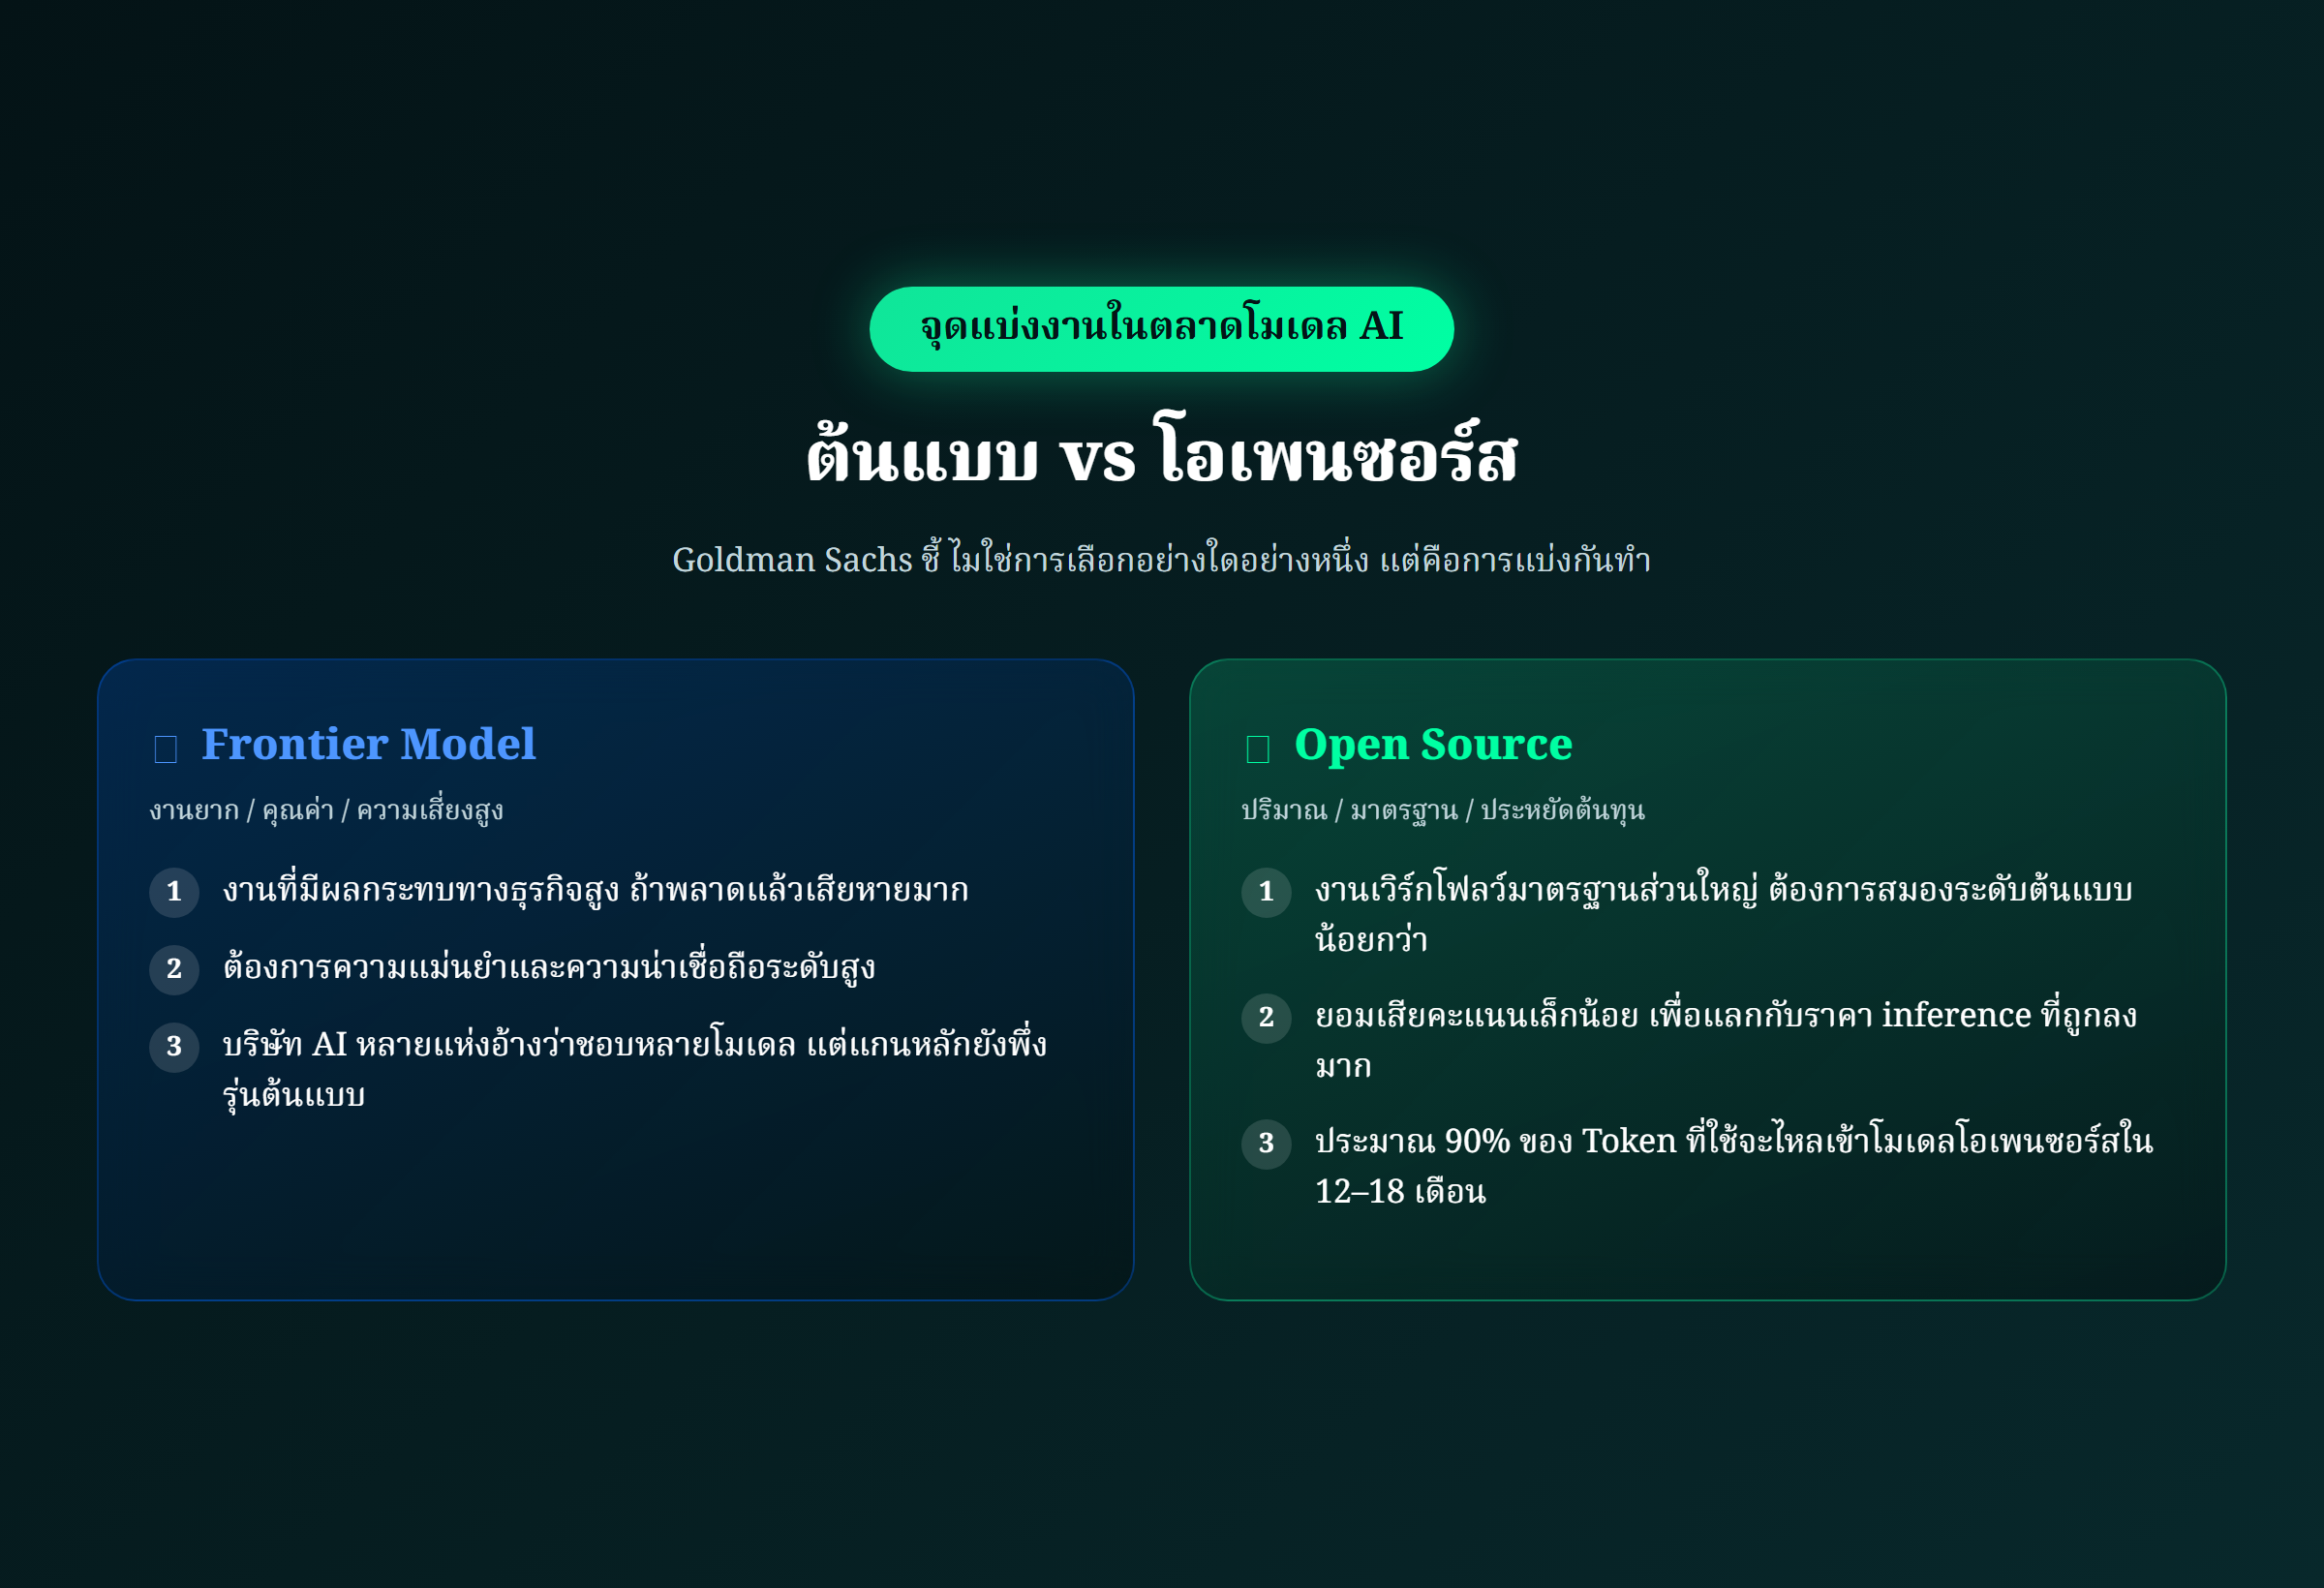
ภาพ: จุดแบ่งงานระหว่างโมเดลต้นแบบกับโอเพนซอร์ส
สองค่ายมีความเห็นต่างกันชัดเจน
- ฝั่งต้นแบบ (Frontier) มองว่า benchmark ในองค์กรมักประเมินโมเดลต่ำเกินจริง เพราะถ้าโมเดลแม่นยำลดลง ผลเสียต่อธุรกิจอาจแพงกว่าค่า inference ที่ประหยัดไปได้มาก ดังนั้นบริษัท AI หลายแห่งถึงแม้จะบอกว่าใช้หลายโมเดล แต่ในงานหลักจริง ๆ ยังพึ่งโมเดลต้นแบบอยู่ดี
- ฝั่งโอเพนซอร์ส มองว่าเวิร์กโฟลว์องค์กรส่วนใหญ่ไม่ถึงขั้นต้องใช้สมองระดับต้นแบบ และเมื่อโอเพนซอร์สเก่งขึ้นเรื่อย ๆ ลูกค้าก็ยอมเสียคะแนนเล็กน้อย เพื่อแลกกับค่า inference ที่ถูกลงมาก
มี VC รายหนึ่งประเมินไว้ว่า ในอีก 12–18 เดือนข้างหน้า ประมาณ 90% ของ Token ที่ใช้กันจะไหลเข้าโมเดลโอเพนซอร์ส ตรงนี้ผมว่าน่าจับตาเลยทีเดียว
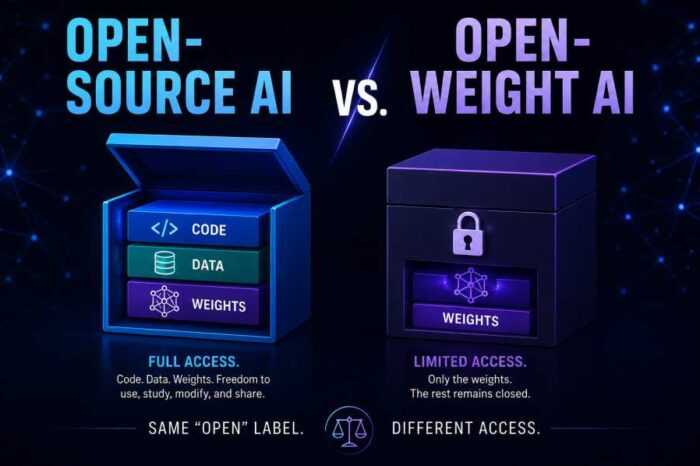
ภาพ: Goldman Sachs ชี้โอเพนซอร์สอาจเป็นผู้ชนะเงียบ ๆ ของ Big Tech (ที่มา: Tech Startups)
สรุปคืออนาคตตลาดโมเดลอาจแบ่งหน้าที่ชัดเจนขึ้น — โมเดลต้นแบบรับงานที่มีมูลค่าสูง ซับซ้อน ต้องการความแม่นยำ ส่วน โมเดลโอเพนซอร์สรับงานมาตรฐานปริมาณมากและกิน Token ส่วนใหญ่ของระบบ
เรื่องที่ 3: เวิร์ลโมเดลพา AI เข้าสู่โลกกายภาพ และอาจจุดคอมพิวต์รอบใหม่
ในรอบ 18 เดือนที่ผ่านมา นักวิจัยหันไปสนใจ World Model (เวิร์ลโมเดล) กันมากขึ้นเรื่อย ๆ ซึ่งต่างจาก LLM ที่เทรนจากข้อมูลอินเทอร์เน็ตเป็นหลัก — เวิร์ลโมเดลต้องเข้าใจสภาพแวดล้อม ความสัมพันธ์เชิงเหตุผล กฎฟิสิกส์ และการโต้ตอบแบบพลวัตในโลกจริง
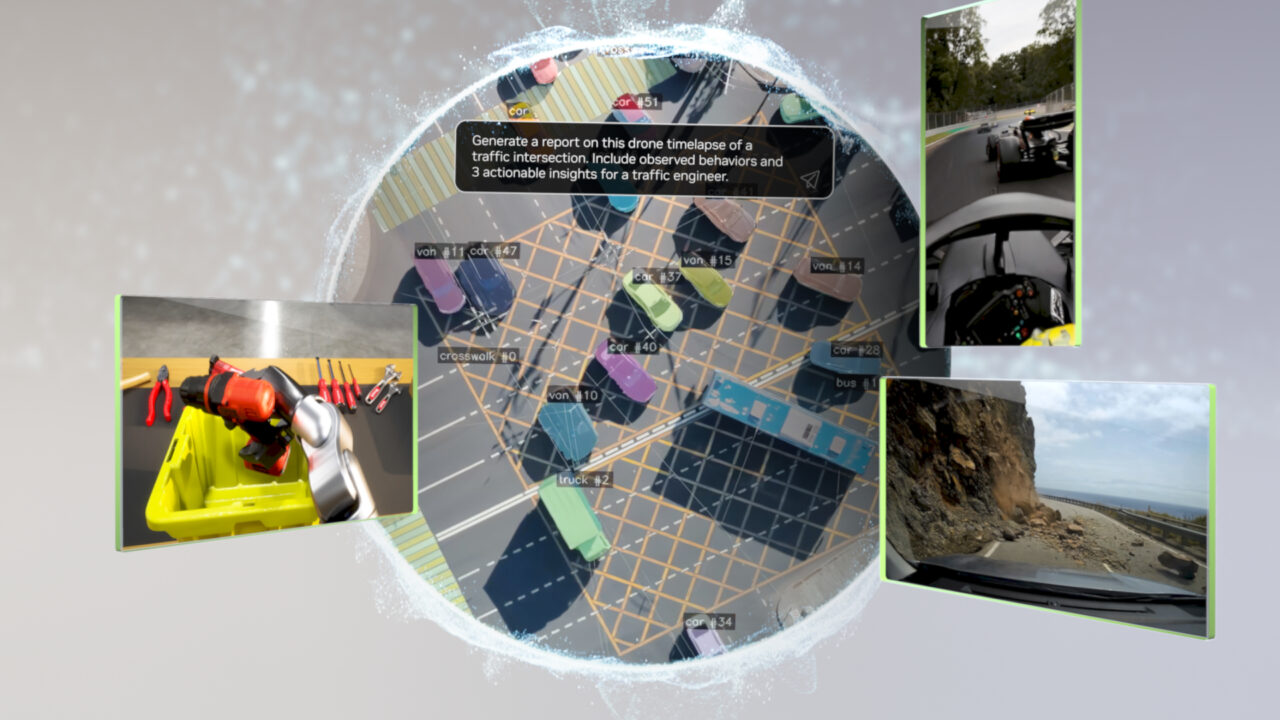
ภาพ: Open World Models พา AI เข้าสู่ฟิสิกส์จริง (ที่มา: NVIDIA Blog)
นั่นแปลว่าข้อมูลที่ใช้เทรนยิ่งต้องมาจากระบบกายภาพ อุตสาหกรรมเฉพาะทาง และฉากการทำงานจริง ทำให้ข้อมูลเฉพาะ (proprietary data) ยิ่งมีความสำคัญมากขึ้นไปอีก
Goldman มองว่าโจทย์ในแวดวงฟิสิกส์ อุตสาหกรรม วิทยาศาสตร์ และหุ่นยนต์ มีพื้นที่ปัญหาใหญ่กว่าการสร้างข้อความล้วน ๆ มหาศาล และยิ่งต้องใช้พลังประมวลผลสูงมาก
เมื่อ AI เดินจากโลกดิจิทัลเข้าสู่โลกกายภาพ ความต้องการคอมพิวต์ทั้งในส่วนเทรน การจำลอง (simulation) และ inference อาจเกิดเส้นการเติบโตเส้นใหม่ โดย Goldman คาดว่าในอีก 5 ปีข้างหน้า ความต้องการคอมพิวต์อาจโตขึ้นประมาณ 24 เท่า และภาวะอุปทานตึงตัวก็จะยาวนานขึ้นตามไปด้วย
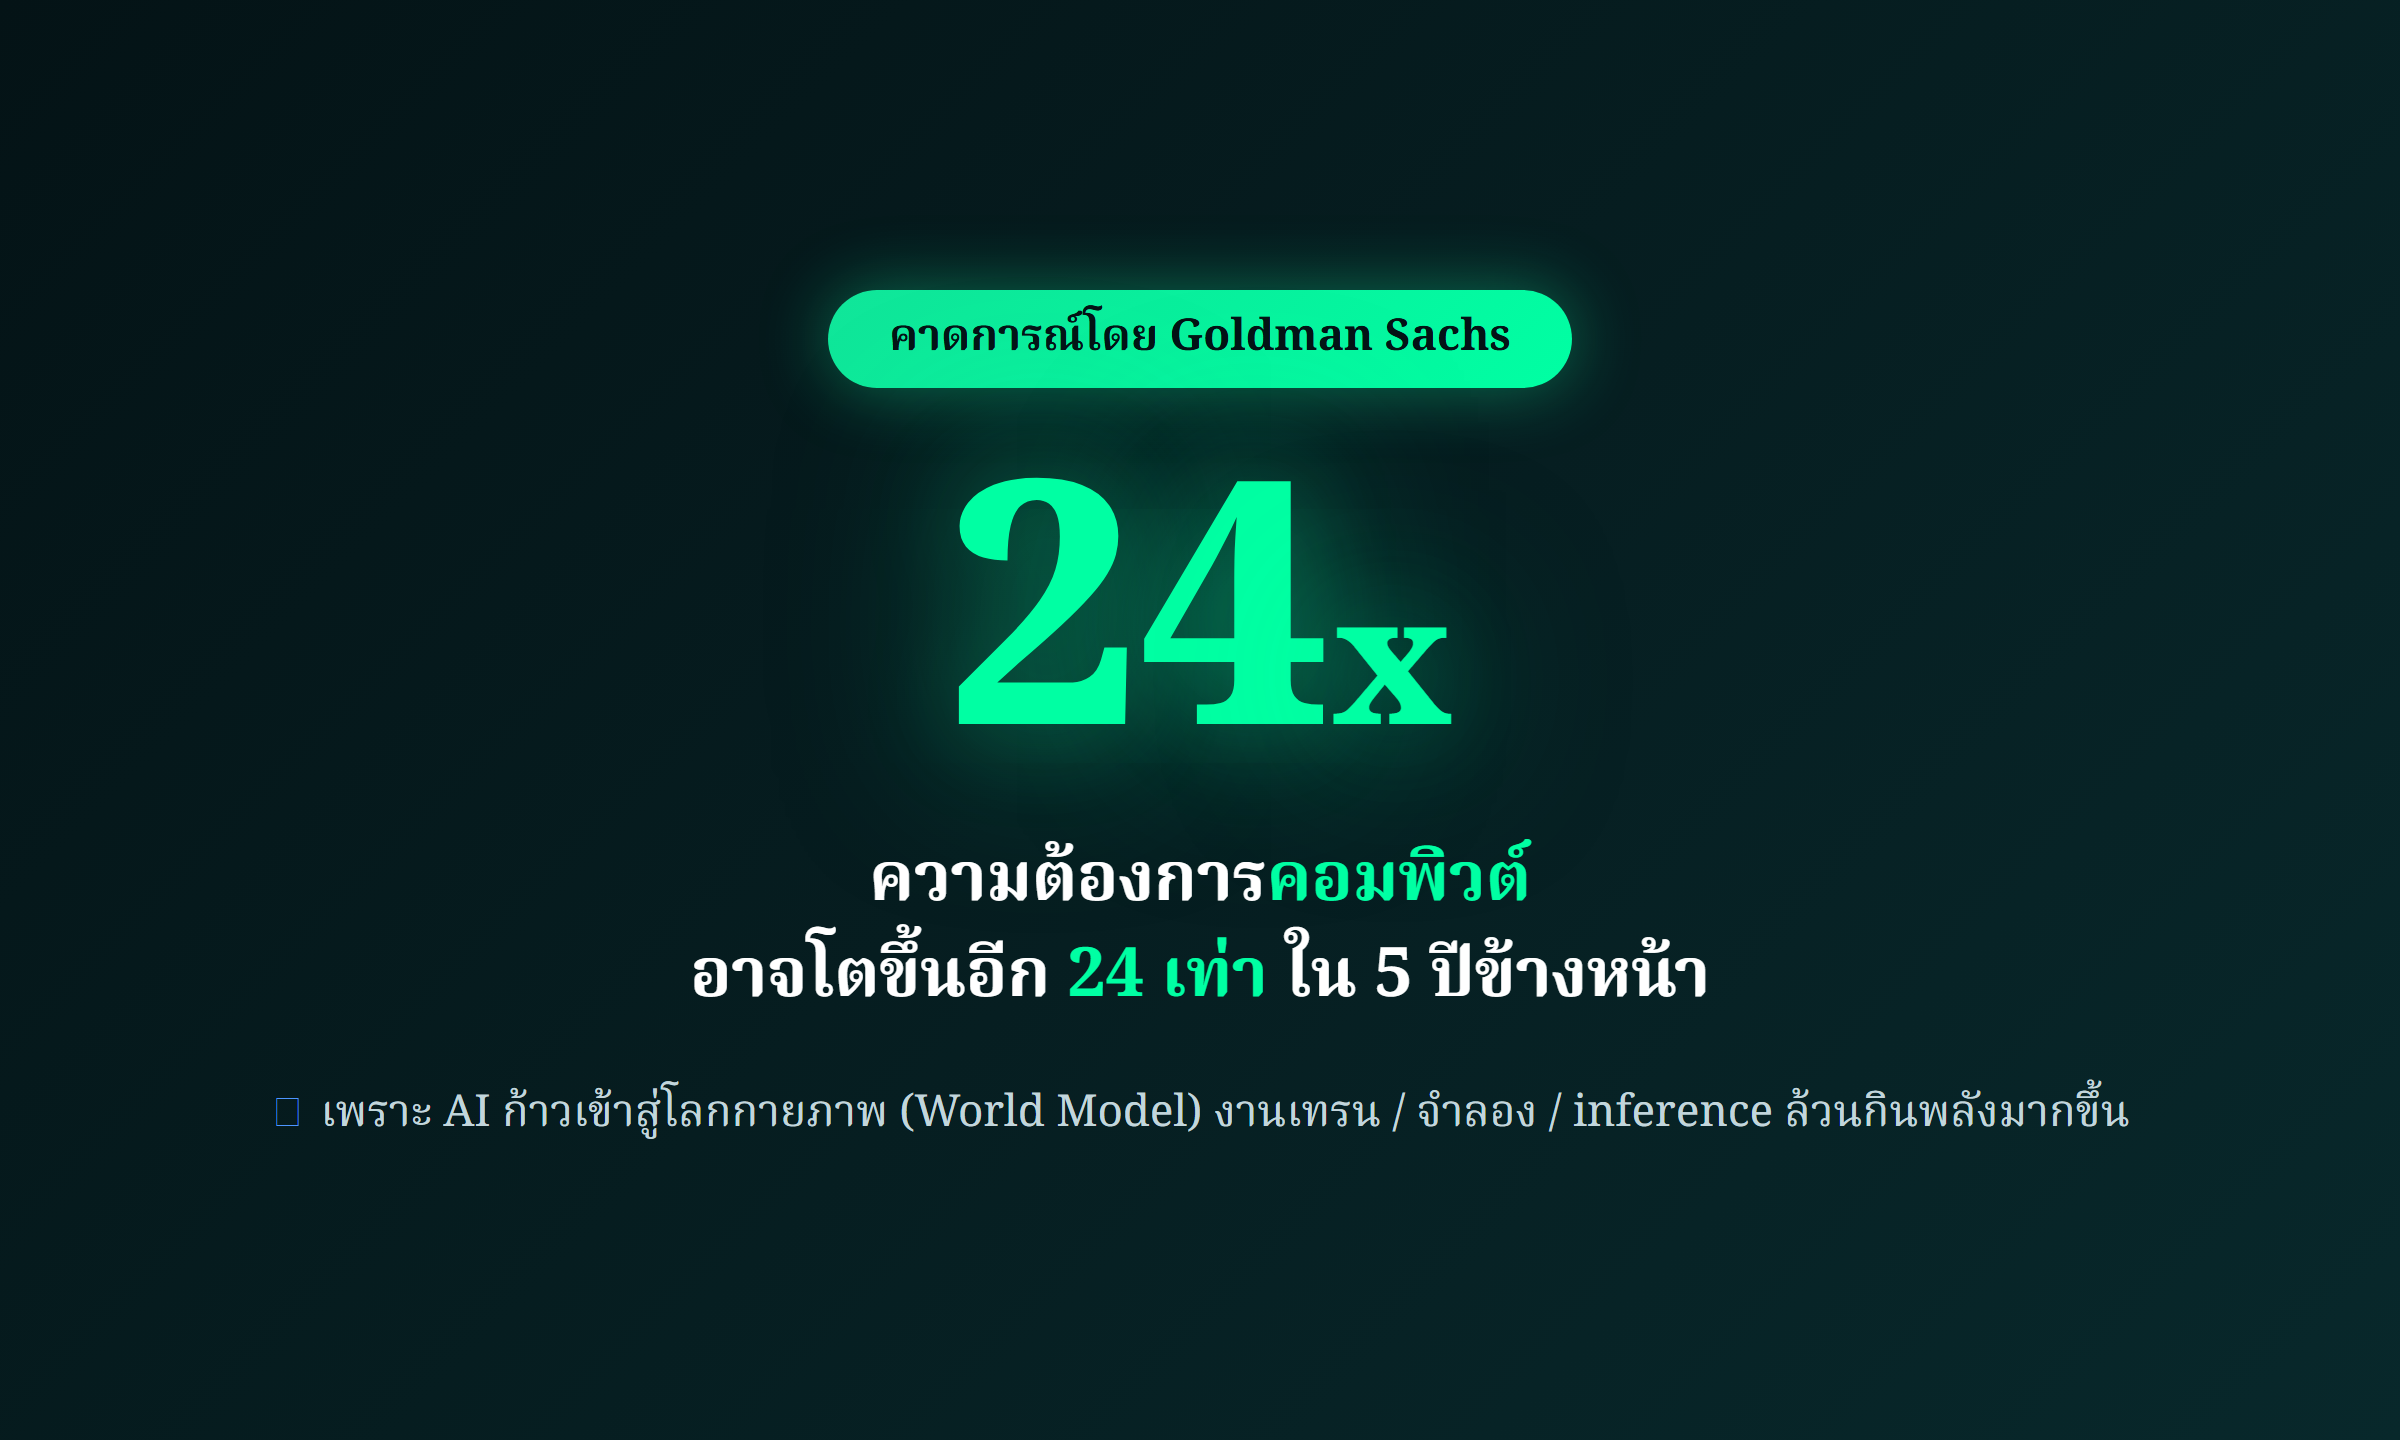
ภาพ: ดันความต้องการคอมพิวต์โตถึง 24 เท่าใน 5 ปี
ใครได้ประโยชน์โดยตรง? บริษัทคลาวด์และโครงสร้างพื้นฐานคอมพิวต์ เช่น Microsoft, Oracle และ CoreWeave
แล้วมันสำคัญกับเรายังไง
ลองเอาภาพนี้กลับมาใช้กับงานของตัวเองดู ผมว่ามี 3 ข้อที่เก็บไปคิดต่อได้
- ถ้าคุณกำลังวางงานให้ AI ทำ ให้เลือกงานที่ขอบเขตชัด วัดผลได้ และพลาดแล้วย้อนกลับได้ก่อน — งานแบบนี้จะสำเร็จไวและเสี่ยงน้อย
- อย่ารีบเทเงินไปปลดล็อกโมเดลต้นแบบทั้งบริษัท ลองแยกงานที่ 'ต้องการความแม่นยำสูง' และงานที่ 'เป็น routine ปริมาณมาก' แล้วใช้โมเดลคนละระดับให้ถูกกับงาน
- ถ้าธุรกิจของคุณอยู่ในอุตสาหกรรมที่ต้องจับต้องโลกจริง (โรงงาน หุ่นยนต์ โลจิสติกส์ ฯลฯ) จับตาคลื่น เวิร์ลโมเดล + ต้นทุนคอมพิวต์ ไว้ให้ดี เพราะมันอาจเปลี่ยนสมการค่าใช้จ่ายของทั้งวงการ
แน่นอนว่ายังมีสิ่งที่เรายังรู้ไม่เต็มร้อย เช่น ตัวเลข 90% ของ Token เป็นเพียงการคาดการณ์ของ VC รายหนึ่ง ไม่ใช่ข้อสรุปของตลาดจริง และ '24 เท่าใน 5 ปี' ก็เป็นประมาณการณ์ที่ต้องจับตาดูว่าอุปทานคอมพิวต์จะตามทันหรือไม่
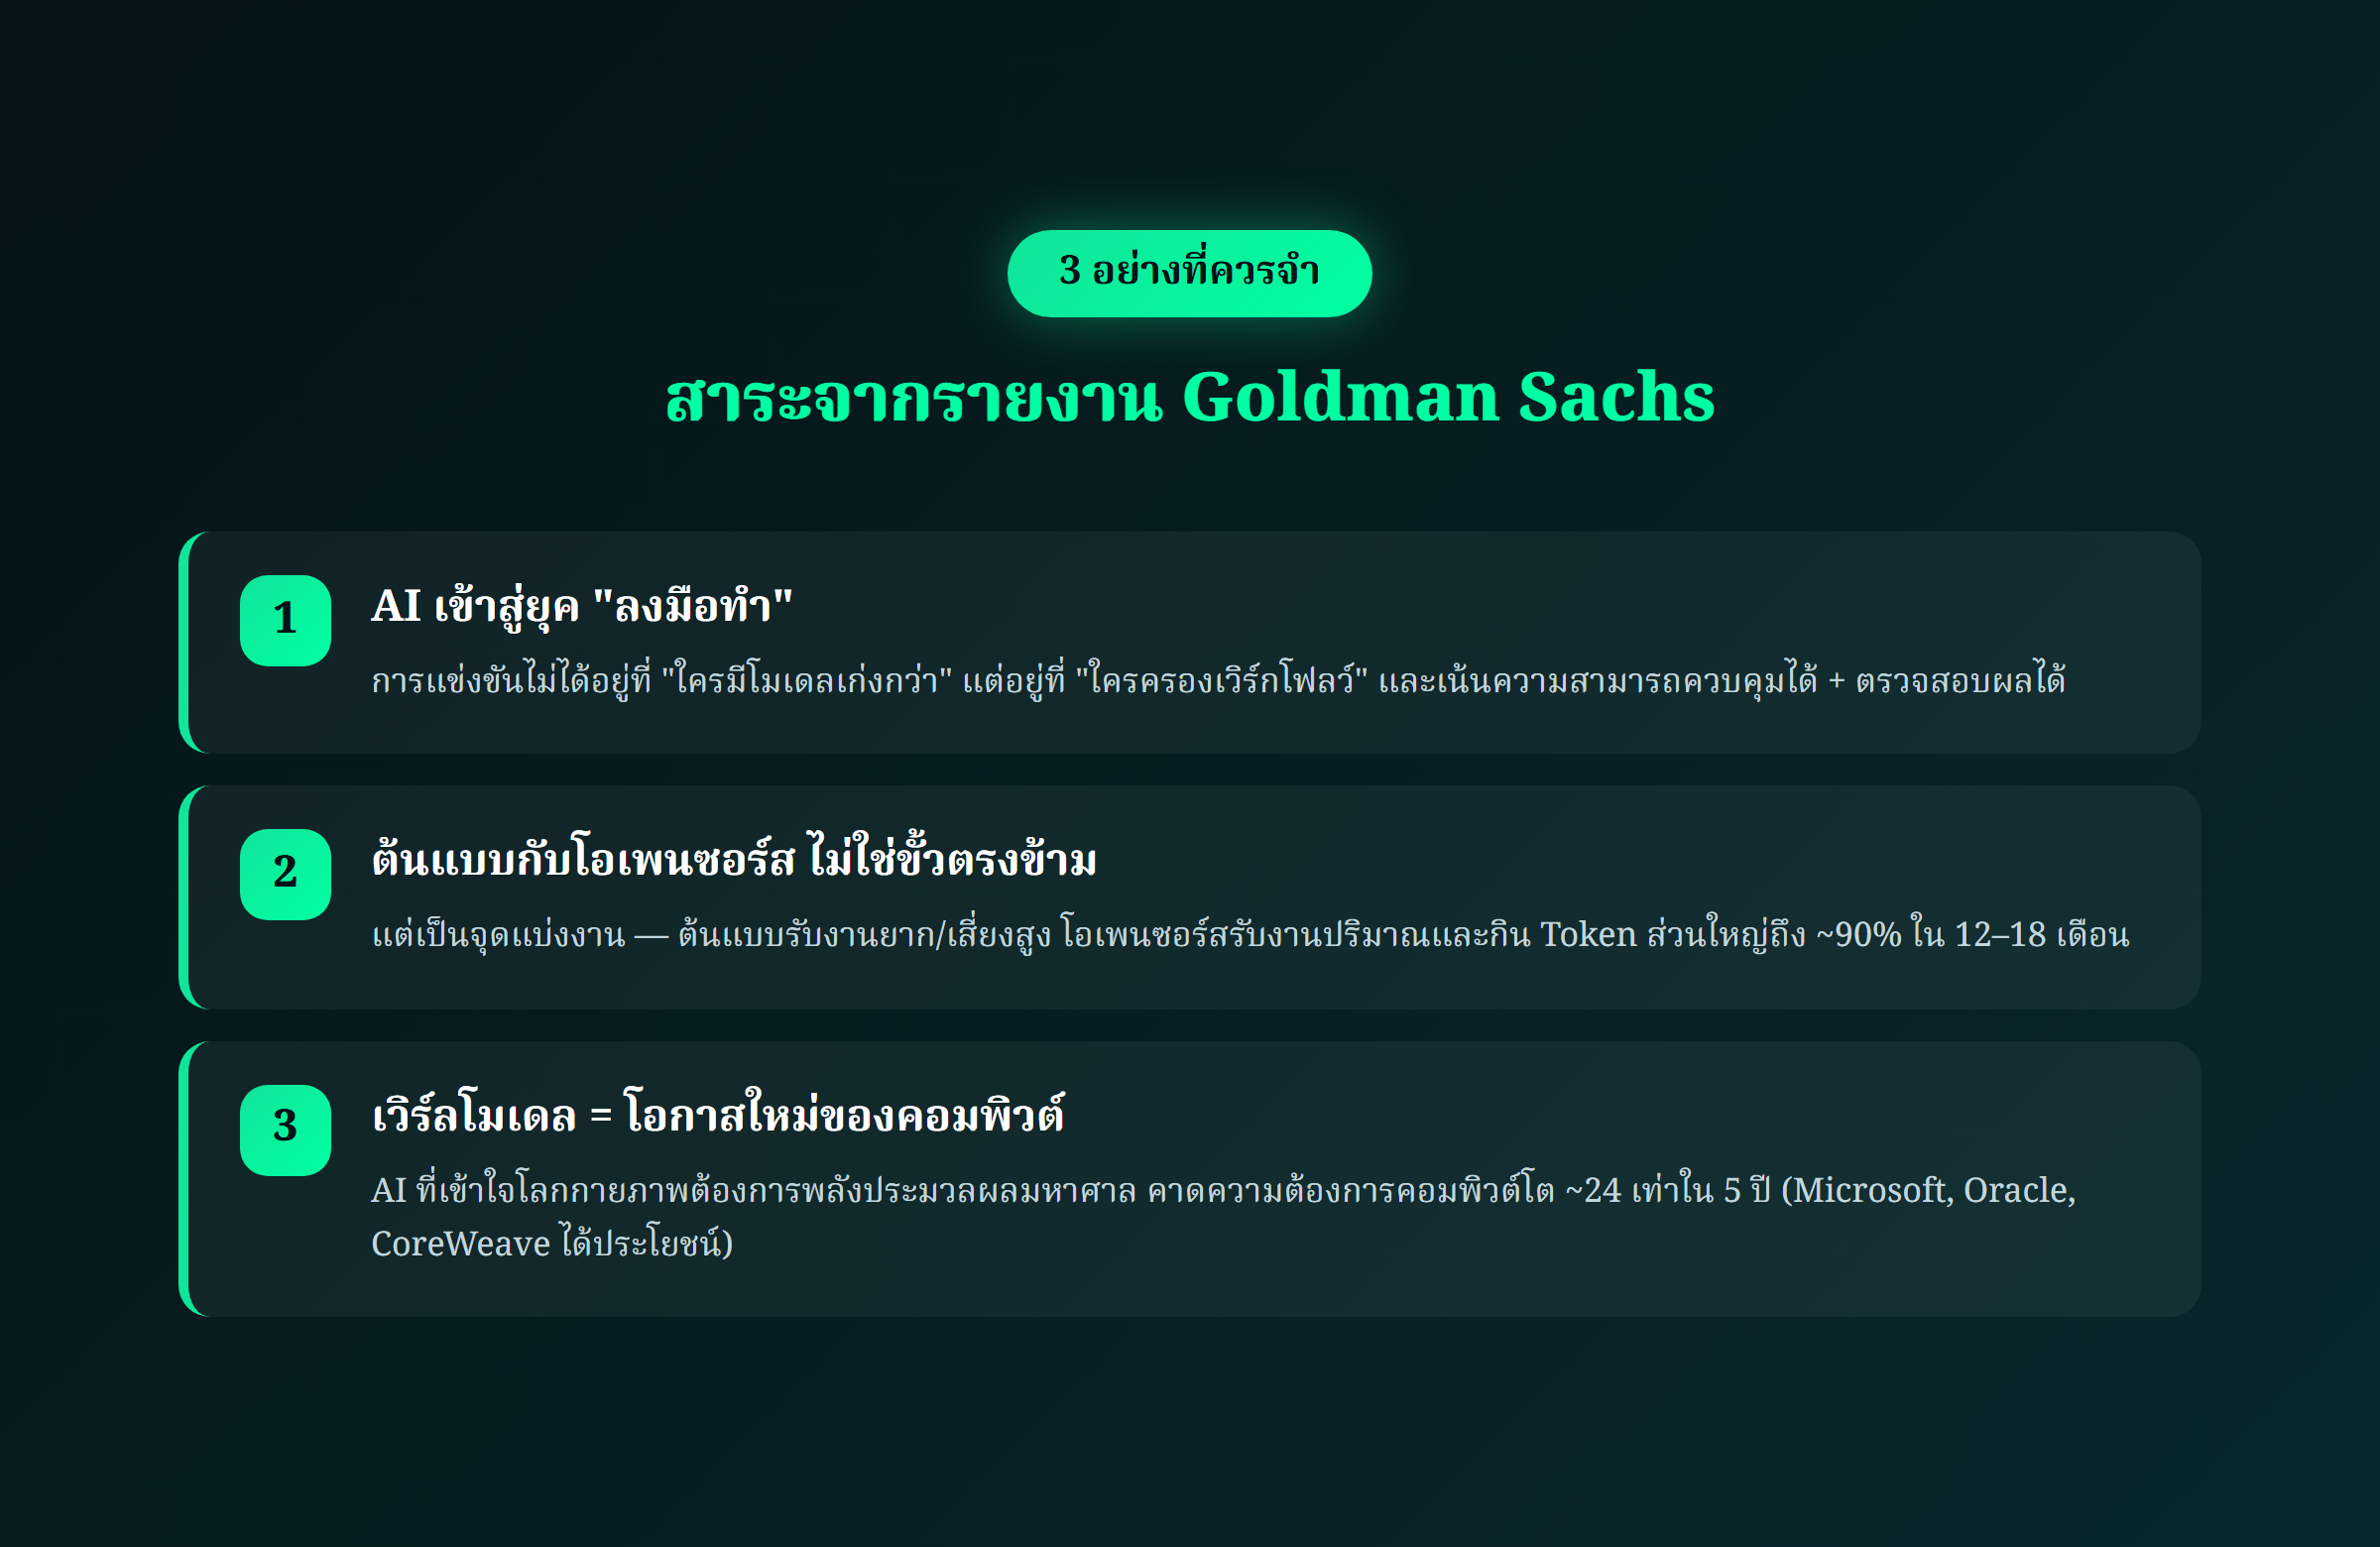
ภาพ: 3 ประเด็นที่ควรจำจากรายงาน
สรุป 3 เรื่องที่ควรจำ
- AI เข้าสู่ยุค 'ลงมือทำ' — การแข่งขันย้ายจาก 'ใครโมเดลเก่ง' ไปที่ 'ใครครองเวิร์กโฟลว์และควบคุมได้'
- ต้นแบบกับโอเพนซอร์สแบ่งงานกัน — ต้นแบบรับงานยาก โอเพนซอร์สรับงานปริมาณ เฉลี่ย ~90% ของ Token
- เวิร์ลโมเดลเปิดโอกาสคอมพิวต์ใหม่ — AI เข้าสู่โลกกายภาพอาจดันความต้องการคอมพิวต์โต ~24 เท่าใน 5 ปี
ที่มา: 华尔街见闻 — Silicon Valley survey: Agent เข้าสู่ยุคปฏิบัติการ (Goldman Sachs สรุป), และข้อมูลจากรายงาน/บทสัมภาษณ์ของ Goldman Sachs
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!