
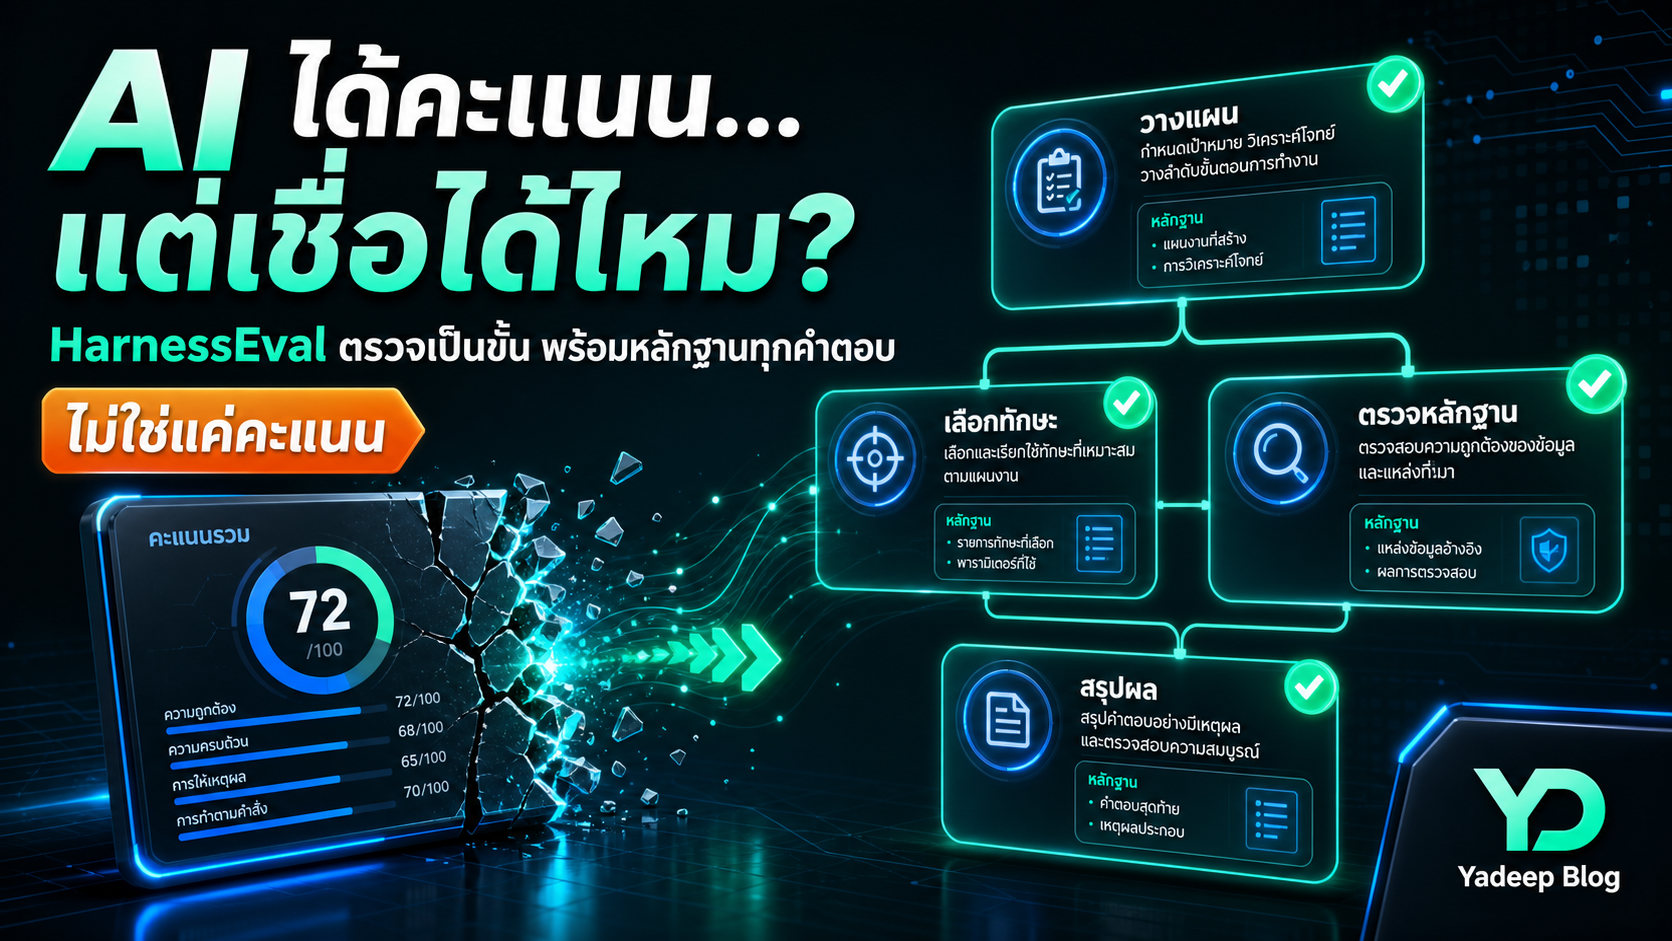
AI ได้ 72 คะแนนจาก 100 ฟังดูดี แต่คำถามที่สำคัญกว่าคือ: มันพลาดตรงไหน และคะแนนนี้เชื่อได้แค่ไหน? นี่คือจุดที่ HarnessEval พยายามแก้ เพราะ benchmark แบบเดิมมักจบด้วยเลขก้อนเดียว ทั้งที่งาน AI โดยเฉพาะ world model หรือระบบโต้ตอบ มีรายละเอียดให้พลาดได้เยอะมาก
คะแนนบอกว่า “ผลลัพธ์เป็นอย่างไร” แต่หลักฐานบอกว่า “ทำไมเราจึงควรเชื่อผลลัพธ์นั้น”
ปัญหาของ benchmark แบบเดิม
การประเมินแบบ rubric ตายตัวมีข้อดี: เร็ว เปรียบเทียบง่าย และทำซ้ำได้ แต่เมื่อโจทย์ซับซ้อนขึ้น มันเริ่มตอบคำถามไม่พอ เช่น วิดีโอโลกจำลองอาจดูสวยแต่ฟิสิกส์ผิด ตัวละครอาจเคลื่อนไหวได้แต่เป้าหมายหลุด หรือภาพอาจต่อเนื่องแต่เมื่อสั่งให้เปลี่ยนสถานะกลับทำไม่ได้
ถ้าให้คะแนนรวมอย่างเดียว ทีมพัฒนาเห็นเพียงปลายทาง เหมือนหมอบอกว่า “สุขภาพ 72 คะแนน” โดยไม่บอกว่าปอด หัวใจ หรือการนอนมีปัญหาตรงไหน
HarnessEval เปลี่ยนวิธีตรวจอย่างไร
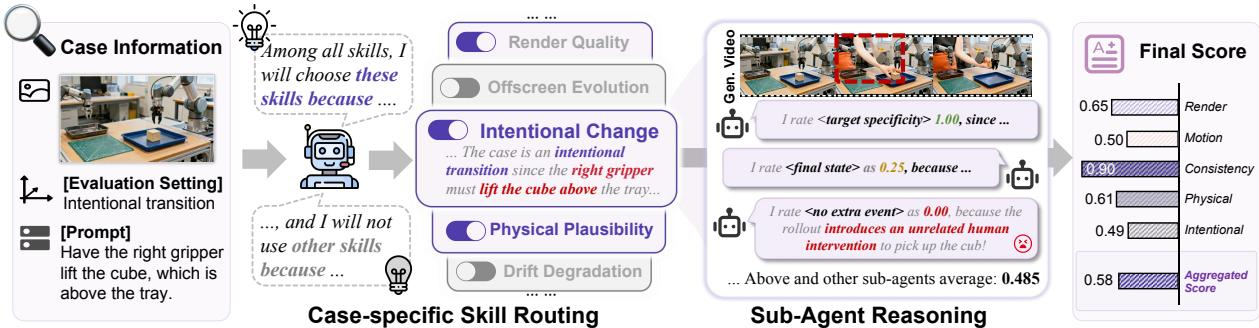
แทนที่จะบังคับให้ทุกเคสวิ่งผ่าน checklist เดิม HarnessEval ทำให้ “การประเมิน” มีลักษณะเป็น agentic workflow: ระบบอ่านบริบท วางแผน เลือกทักษะที่จำเป็น แยกโจทย์ย่อย หา evidence แล้วค่อยตรวจว่า evidence นั้นรองรับข้อสรุปจริงหรือไม่
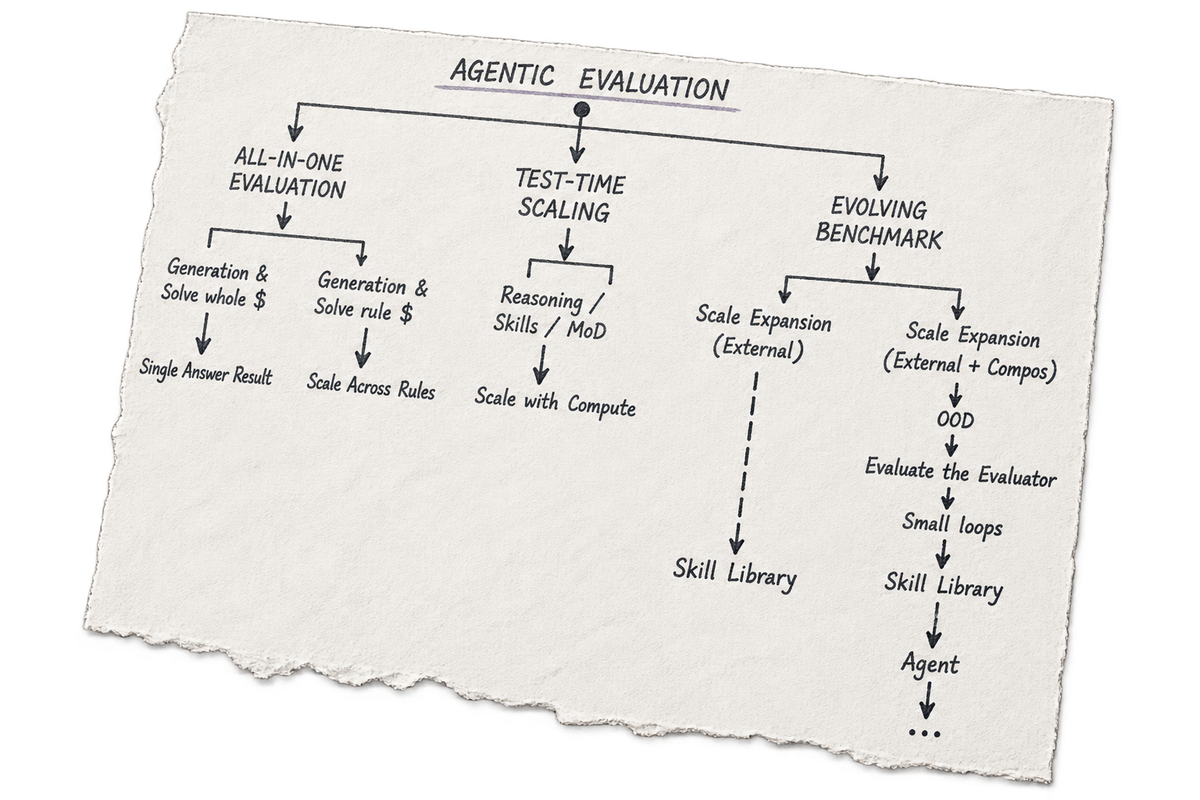
| แบบเดิม | HarnessEval |
|---|---|
| รันตัวชี้วัดชุดเดียว | เลือกวิธีตรวจให้ตรงเคส |
| ได้คะแนนปลายทาง | ได้ evidence tree และเหตุผล |
| รู้ว่าแพ้/ชนะ | เห็นจุดที่ต้องแก้ |
สี่ขั้นที่เห็นภาพทันที
1. Plan: อย่าเพิ่งวัด ถ้ายังไม่รู้ว่าจะพิสูจน์อะไร
ระบบตั้งแผนจากเป้าหมายและบริบทของเคส เช่น ต้องดูการยึดวัตถุ ความต่อเนื่องของสถานะ หรือความสัมพันธ์เหตุและผล ไม่ใช่โยนทุก metric ใส่ทุกงาน
2. Route และ Decompose: เลือกเครื่องมือ แล้วแยกงานให้เล็กพอจะตรวจ
Skill Library ทำหน้าที่เหมือนกล่องเครื่องมือ ช่างไม่ได้เอาประแจทุกอันไปใช้กับน็อตตัวเดียว การเลือก skill จึงเป็นส่วนหนึ่งของคุณภาพการประเมิน จากนั้นโจทย์ใหญ่ถูกแตกเป็นคำถามที่ตรวจได้จริง
3. Verify: หลักฐานไม่ใช่แค่มี แต่ต้องโยงกับข้อสรุป
ขั้นสุดท้ายตรวจทั้งคุณภาพของข้อมูลและตรรกะของการสรุป นี่สำคัญมาก เพราะ AI สามารถอธิบายได้คล่อง แต่คำอธิบายที่ฟังดีไม่เท่ากับหลักฐานที่ตรวจซ้ำได้
แล้วมันสำคัญกับใคร
สำหรับทีมสร้าง world model, หุ่นยนต์, เกม หรือ video generation ระบบนี้ช่วยเปลี่ยนคำถามจาก “รุ่นไหนคะแนนสูงกว่า” เป็น “รุ่นนี้ล้มเหลวแบบไหน และเราจะแก้จุดไหนก่อน” สำหรับคนใช้ AI ทั่วไป บทเรียนก็ตรงตัว: อย่าดูแค่คะแนน benchmark หรือเดโมหนึ่งคลิป ให้ดูวิธีทดสอบ เงื่อนไข และหลักฐานที่รองรับด้วย
สิ่งที่ยังต้องจับตา
ความละเอียดของ workflow ไม่ได้แปลว่าคำตอบถูกเสมอ HarnessEval ยังขึ้นกับคุณภาพของ skill, ข้อมูลที่ป้อน และเกณฑ์ verify ที่ออกแบบไว้ ระบบที่อธิบายได้อาจยังมี blind spot ได้เหมือนกัน นี่จึงควรถูกมองเป็นเครื่องมือทำให้การถกเถียงโปร่งใสขึ้น ไม่ใช่ตราประทับความจริงอัตโนมัติ
3 เรื่องที่ควรจำ
- คะแนนอย่างเดียวไม่พอ เมื่อโจทย์มีเหตุและผลซับซ้อน
- วิธีประเมินต้องปรับตามเคส ไม่ใช่ใช้ checklist เดิมกับทุกอย่าง
- Evidence Tree ทำให้แก้งานได้ เพราะเห็นเส้นทางจากหลักฐานไปถึงข้อสรุป
HarnessEval จึงน่าสนใจไม่ใช่เพราะมันเพิ่มคำว่า agent เข้าไปใน benchmark แต่เพราะมันถามสิ่งที่วงการ AI ต้องถามมากขึ้นเรื่อย ๆ: ถ้าจะเชื่อผลประเมิน เราเห็นกระบวนการมากพอหรือยัง?
อ้างอิง: MirroS, GitHub: HarnessEval-W และ AI工具集.
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!