
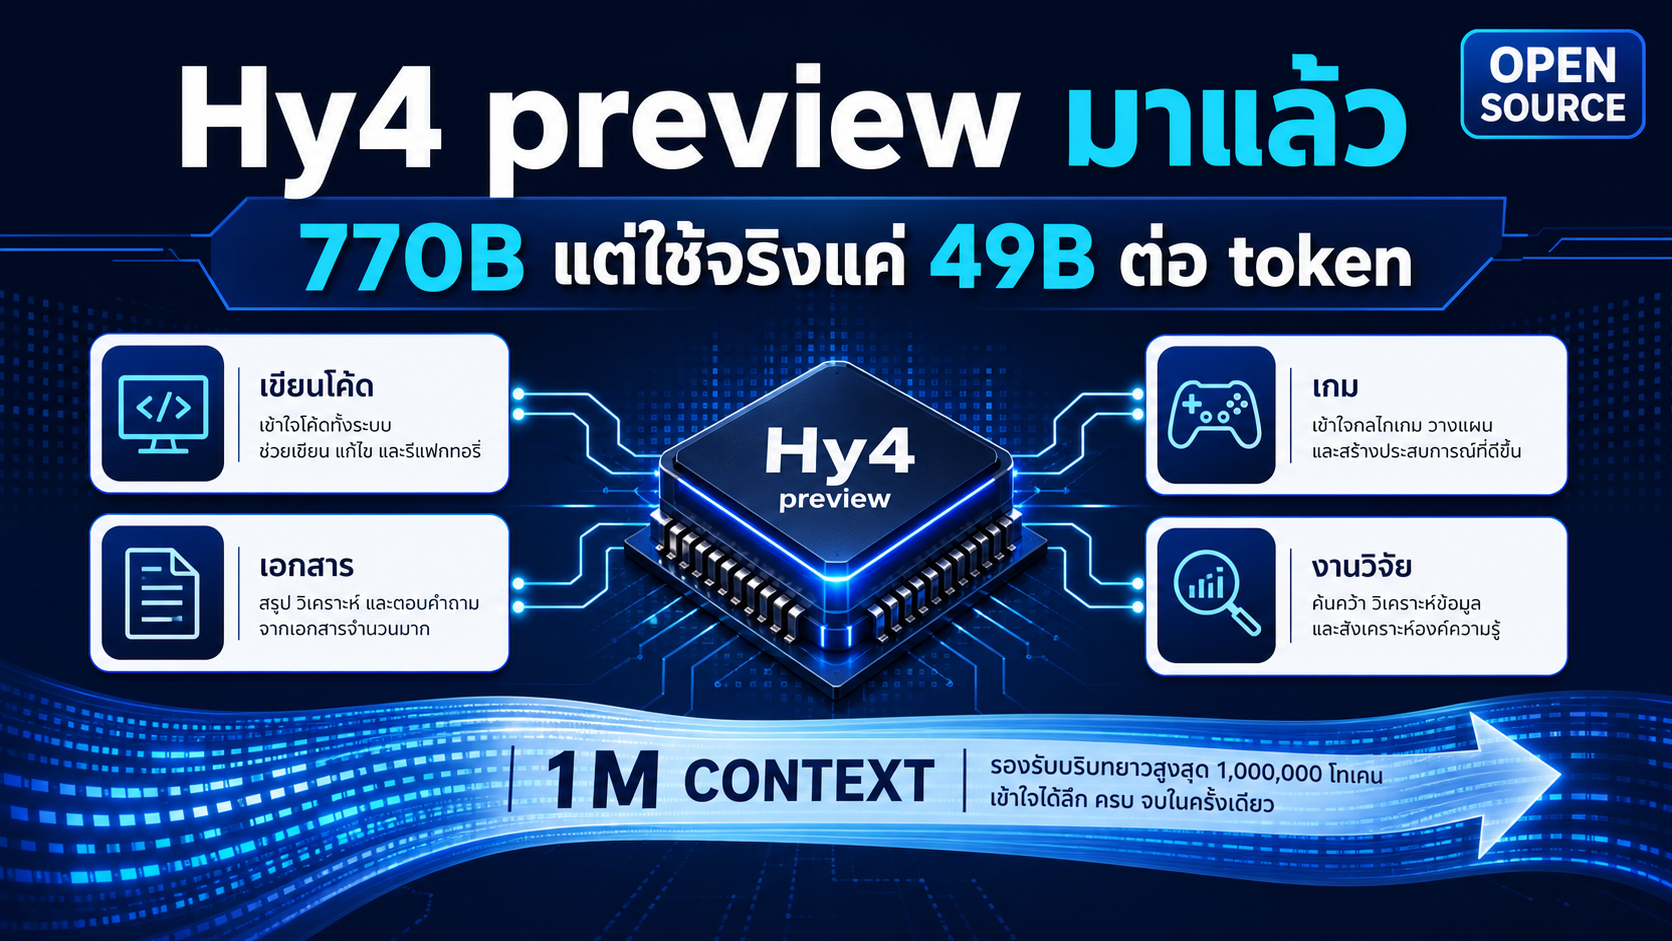
โมเดลใหญ่ขึ้น ไม่ได้แปลว่าต้องเผาเครื่องมากขึ้นทุกคำตอบเสมอไป นี่คือแกนที่น่าสนใจที่สุดของ Hy4 preview โมเดลโอเพนซอร์สรุ่นใหม่จาก Tencent Hy Team: มีพารามิเตอร์รวม 770B แต่เลือกใช้เพียง 49B ต่อ token และเปิด context ได้ถึง 1M token
ตัวเลขเหล่านี้ฟังดูไกลตัว แต่แปลเป็นภาษาคนทำงานได้ว่า โมเดลนี้ถูกวางเป้าให้รับงานยาว งานหลายไฟล์ และงานที่ต้องคิดต่อเนื่อง เช่น อ่านโค้ดทั้งโปรเจกต์ สรุปเอกสารจำนวนมาก หรือค่อย ๆ พัฒนาเกมต้นแบบ ไม่ใช่แค่ตอบคำถามสั้น ๆ ให้จบในครั้งเดียว
Hy4 preview คืออะไร
Hy4 preview เป็นโมเดลภาษาแบบ Mixture-of-Experts หรือ MoE ที่ Tencent เปิดทั้งโค้ดและน้ำหนักโมเดลภายใต้ Apache 2.0 โมเดล MoE เปรียบเหมือนทีมผู้เชี่ยวชาญจำนวนมากที่ไม่ได้ถูกเรียกมาทำงานพร้อมกันทุกคน: ตอนรับแต่ละ token ระบบจะเลือกผู้เชี่ยวชาญที่เกี่ยวข้องมาช่วย จึงตั้งเป้าให้ได้ความจุของโมเดลใหญ่ โดยไม่ต้องเปิดใช้พารามิเตอร์ทั้งหมดทุกครั้ง
| สเปกที่ประกาศ | ความหมายแบบใช้งานจริง |
|---|---|
| 770B total / 49B activated | โมเดลมีความจุสูง แต่เส้นทางคำนวณต่อ token เล็กกว่าขนาดรวม |
| 1M context | เหมาะกับงานที่ต้องถือข้อมูลยาวมากไว้ในบทสนทนาเดียว |
| 78 layers, 256 routed experts | เป็นสถาปัตยกรรม MoE ขนาดใหญ่มาก ไม่ใช่โมเดลเล็กที่รันเครื่องทั่วไปได้สบาย |
| Apache 2.0 | เปิดทางให้ศึกษา ดัดแปลง และนำไปต่อยอดตามเงื่อนไขไลเซนส์ |
ทำไม 770B แต่ใช้จริง 49B ถึงสำคัญ
คำว่า “770B” บอกขนาดความรู้และความจุรวม แต่ยังไม่บอกต้นทุนต่อคำตอบ การมี 49B activated parameters คือแนวคิดว่าในแต่ละจังหวะ โมเดลจะเปิดใช้เพียงผู้เชี่ยวชาญที่คิดว่าเกี่ยวข้อง อย่างไรก็ดี อย่าแปลว่าโมเดลจะเล็กหรือถูกทันที: การเสิร์ฟโมเดลระดับนี้ยังต้องใช้ฮาร์ดแวร์และการกระจายงานหลาย GPU ตามคู่มือทางการ
เอกสารระบุอีกชั้นหนึ่งคือ native MTP สำหรับ speculative decoding ซึ่งช่วยให้ระบบลองคาดเดา token ถัดไปล่วงหน้า และใช้โครงสร้าง attention แบบ sparse เพื่อลดงานที่ไม่จำเป็นใน context ยาว ๆ ทั้งหมดนี้คือเหตุผลที่ข่าวไม่ได้มีแค่ตัวเลขพารามิเตอร์ใหญ่ แต่มีคำถามเรื่อง “ทำให้โมเดลใหญ่ตอบได้เร็วและคุ้มขึ้นอย่างไร” อยู่ข้างใน
1M context ใช้กับใครได้บ้าง
1 ล้าน token ไม่ได้หมายความว่าควรยัดทุกไฟล์ลงไปเสมอ แต่มีประโยชน์มากเมื่อเราต้องรักษาบริบทให้ต่อเนื่อง ตัวอย่างเช่น
- ทีมโค้ด: อ่านโครงสร้างโปรเจกต์หลายโมดูล ช่วยวางแผน แก้บั๊ก และตรวจงานต่อเนื่อง
- งานเอกสารและการเงิน: รวมไฟล์ กระดาษทำการ ตาราง และข้อกำหนด เพื่อสรุปเป็นเอกสารส่งต่อ
- เกม: ต่อยอด prompt เดียวไปเป็น prototype แล้วคุยแก้รายละเอียดต่อหลายรอบ
- งานวิจัย: เก็บ paper โน้ต และผลการทดลองให้อยู่ในบริบทเดียวกันก่อนตั้งสมมติฐาน
ผลที่ Tencent รายงาน: น่าสนใจ แต่ต้องอ่านอย่างระวัง
ทีมพัฒนาบอกว่า Hy4 preview ถูกสร้างร่วมกับผู้เชี่ยวชาญด้านซอฟต์แวร์ เกม การเงิน และความปลอดภัย และรายงานการ blind side-by-side ภายในองค์กร 203 งาน โดยผู้เชี่ยวชาญ 163 คนให้คะแนนเฉลี่ย 2.99/4.00 เทียบกับ GLM 5.3 ที่ 2.92 และ Kimi K3 ที่ 2.94
นี่เป็นสัญญาณเชิงบวกสำหรับงานผลิตจริง แต่ยังเป็นการประเมินภายในของผู้พัฒนา ไม่ควรเหมารวมว่าเหนือกว่าทุกโมเดลในทุกโจทย์ หากกำลังตัดสินใจใช้ในองค์กร ควรลองกับชุดงานของตัวเอง: โค้ดจริง เอกสารจริง และเกณฑ์คุณภาพ/ต้นทุนที่ทีมยอมรับได้
โมเดลที่เก่งบน benchmark อาจไม่ใช่โมเดลที่เหมาะกับ pipeline ของเราเสมอไป การทดลองเล็ก ๆ ที่วัดได้สำคัญกว่าการดูอันดับเพียงอย่างเดียว
สถานะ “preview” หมายความว่าอะไร
ชื่อรุ่นไม่ใช่แค่การตลาด เอกสารทางการบอกตรง ๆ ว่ายังเป็นเวอร์ชันต้น มีช่องว่างให้พัฒนาทั้ง pre-training และ post-training และยอมรับข้อจำกัด เช่น ใช้เวลาคิดนานเกินจำเป็นในงานซับซ้อน หรือมีแนวโน้มตรวจคำตอบตัวเองมากเกินไป
ดังนั้นคนที่อยากทดลองควรเริ่มจากงานที่วัดผลได้ชัด ไม่ควรปล่อยให้ตัดสินใจเรื่องสำคัญโดยไม่มีคนตรวจ และควรเผื่อเวลา/งบสำหรับการใช้งาน reasoning mode ที่อาจยาวกว่าการตอบทั่วไป
เริ่มใช้ได้อย่างไร
มีน้ำหนักโมเดลทั้งรุ่นปกติและรุ่น FP8 บน Hugging Face พร้อมแนวทางเสิร์ฟผ่าน vLLM หรือ SGLang API ที่ใช้งานแบบ OpenAI-compatible ได้ ตัวอย่างแนวคิดคือเสิร์ฟโมเดลในระบบของเรา แล้วเรียก chat completions ผ่าน endpoint ภายใน
client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
response = client.chat.completions.create(
  model="hy4-preview",
  messages=[{"role": "user", "content": "สรุปเอกสารนี้ให้หน่อย"}]
)
แต่ deployment ตัวอย่างทางการใช้ tensor parallel size 8 จึงเป็นสัญญาณชัดว่า self-host ไม่ใช่ปุ่มกดครั้งเดียวสำหรับเครื่องส่วนตัว ทางเลือกที่สมจริงกว่าอาจเป็นการทดลองผ่านผู้ให้บริการ API หรือใช้ endpoint ของทีมก่อน แล้วค่อยประเมินว่าคุ้มจะดูแลระบบเองหรือไม่
สรุป: ข่าวนี้สำคัญตรงไหน
- ขนาดกับต้นทุนเริ่มแยกจากกันมากขึ้น: MoE 770B/49B คือความพยายามเอาความสามารถของโมเดลใหญ่มาอยู่บนเส้นทางคำนวณที่ใช้งานได้มากกว่า
- เป้าหมายคือ workflow ยาว: 1M context และการชูงานโค้ด/เอกสาร/เกม บอกว่า Tencent อยากแข่งในงานหลายขั้นตอน
- โอเพนซอร์สทำให้ตรวจสอบได้: มีทั้ง weights, code และเอกสาร deployment แต่คำว่า preview เตือนว่าควรทดสอบกับงานจริงอย่างมีวินัย
ติดตามข้อมูลต้นทางได้ที่ GitHub ของ Hy4 preview, Hugging Face และ หน้าโครงการ Tencent
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!