
เคยไหมที่อยากสร้างวิดีโอ AI สักชิ้น แต่พอเขียน prompt ไปแล้วต้องรอเป็นสิบวินาที ค่อยได้คลิปออกมา แล้วถ้าอยากให้ภาพขยับต่อจากเดิมก็ต้องเริ่มใหม่? วันนี้มีโมเดลที่เรียกตัวเองว่า "โลกจำลอง" (world model) ที่ทำให้เรื่องนั้นเปลี่ยนไป — คุณพิมพ์ บอก เลื่อน แล้วภาพกับเสียงไหลออกมาแบบเรียลไทม์ ราวกับคุณไม่ได้สั่ง AI แต่งคลิป แต่กำลังเข้าไปอยู่ในโลกที่คิดแทนคุณ
โมเดลที่ว่านี้คือ PixVerse R2 จาก 爱诗科技 (Aishi Technology / PixVerse) ซึ่งเพิ่งเปิดเผยตัวเลขและแนวคิดทางเทคนิคผ่านการเผยแพร่รายงานเมื่อช่วงปลายเดือน ส.ค. 2026 — และมันคือเวอร์ชันต่อยอดของ PixVerse R1 ที่เปิดตัวเมื่อมกราคม 2026 ในฐานะ real-time world model ตัวแรกของโลก
โจทย์ของ R2 ไม่ใช่แค่ "สร้างวิดีโอให้สวยขึ้น" แต่คือ "สร้างโลกที่จำได้ต่อเนื่อง และตอบสนองเราตลอดเวลา" — แล้วมันก็เลือกตอบว่าได้
ฟังดูเว่อร์ใช่มั้ย? ผมจะพาคุณไล่ทีละชั้นว่า R2 ทำตัวเลข "35.8%" ที่เป็นข่าวขึ้นมาได้ยังไง และทำไมถึงเป็นจุดเริ่มต้นของยุคที่วิดีโอ AI เปลี่ยนจาก "การสร้างคลิป" เป็น "การสร้างโลก"
PixVerse R2 คืออะไร
PixVerse R2 คือโมเดล real-time full-modality world model — โมเดลที่รับอินพุตหลากหลายโหมดพร้อมกัน แล้วเอาท์พุตเป็น วิดีโอ + เสียง ที่เดินพร้อมกันแบบต่อเนื่อง (stream) อินพุตที่ว่ารวมถึงข้อความ คำสั่งเสียง ภาพ/วิดีโออ้างอิง และแม้แต่ สัญญาณการเคลื่อนไหวแบบ WASD ที่ใช้ควบคุมในเกม
จุดต่างสำคัญจากโมเดลวิดีโอทั่วไปคือ "ระหว่างที่มันสร้าง มันยังรับคำสั่งจากคุณได้เรื่อย ๆ" — คุณไม่ต้องรอให้จบแล้วค่อยสั่งใหม่ แต่ควบคุมทิศทางของโลกได้ขณะสร้างไปด้วย นี่คือสิ่งที่ทำให้มันเป็น "โลก" ไม่ใช่ "คลิป"
ภาพปกบล็อก PixVerse R2 ทางการ (ที่มา: pixverse.ai)
"โลกจำลอง" ต่างจาก "คลิปวิดีโอ" ตรงไหน
คิดภาพง่าย ๆ ตามนี้นะครับ:
- วิดีโอ AI แบบเดิม = ผลลัพธ์ที่ "จบแล้ว" — คุณได้คลิปสั้น ๆ มาหนึ่งชิ้น อยากต่อก็ต้องเริ่มโปรเซสใหม่
- โลกจำลองแบบ R2 = กระแสที่ "เดินต่อไปเรื่อย ๆ" — มันสร้างคอนเทนต์ต่อเนื่อง ขยายฉากไปได้เรื่อย และตอบสนองตามที่คุณทำ
เปรียบเหมือนเกมที่คุณเข้าไปเล่น แล้วฉากต่าง ๆ ถูกสร้างให้ตรงกับที่คุณทำ ไม่ใช่ฉากที่ตัดต่อไว้ล่วงหน้า — นี่คือเหตุผลที่บริษัทเรียกมันว่า entering a world ที่ไม่มีอยู่จริงก่อนที่คุณจะเข้าไป
และถ้าเทียบกับโมเดลวิดีโอทั่วไปที่โฟกัส "ความสวยของเฟรม" R2 ยอมแลกมาที่ "ความต่อเนื่อง + การโต้ตอบ" ซึ่งเป็นสิ่งที่ hard กว่ามาก เพราะต้องรักษาตัวละคร ฉาก และเสียงให้คงเส้นคงวาตลอดระยะยาว
เทคนิคเบื้องหลัง: รวมทุกอย่างเป็น 2 ชั้นหลัก
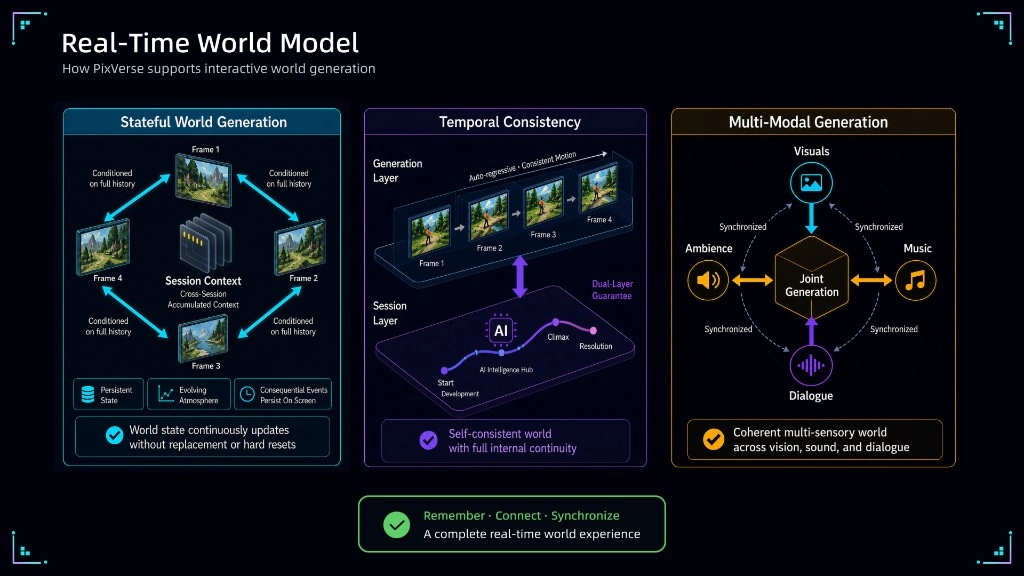
ทีมผู้พัฒนารวมโครงสร้างทั้งหมดของ R2 ไว้ใน 2 ชั้น คือ Omni Causal AR (ทำ Scaling ความสามารถ) กับ Real-Time Acceleration (ทำให้เร็วพอจะโต้ตอบได้ทันใจ) — แนวคิดคือ ชั้นแรกขยายศักยภาพให้กว้าง/ยาว/หลายโหมด จากนั้นชั้นที่สอง "กลั่น" ศักยภาพนั้นลงมาให้รันได้แบบเรียลไทม์โดยเสียคุณภาพน้อยที่สุด
รายละเอียดทางเทคนิคที่โดดเด่น (แปลจากรายงาน) มีราวนี้:
- Dynamic block generation — ตัดชิ้นวิดีโอ/เสียงตาม "จังหวะ" ของคำสั่งควบคุม: ชิ้นสั้นตอบสนองเร็ว ชิ้นยาวเก็บโครงเรื่อง/อารมณ์ครบ ทำให้ควบคุมและสร้างเรื่องยาว ๆ ไปพร้อมกัน
- Mixed teacher-forcing + diffusion-forcing — ฝึกด้วยทั้งประวัติที่ "สะอาด" และประวัติที่ "มีสัญญาณรบกวน" ปนกัน ทำให้โมเดลไม่พังเวลาประวัติเบี้ยวไปเล็กน้อย นี่คือหัวใจที่ทำให้เล่นยาว ๆ ได้เสถียร
- Multi-time-scale memory — ความจำ 3 ระดับทำงานร่วมกัน: Sink Memory (เก็บจุดยึดระยะยาว), Rolling History (จดจำสิ่งที่เพิ่งเกิดขึ้น), และ Object KV Cache (จำตัวละคร/วัตถุเฉพาะ) — เพื่อให้โลกไม่ลืมตัวละครหลักในฉาก
- Error Bank — เก็บประวัติการสร้างที่ผิดพลาดไว้แล้วเอากลับมาฝึกให้โมเดล "รู้จักแก้เอง" — ผลลัพธ์คือความสว่างที่ค่อย ๆ เบี่ยงเบน (brightness drift) ลดลงราว 35.8%
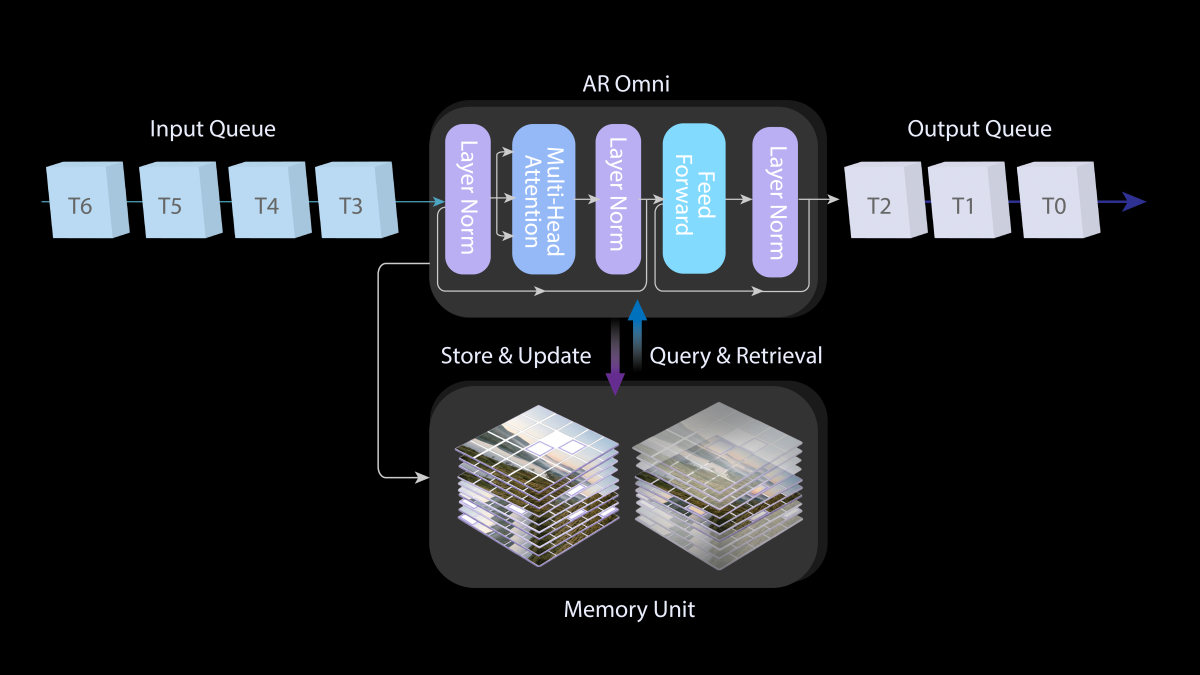
สถาปัตยกรรม Omni Causal AR / โลกจำลองเรียลไทม์ (ที่มา: pixverse.ai)
สำหรับการเร่งความเร็ว มี 2 กลไกสำคัญ:
- Block sparse attention — ลดการคำนวณให้เหลือเฉพาะส่วนที่สำคัญ ทำให้ "สัดส่วนความเบาบาง" ของ attention สูงเกิน 90% โดยผลลัพธ์แทบไม่เสีย — ปลดล็อกงบคำนวณสำหรับความละเอียดสูงขึ้น
- Pyramid ultra-few-step distillation — ใช้ความละเอียดต่ำกำหนดโครงสร้างภาพก่อน แล้วค่อยเพิ่มรายละเอียดแบบขั้นบันได ลดการทำงานซ้ำในพื้นที่ความละเอียดสูง
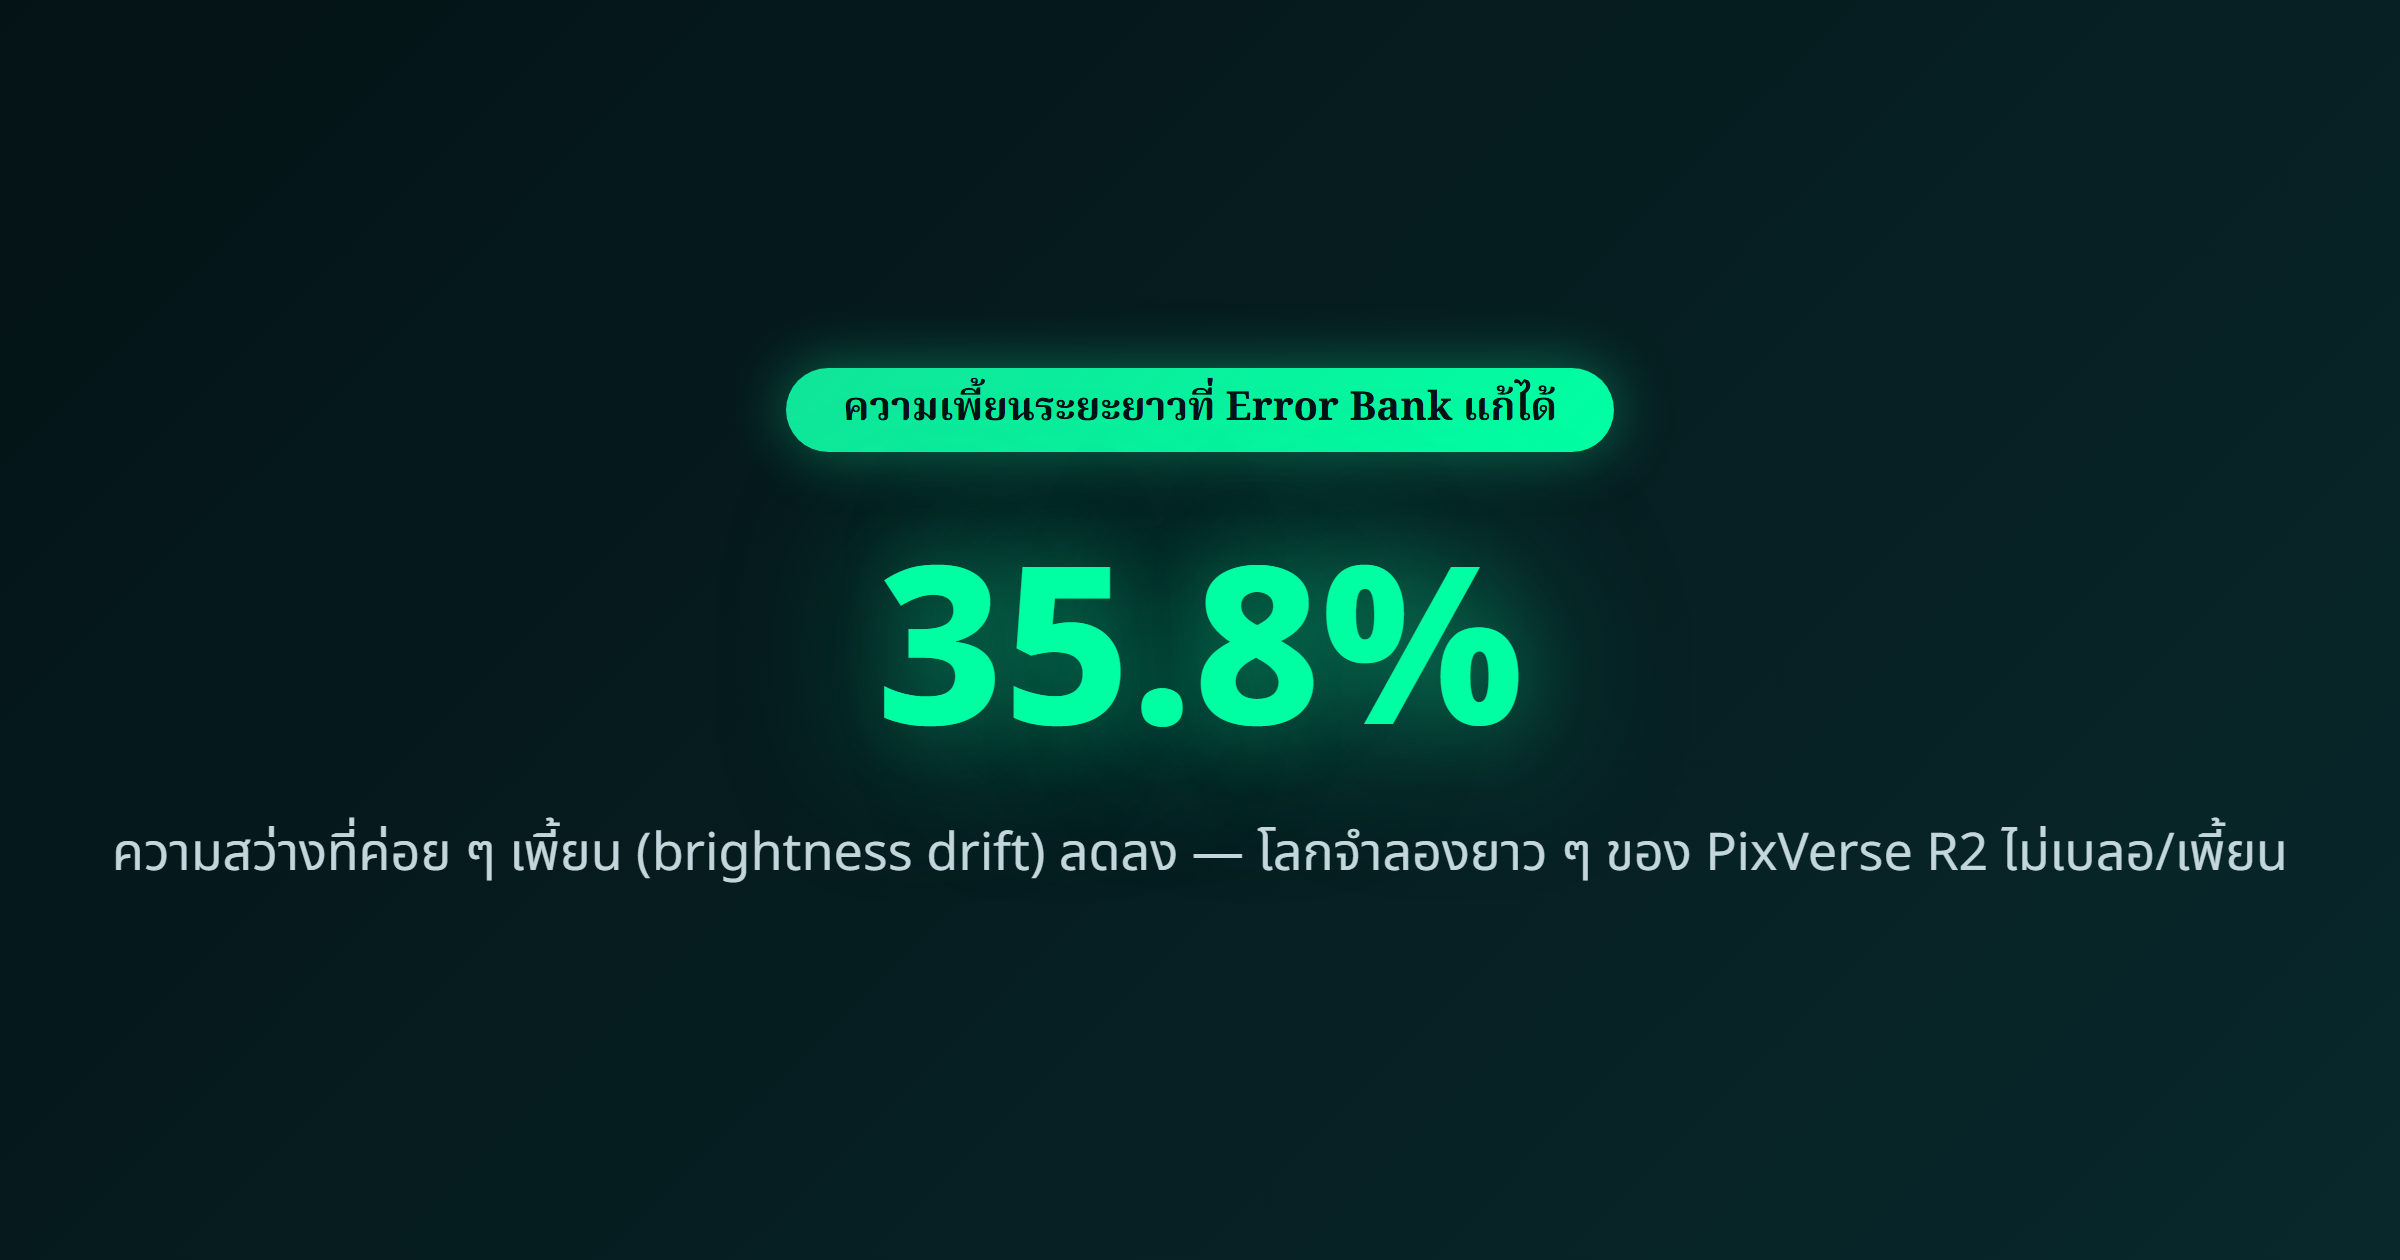
Error Bank ลดความสว่างที่เพี้ยนระยะยาวลง 35.8%
จาก R1 มาสู่ R2: อย่าลืมบริบท
รากของ R2 คือ R1 ที่ทาง PixVerse เปิดตัวเมื่อมกราคม 2026 ว่าเป็น real-time world model ตัวแรกของโลก และสร้างความต่างด้วยการเปลี่ยนวิดีโอจากการสร้างชิ้นเดียว เป็นการสร้างแบบ "สตรีมต่อเนื่องที่ตอบสนองทันที" จากนั้นในเดือนเม.ย. 2026 ก็เพิ่ม shared world และ avatar ส่วนตัวให้เข้าไปอยู่ในโลกเดียวกันแบบเรียลไทม์ แล้วพอมาเป็น R2 ก็ต่อยอดเรื่อง "ความจำระยะยาว + การแก้ความเพี้ยน" ให้แข็งแรงขึ้น
บริษัท PixVerse เองก็โตเร็วมาก — มีผู้ใช้กว่า 150 ล้านคนใน 177+ ประเทศ และเป็น Unicorn หลังระดมทุน Series C รวมราว 439 ล้านดอลลาร์ ในการขยายตัวด้าน interactive entertainment นี่จึงไม่ได้มาจากทีมเล็ก ๆ แต่เป็นทิศทางที่ลงทุนจริง
จาก R1 สู่ยุค 720p real-time (ที่มา: pixverse.ai)
เทียบ R2 กับคู่แข่งแบบเห็นภาพ
ในตลาด "โลกจำลองเรียลไทม์" ฝั่งจีนมีอีกชื่อที่น่าสนใจคือ Matrix-Game 3.0 ของ昆仑万维 (Kunlun) ซึ่งเน้นไปทาง AI game กับเวอร์ชวลเวิลด์ ตรงนี้เห็นดีไซน์ต่างกันชัดเจน:
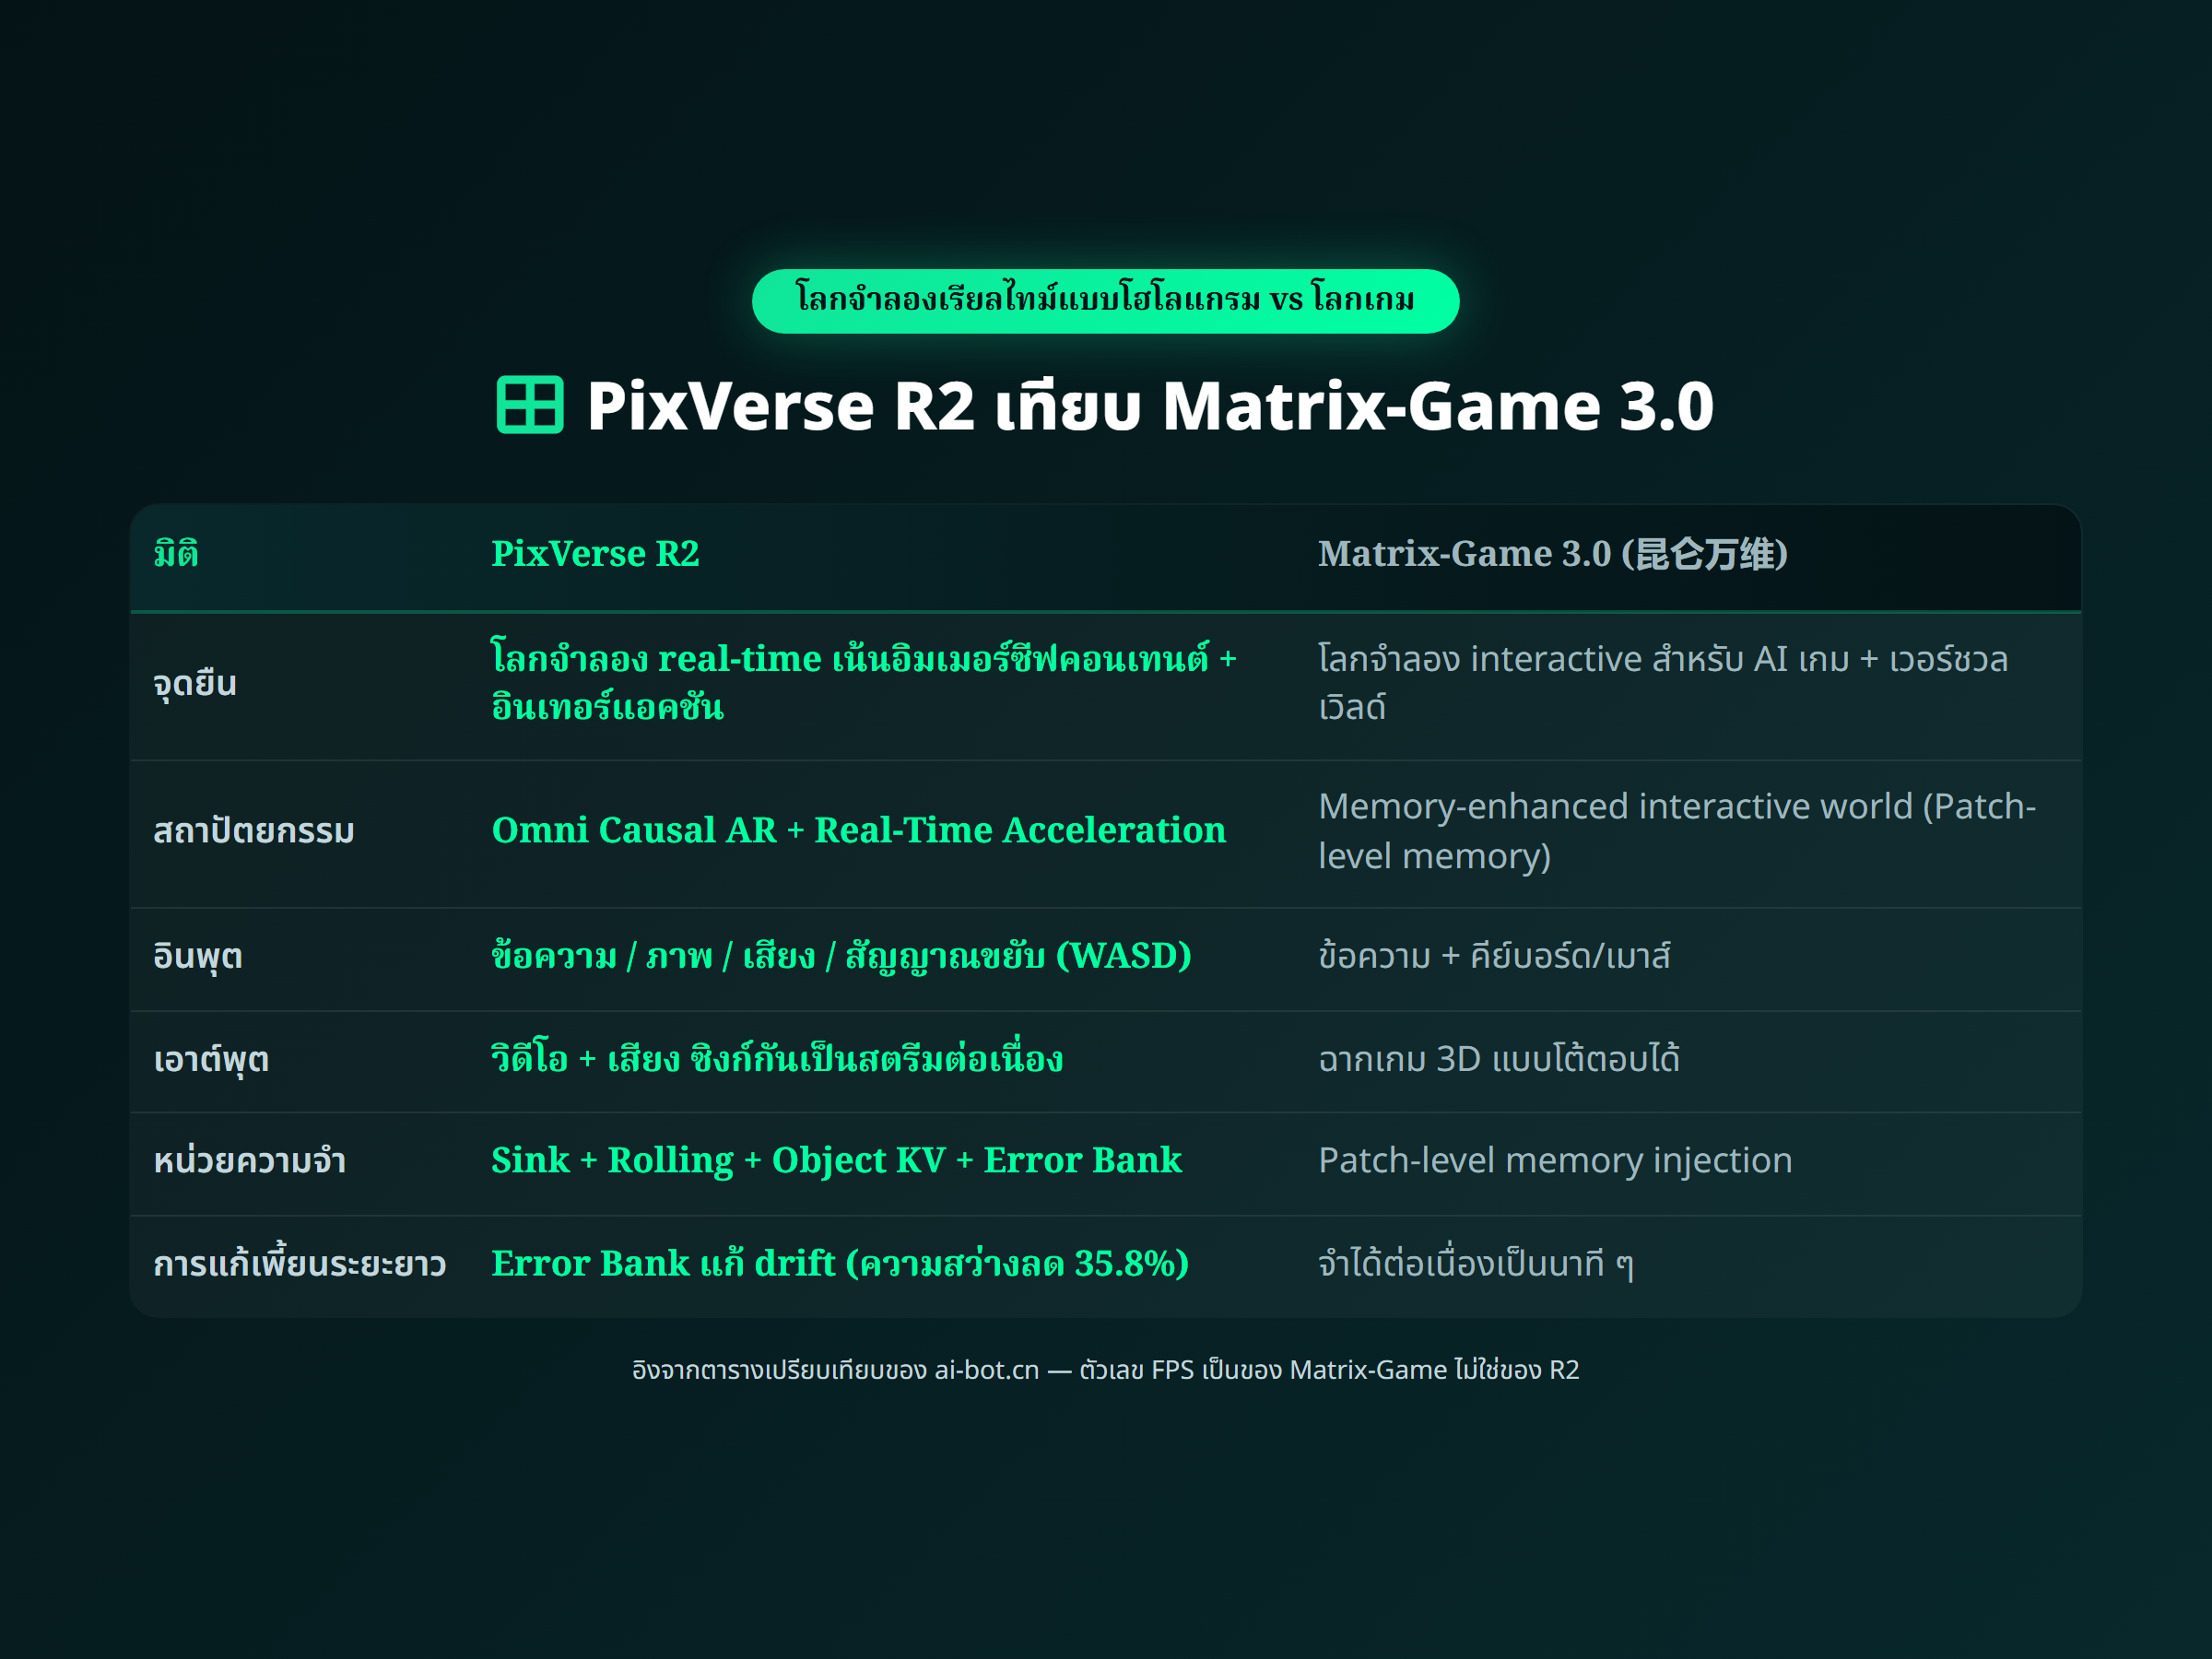
เทียบ PixVerse R2 กับ Matrix-Game 3.0 (Kunlun)
| มิติ | PixVerse R2 | Matrix-Game 3.0 (Kunlun) |
|---|---|---|
| จุดยืน | โลกจำลอง real-time เน้นอิมเมอร์ซีฟคอนเทนต์ + อินเทอร์แอคชัน | โลกจำลอง interactive สำหรับ AI เกม + เวอร์ชวลเวิลด์ |
| สถาปัตยกรรม | Omni Causal AR + Real-Time Acceleration | Memory-enhanced interactive world (Patch-level memory) |
| อินพุต | ข้อความ / ภาพ / เสียง / สัญญาณขยับ (WASD) | ข้อความ + คีย์บอร์ด/เมาส์ |
| เอาต์พุต | วิดีโอ + เสียง ซิงก์กันเป็นสตรีมต่อเนื่อง | ฉากเกม 3D แบบโต้ตอบได้ |
| หน่วยความจำ | Sink + Rolling + Object KV + Error Bank | Patch-level memory injection |
| การแก้เพี้ยนระยะยาว | Error Bank แก้ drift (ความสว่างลด 35.8%) | จำได้ต่อเนื่องเป็นนาที ๆ |
จะเห็นว่า R2 เลือกเค้า "สตรีมวิดีโอ+เสียง" ที่ให้ความรู้สึกเข้าถึงเนื้อหาและอารมณ์ได้จริง ขณะที่ Matrix-Game เลือกเค้า "โลกเกม 3D" ที่เน้นการสำรวจและปฏิสัมพันธ์เชิงพื้นที่ — คนละทางเลือกตามเป้าหมายของผลิตภัณฑ์
เอาของจริงไปใช้ทำอะไรได้บ้าง
นี่คือส่วนที่ผมสนุกที่สุด เพราะมันขยับจาก "โมเดลเท่ ๆ" มาเป็น "เครื่องมือที่แตะต้องได้":
- เกมและเวิร์ชวลเวิลด์แบบเรียลไทม์ — ผู้เล่นสั่ง WASD แล้วเห็นฉากและเสียงเปลี่ยนตามแบบฉับไว สร้างประสบการณ์เปิดโลกที่ลื่นไหลมาก
- พรีวิวภาพยนตร์ก่อนถ่ายจริง (pre-viz) — ผู้กำกับพิมพ์โปรย + ขยับมุมกลอง จะได้เห็นฉากพร้อมเสียงประกอบแบบคร่าว ๆ ทันที ลดการลองผิดลองถูกบนเซ็ตจริง
- ไลฟ์สตรีมกับตัวละครดิจิทัล — ดิจิทัลอวตารตอบแชท/เสียง/คำสั่งแบบเรียลไทม์ เปลี่ยนการรับชมเป็นการสร้างร่วมกัน
- โฆษณาและมาร์เก็ตติ้งแบบอินเทอร์แอคทีฟ — แบรนด์ใส่ภาพสินค้า + ข้อความสั้น แล้วได้หลายเวอร์ชันพร้อมเสียงประกอบในทันที เหมาะกับ A/B test ก่อนลงทุน
- การฝึกอบรมและจำลองสถานการณ์ — จำลองการผ่าตัด ขับรถ หรืองานฉุกเฉินที่ผู้เรียนสั่งการด้วยเสียง/อุปกรณ์ แล้วได้ภาพ+เสียงป้อนกลับ ให้ฝึกซ้ำได้โดยไม่เสี่ยงจริง
Game Engine — ควบคุมโลกจำลองด้วย WASD (ที่มา: pixverse.ai)
ข้อควรรู้: มันยังเป็นเวอร์ชันทดลอง และมีข้อจำกัดจริง
อย่าเพิ่งคาดหวังแบบ "เปิดใช้ได้เลย" — ตอนนี้ PixVerse R2 ยังอยู่ในช่วงทดสอบภายใน (inner test) ผู้สนใจต้องขอประเดิมกับทีมผ่านแบบฟอร์มเพื่อขอประสบการณ์และสิทธิ์เข้าถึง API
ที่สำคัญคือทีมผู้พัฒนาก็ยอมรับตรง ๆ ว่า คุณภาพการสร้างในแต่ละช็อต ยังเทียบไม่ได้กับโมเดลวิดีโอออฟไลน์ชั้นนำในเรื่องรายละเอียดฉากซับซ้อน ความเป็นธรรมชาติของการเคลื่อนไหว และเสถียรภาพระยะยาว — ซึ่งพวกเขามองว่านี่คือสิ่งที่สะท้อนว่าเราอยู่ระหว่าง "การต่อ Scaling" ไม่ใช่เพดานของสถาปัตยกรรม
ดังนั้นตัวเลข 35.8% และ >90% จึงควรอ่านในบริบทของ "แนวโน้มที่กำลังไป" มากกว่าคำประกาศชัยชนะ — แต่อย่างน้อยมันก็ชี้ว่าศัตรูหลักของโลกจำลองระยะยาวอย่าง "ความเพี้ยนสะสม" กำลังถูกโจมตีตรงจุดจริง
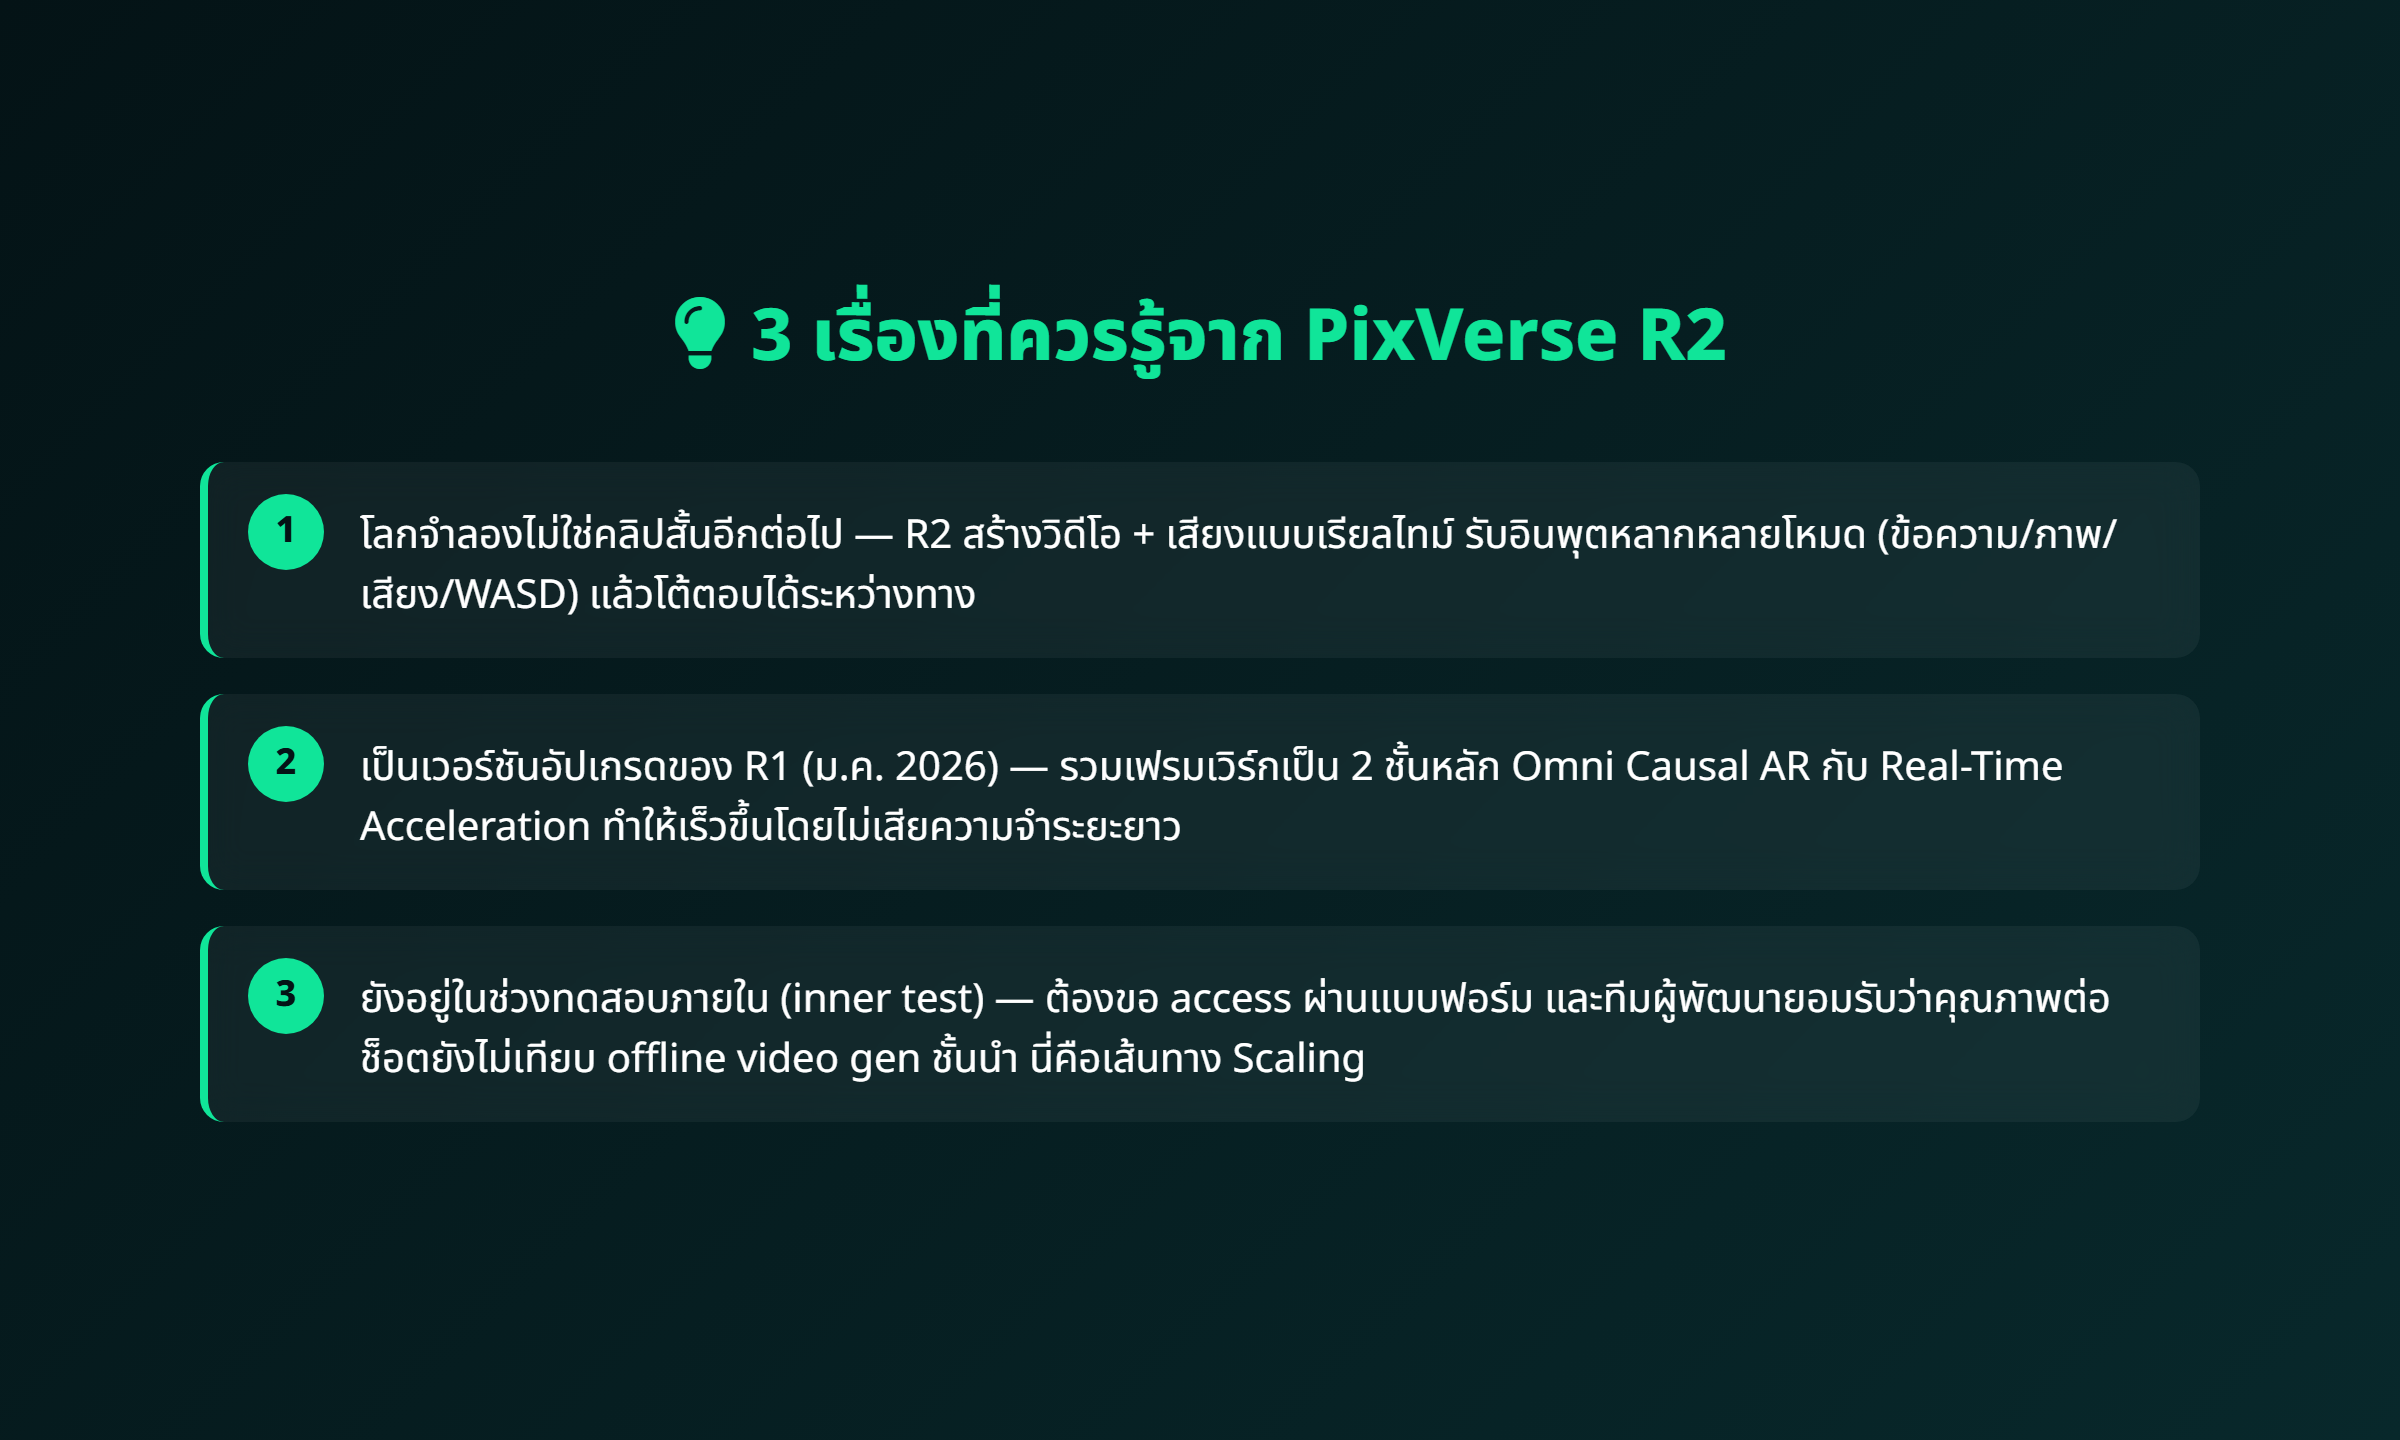
3 เรื่องที่ควรจำจาก PixVerse R2
สรุป 3 เรื่องที่ควรจำจาก PixVerse R2
- โลกจำลองไม่ใช่คลิปอีกต่อไป — R2 สร้างวิดีโอ + เสียงแบบเรียลไทม์ รับอินพุตหลายโหมด (ข้อความ/ภาพ/เสียง/WASD) แล้วโต้ตอบได้ระหว่างสร้าง
- สร้างจาก 2 ชั้นหลัก — Omni Causal AR กับ Real-Time Acceleration ให้ทั้งความสามารถกว้างและความเร็วแบบอินเทอร์แอคทีฟ โดยใช้ Error Bank + ความจำหลายระดับ (ความสว่าง drift ลดลง 35.8%)
- ยังเป็นเวอร์ชันทดลอง — ต้องขอเข้าถึงผ่านแบบฟอร์ม และทีมรับว่าคุณภาพต่อช็อตยังไม่เทียบ offline video gen ชั้นนำ — นี่คือเส้นทาง Scaling ไม่ใช่จุดจบ
ผมมองว่านี่คืออีกก้าวที่ทำให้ "ใคร ๆ ก็สร้างโลก" ใกล้ความเป็นจริงขึ้น — การได้แค่พิมพ์ บอก ขยับ แล้วได้ทั้งภาพและเสียงที่ต่อเนื่อง น่าจะเปลี่ยนวิธีที่เราเล่าเรื่อง ฝึกฝน และเล่นเกมไปอีกยาวเลยครับ
ที่มา: ai-bot.cn — PixVerse R2: 爱诗科技推出的实时全模态世界模型, PixVerse Blog — PixVerse R2: Scaling Real-Time Omni World Models, รายงานเทคนิค PixVerse R2 (ผ่าน AI观察, 25 ส.ค. 2026), PixVerse Series C Extension
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!