
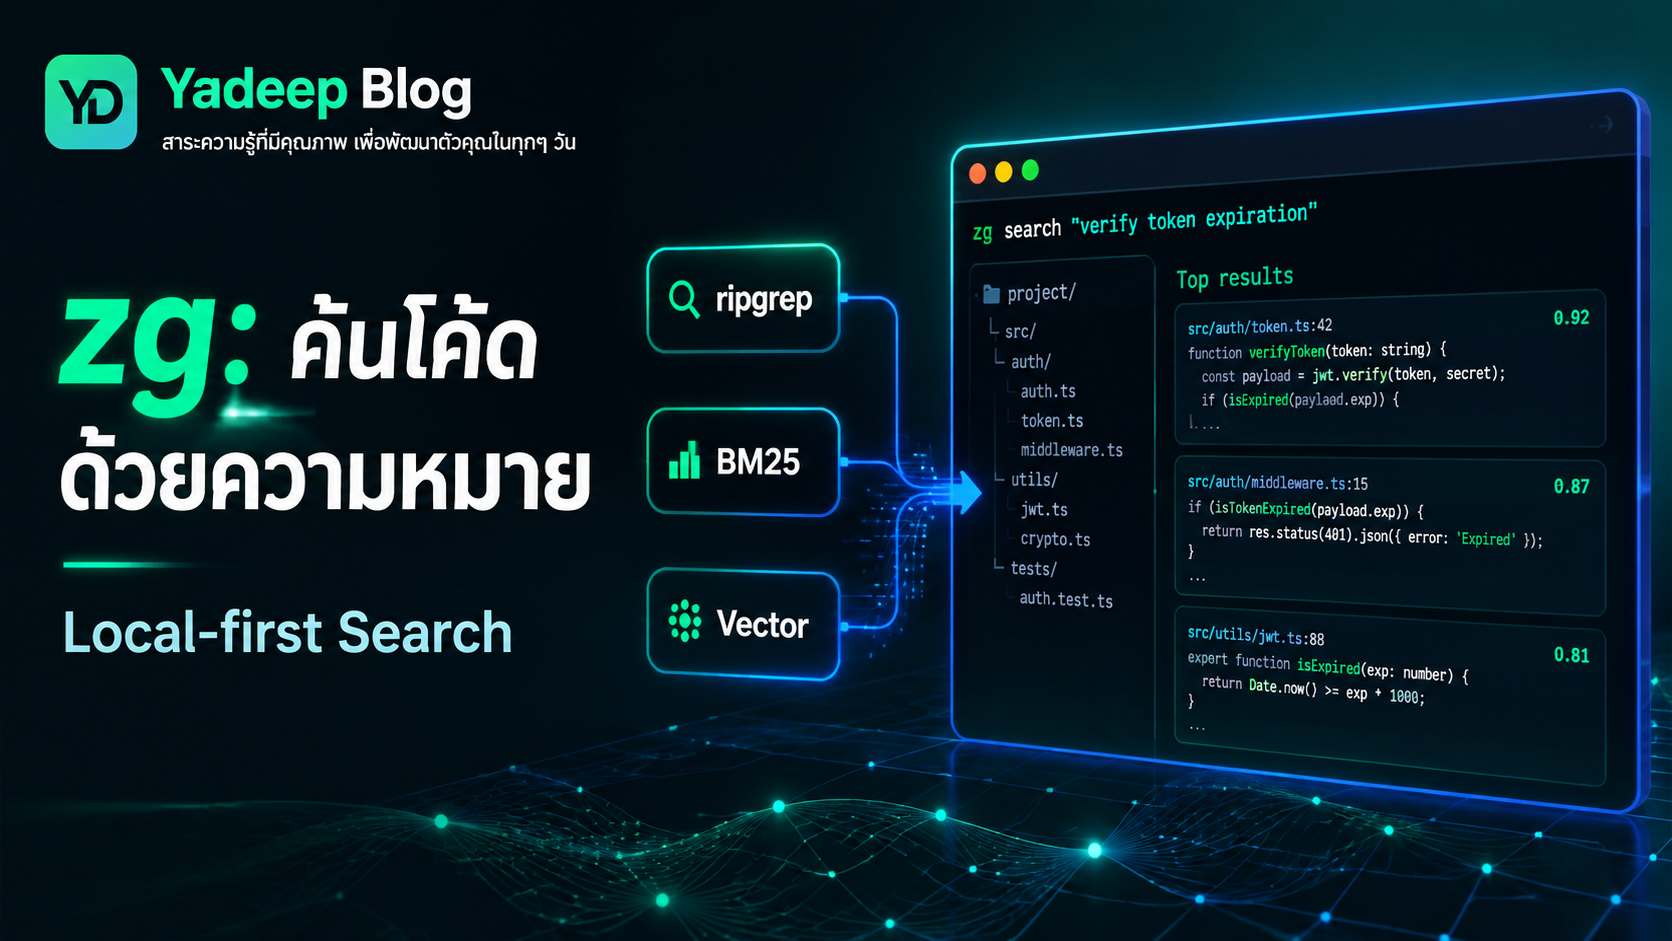
เคยรู้ไหมว่าโค้ดต้องทำอะไร แต่จำไม่ได้ว่าฟังก์ชันชื่ออะไร? นี่คือช่วงเวลาที่การพิมพ์ rg ตามด้วยคีย์เวิร์ดหลายรอบเริ่มกลายเป็นเกมทายใจ โดยเฉพาะเมื่อเราเข้ามาในโปรเจกต์ใหม่ หรือกำลังให้ AI agent ช่วยอ่าน codebase ขนาดใหญ่
ข่าวที่น่าสนใจคือ zg (zvec-grep) จาก Zvec AI เปิดซอร์สชั้นค้นหาแบบ local-first ที่รวมการค้นหาแบบ semantic, BM25 และ ripgrep ไว้ภายใต้เครื่องมือเดียว เป้าหมายไม่ใช่แทนที่ rg แต่ทำให้เราเริ่มจาก “สิ่งที่อยากหา” แล้วค่อยไปยืนยันด้วยข้อความหรือ regex ที่แม่นยำได้
ภาพจาก GitHub ของโครงการ zvec-grep: ชั้นค้นหาแบบ local-first สำหรับคนและ AI agent
zg ต่างจาก grep ตรงไหน?
ถ้ารู้ชื่อฟังก์ชัน เช่น hydratePreferences อยู่แล้ว ripgrep ยังเร็วและตรงมาก แต่ในชีวิตจริงเรามักเริ่มด้วยคำถามคลุมเครือ เช่น “โค้ดที่กู้ค่าธีมหลังเปิดแอปอยู่ตรงไหน?” ชื่อจริงในไฟล์อาจไม่ใกล้กับคำถามเลย
zg จึงวางเส้นทางค้นหาไว้หลายแบบ: semantic search ช่วยหาเนื้อหาที่มีความหมายใกล้กัน, BM25 ช่วยจัดอันดับจากคำศัพท์, และ ripgrep ใช้ตรวจข้อความหรือ regex แบบตรงตัว ผลลัพธ์คือเราไม่ต้องเลือกเครื่องมือใหม่ทุกครั้ง แค่เลือกเส้นทางให้เหมาะกับความรู้ที่มี
| สถานการณ์ | สิ่งที่เหมาะ | เหตุผล |
|---|---|---|
| รู้ชื่อ symbol หรือ error ชัดเจน | ripgrep | เร็ว ตรง และตรวจสอบซ้ำได้ง่าย |
| รู้คำสำคัญ แต่ต้องการเรียงผลลัพธ์ | BM25 | ให้ค่าน้ำหนักกับคำและบริบท |
| รู้แค่เจตนา ไม่รู้ศัพท์ในโค้ด | semantic search | เริ่มจากความหมายแทนชื่อ identifier |
| งานสืบค้นจริงใน codebase | hybrid ของ zg | รวมการค้นหาและลดรอบเดา |
Local-first มีความหมายกับทีมงานอย่างไร
จุดที่ผมว่าดีคือแนวคิดความเป็นส่วนตัวไม่ได้ถูกวางไว้เป็นป้ายการตลาดเฉย ๆ: การสแกนไฟล์, สร้าง embedding, ทำดัชนี และค้นหา ทำบนอุปกรณ์เป็นค่าเริ่มต้น ส่วน remote embedding เป็นทางเลือกที่ต้องอนุญาตอย่างชัดเจน
สำหรับทีมที่มีซอร์สโค้ดหรือเอกสารภายใน นี่ทำให้การเพิ่มความสามารถค้นหาด้วยความหมายไม่จำเป็นต้องเริ่มจากการส่งคลังงานทั้งก้อนไปยังบริการภายนอก
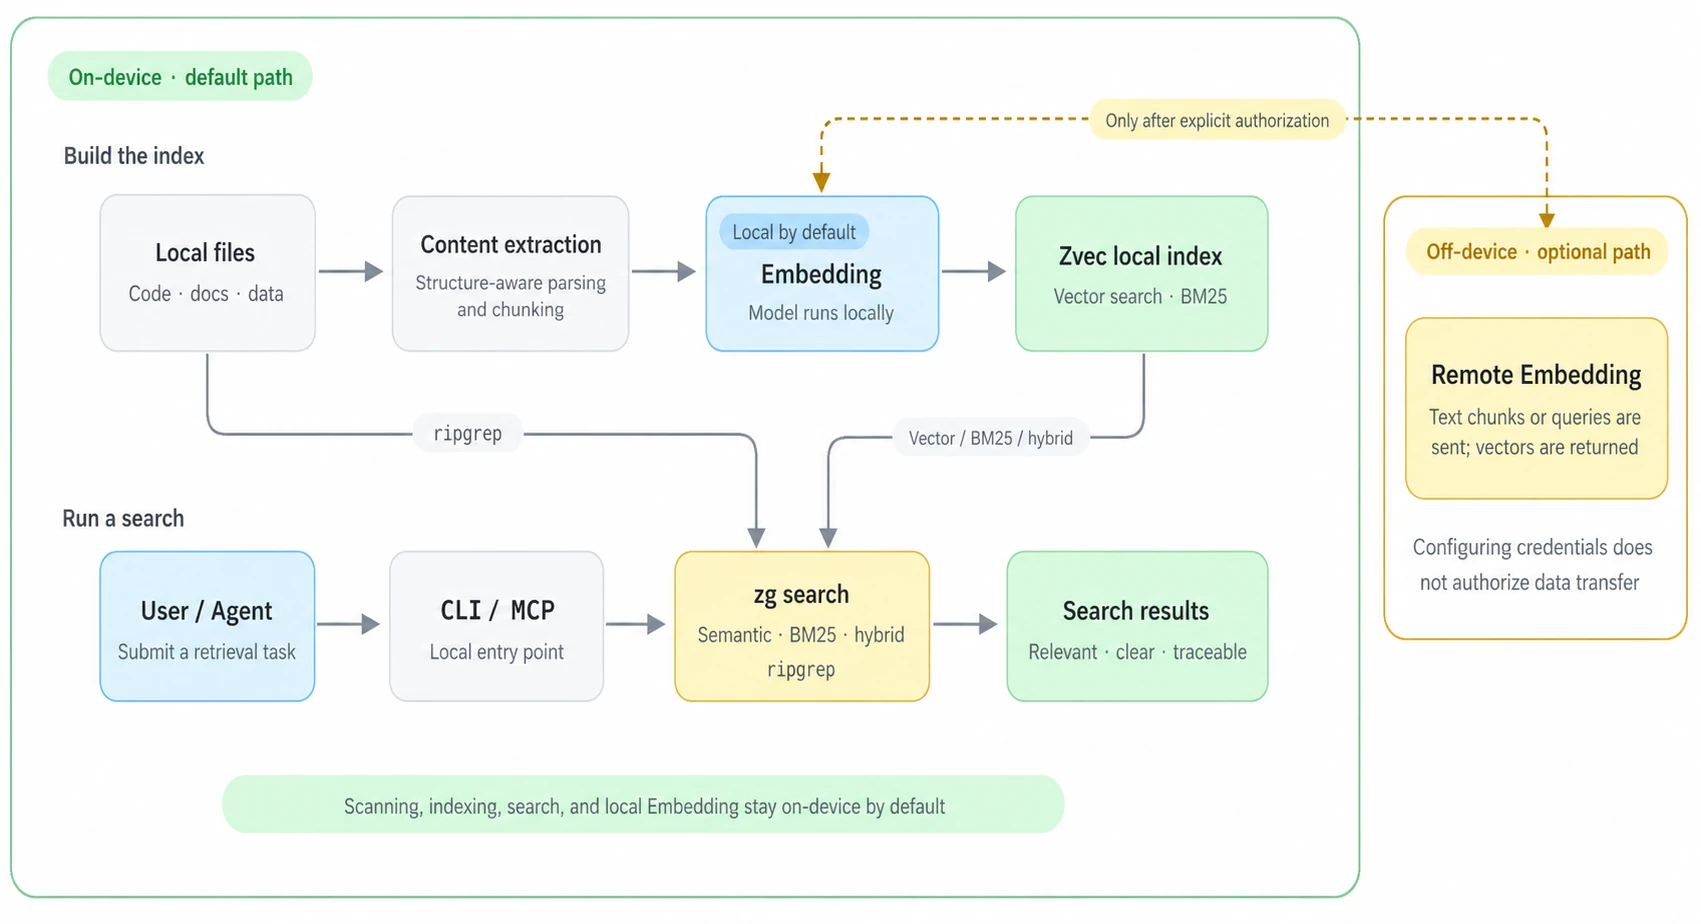
ภาพจาก Zvec: ขั้นตอนสร้างดัชนีและค้นหาที่ทำงานบนอุปกรณ์เป็นค่าเริ่มต้น
โครงการระบุว่ารองรับ code, documents และ structured data โดยยังเก็บโครงสร้างกับตำแหน่งต้นทางไว้ด้วย นั่นสำคัญกับ AI agent มาก เพราะคำตอบที่ดีไม่ควรแค่บอกว่า “เจอแล้ว” แต่ต้องชี้กลับมาที่ไฟล์และหลักฐานที่ตรวจได้
ติดตั้งและเริ่มต้นแบบสั้นที่สุด
ตามเอกสารทางการ ต้องใช้ Node.js 22 ขึ้นไป จากนั้นติดตั้ง CLI สร้างดัชนีใน root ของ workspace และค่อยค้นหา การสร้าง index ครั้งแรกย่อมมีต้นทุนเวลาและพื้นที่เก็บข้อมูล ดังนั้นมันเหมาะกับโปรเจกต์ที่เราจะกลับมาค้นซ้ำ มากกว่างานหา string ครั้งเดียวแล้วจบ
npm install -g @zvec/zvec-grep
cd your-repository
zg index --embedding local/potion-code-16m-v2
zg query --human "โค้ดที่กู้ค่าธีมของผู้ใช้"
ถ้าต้องการเชื่อมกับ agent จะมีคำสั่ง zg install สำหรับตั้งค่า integration และมี MCP server เป็นจุดเชื่อมต่อ นี่ทำให้คนกับ agent ใช้ดัชนี workspace เดียวกันได้ โดยไม่ต้องต่างคนต่างค้นจน context กระจัดกระจาย
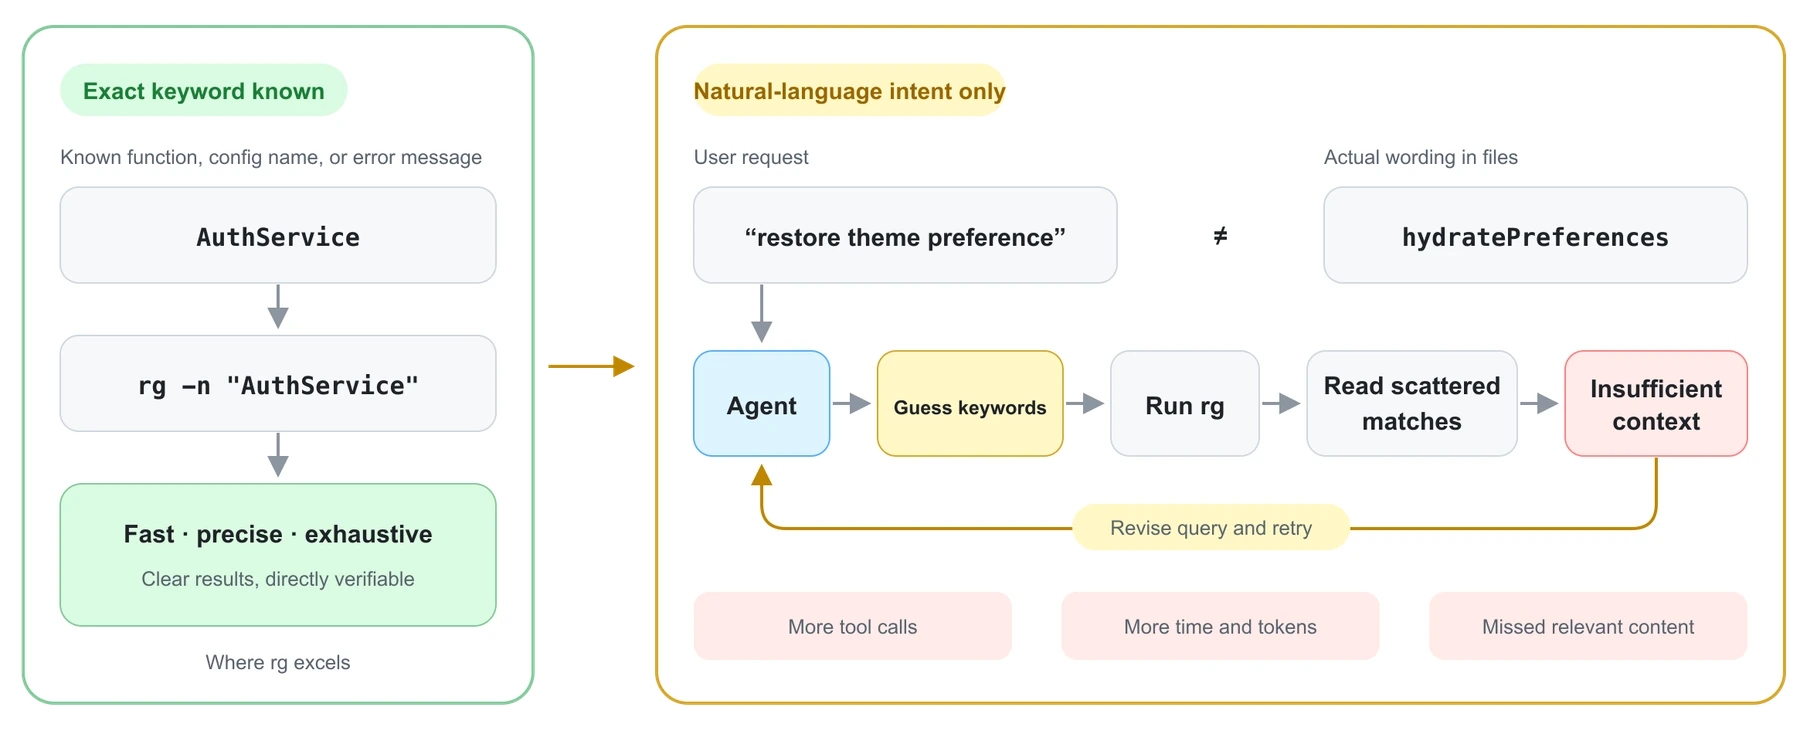
ภาพจาก Zvec: เมื่อไม่รู้ชื่อคีย์เวิร์ด การค้นหาตามเจตนาช่วยลดรอบเดาและไล่อ่านผลลัพธ์
อย่าเพิ่งเลิกใช้ rg
สิ่งที่ควรระวังคือ semantic search ไม่ใช่คาถาแก้ทุกอย่าง ถ้าคุณมีชื่อไฟล์, ชื่อ API หรือข้อความ error ที่ชัด การค้นหาแบบ exact ยังเป็นทางเลือกที่เร็วและโปร่งใสกว่า และเอกสาร benchmark ของโครงการเองก็เตือนว่าการบังคับให้ agent ใช้ semantic retrieval ทุกงานอาจทำให้ผลลัพธ์แย่ลงได้
3 เรื่องที่ควรจำ
- zg เป็นชั้นค้นหาแบบผสม ไม่ได้แข่งกับ ripgrep แบบแทนที่กัน แต่เพิ่ม semantic และ lexical retrieval ให้เลือกใช้
- local-first ช่วยลดความกังวลเรื่องข้อมูล เพราะไฟล์ ดัชนี และโมเดล local ทำงานบนเครื่องเป็นค่าเริ่มต้น
- คุ้มที่สุดเมื่อทำงานกับ codebase ซ้ำ ๆ โดยเฉพาะงานที่คนหรือ AI agent รู้ “ความหมาย” ของสิ่งที่หา แต่ไม่รู้ชื่อจริงในไฟล์
สำหรับคนที่ทำงานกับโค้ดขนาดใหญ่ ผมมองว่า zg น่าสนใจตรงที่มันพยายามทำให้การค้นหาเป็นกระบวนการเดียว ตั้งแต่ค้นจากเจตนา ไปจนถึงยืนยันด้วยหลักฐานแบบ exact ไม่ได้ทำให้การอ่านโค้ดหายไป แต่ช่วยให้เราเริ่มอ่านจากจุดที่น่าจะถูกต้องมากขึ้น
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!