
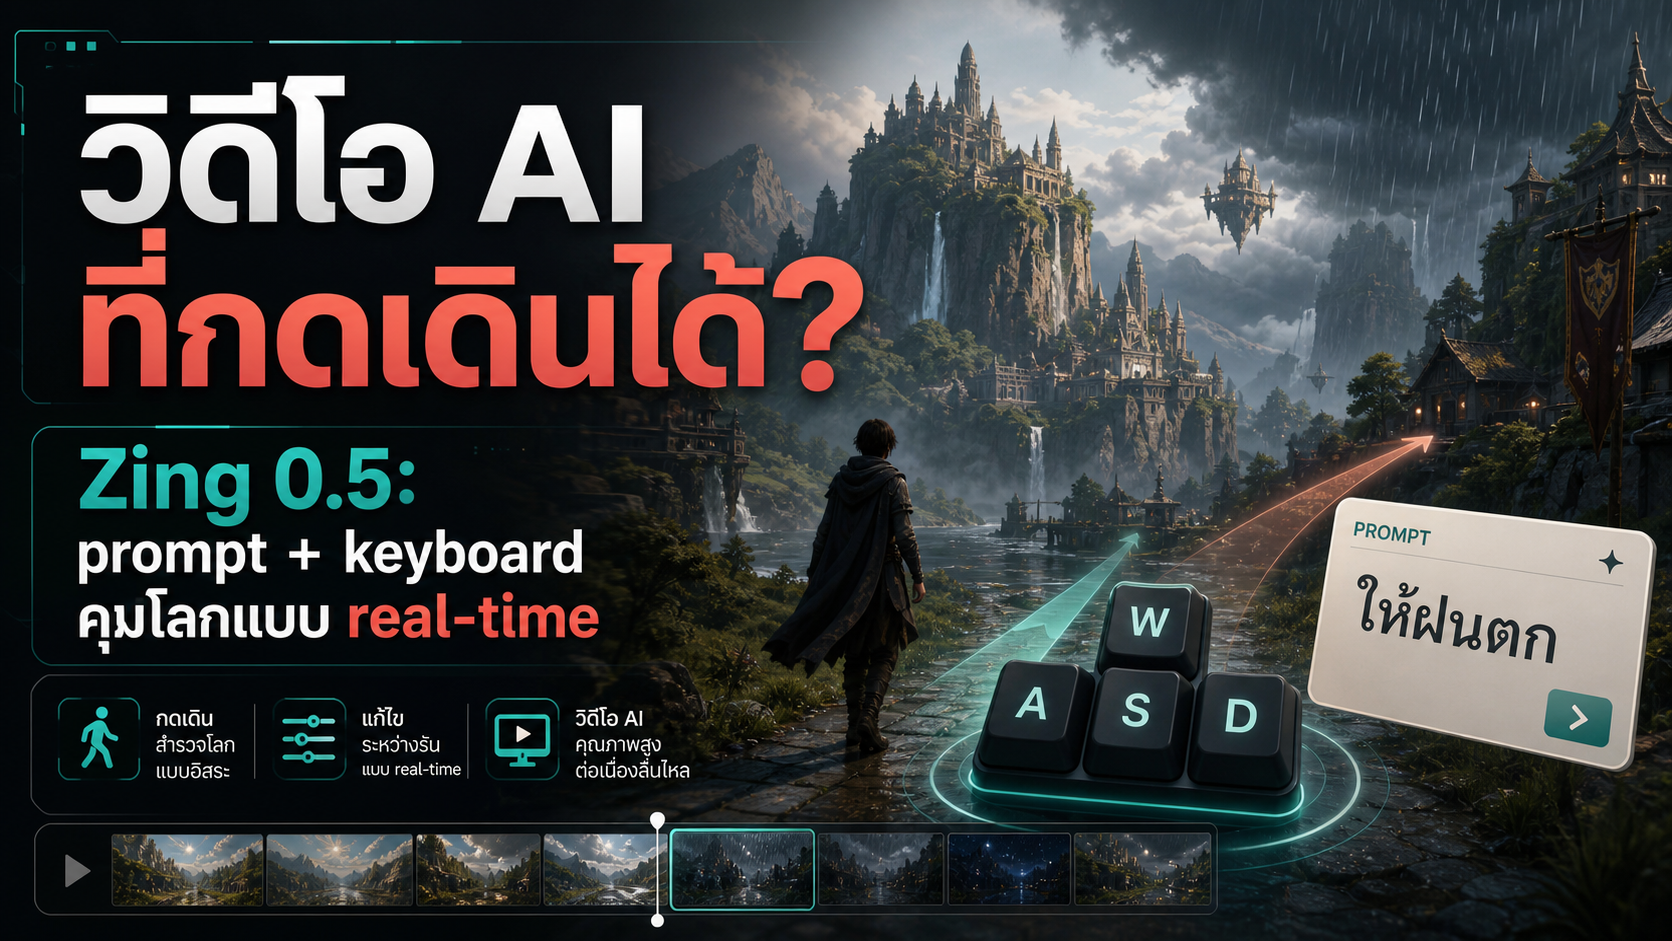
ถ้าวิดีโอ AI ไม่ได้เป็นไฟล์ที่เจนเสร็จแล้วจบ แต่เป็น “โลก” ที่เราเดินเข้าไปบังคับและแก้ระหว่างทางได้ล่ะ? นี่คือภาพที่ Zing 0.5 จาก Loopit หรือ Seedleap กำลังผลักให้ชัดขึ้น: โมเดลโอเพนซอร์สที่สร้างโลกภาพต่อเนื่อง พร้อมรับทั้งการกดแป้นพิมพ์และข้อความคำสั่งในขณะที่โลกนั้นกำลังเกิดขึ้น
Zing 0.5 คืออะไร
Zing 0.5 เป็น causal world model ขนาด 5B พัฒนาบนฐาน Wan 2.2 TI2V 5B และเปิดโค้ด/weights ภายใต้ Apache 2.0 จุดต่างจาก text-to-video ปกติคือ โมเดลไม่ได้รับ prompt แล้วส่ง MP4 จบ ๆ ออกมาเท่านั้น แต่สร้างเฟรมถัดไปจาก “โลกตอนนี้” จึงรับคำสั่งใหม่ระหว่าง rollout ได้
คำว่า world model ในที่นี้ไม่ได้แปลว่ามันสร้างโลกจริงเหมือนเกมเอนจินสมบูรณ์แบบ แต่หมายถึงระบบที่พยายามรักษาสถานะภาพ ความเคลื่อนไหว และผลของคำสั่งให้ต่อเนื่องกันข้ามเวลา
สองวิธีคุมโลก: ปุ่ม และข้อความ
| วิธีสั่ง | สิ่งที่เกิดขึ้น | ภาพจำง่าย ๆ |
|---|---|---|
| Keyboard actions | ส่งสัญญาณ 8 มิติจาก W/A/S/D/I/J/K/L เข้า timeline | เหมือนบังคับตัวละครและกล้องในเกม |
| Text prompt | เปลี่ยนความหมายและอนาคตของโลกที่กำลังสร้าง | พิมพ์ “ให้ฝนตก” แล้วให้ฝนเข้ามาในฉากเดิม |
W/A/S/D ใช้กำกับการเคลื่อนที่ ส่วน I/J/K/L ใช้กำกับมุมมองกล้อง ทั้งหมดถูกบันทึกเป็น controls ในไฟล์ JSONL ที่มี timestamp ไม่ใช่แค่ปุ่มตกแต่งบนวิดีโอ นั่นจึงทำให้แอปพลิเคชันภายนอกสามารถ map input ของผู้ใช้เข้ารูปแบบควบคุมเดียวกันได้
ความต่างที่สำคัญ: แก้โลกเดิม แทนการเริ่มใหม่
เวลาพิมพ์คำสั่งใหม่ในระบบสร้างวิดีโอทั่วไป เรามักได้คลิปใหม่หรือฉากใหม่ แต่ Zing รองรับ prompt-driven state changes: คำสั่งข้อความถูกใส่ในช่วงเวลาของ rollout เพื่อเปลี่ยนสิ่งที่จะเกิดถัดไป โดยโลกที่สร้างมาก่อนยังเป็นบริบทอยู่
เป้าหมายไม่ใช่ “สร้างคลิปใหม่ให้สวยกว่าเดิม” แต่คือ “ให้คำสั่งใหม่มีผลต่อโลกที่กำลังดำเนินต่อ”
นี่เป็นความสามารถที่น่าจับตาสำหรับเกมต้นแบบ, interactive story, virtual camera หรือประสบการณ์ที่ผู้ใช้ร่วมกำกับภาพ เพราะการเดิน การหันกล้อง และการเขียนเงื่อนไขของโลกสามารถเกิดร่วมกันได้
ทำไมการสร้างต่อเนื่องถึงยาก
วิดีโอที่สร้างแบบ autoregressive มีปัญหาเดิม: ถ้าเฟรมก่อนหน้าคลาดเล็กน้อย ความผิดพลาดอาจสะสมจนตัวละครเปลี่ยนหน้า ฉากไหล หรือโทนภาพเพี้ยนเมื่อเวลาผ่านไป Zing ระบุว่าใช้การฝึกที่จงใจรบกวนประวัติภาพ เพื่อให้โมเดลเรียนรู้การสร้างต่อจาก history ที่ไม่สมบูรณ์ แทนที่จะพังทันทีเมื่อเจอความคลาดเคลื่อน
ไม่ได้แปลว่าความต่อเนื่องจะสมบูรณ์เสมอไป แต่เป็นการแก้ปัญหาที่สำคัญมากสำหรับโลกภาพที่ต้องยาวกว่าคลิปสั้นไม่กี่วินาที
ทำไมถึงพยายามให้ตอบสนองเร็ว
เอกสารอธิบายว่าใช้ causal KV cache และ four-step DMD sampling เพื่อให้ rollout ตอบสนองได้ดีขึ้นใน pipeline GPU เดี่ยว โมเดลมีวิธีจัดการ attention แบบ sliding window: ค่ามาตรฐาน 97/9 เหมาะกับ GPU ที่มีหน่วยความจำอย่างน้อย 80GB ขณะที่ 33/5 เป็นทางเลือกสำหรับหน่วยความจำต่ำลงหรือการใช้งานใกล้ real-time
นี่คือจุดที่ต้องแยกให้ออกระหว่าง “สถาปัตยกรรมออกแบบให้เร็ว” กับ “ใครก็รันบนเครื่องตัวเองได้ทันที” เอกสารทางการยังต้องการ Linux, NVIDIA GPU, Python 3.11 และ CUDA-capable environment การเปิดโค้ดจึงเปิดทางทดลองและพัฒนาต่อ ไม่ได้ลบต้นทุนฮาร์ดแวร์ออกไป
เริ่มทดลองอย่างไร
repo มีตัวอย่าง rollout พร้อมใช้ ทั้ง text-to-video ที่มี action, image-initialized video, prompt switching และแบบรวม keyboard + prompt การรันพื้นฐานมีหน้าตาประมาณนี้:
bash run.sh \
  --pretrained-dir /path/to/Zing-0.5/pretrained \
  --checkpoint /path/to/Zing-0.5/generator/model.pt \
  --messages examples/case7_action_prompt_switch_t2v.jsonl \
  --output-dir outputs/demo
ความน่าสนใจของ JSONL คือมันแยก “โลกตั้งต้น” ออกจาก “การควบคุมตามเวลา” ชัดเจน นักพัฒนาจึงสามารถทดลอง interaction pattern ก่อนต้องสร้าง UI ใหญ่ ๆ ได้
ผลทดสอบและข้อควรระวัง
ทีม Zing ประกาศว่า Zing 0.5 อยู่ลำดับ 2 โดยรวมและอันดับ 1 ในกลุ่ม real-time world models บน WBench ณ 26 สิงหาคม 2026 นี่เป็นสัญญาณที่ดี แต่ยังควรมองว่าเป็น benchmark เฉพาะชุดงาน ไม่ใช่การรับประกันคุณภาพสำหรับทุกสไตล์ภาพ ทุกเกม หรือทุกความยาวของ rollout
- เริ่มจากตัวอย่างทางการและวัดความต่อเนื่องของฉากที่ทีมต้องการจริง
- ตรวจ hardware requirement ก่อนดาวน์โหลด weights ขนาดใหญ่
- อย่าตีความว่าเป็น game engine สำเร็จรูป: ระบบยังต้องมีชั้น UI, input mapping และกติกาเกมของเราเอง
สรุป
Zing 0.5 ชวนให้มองวิดีโอ AI ในอีกแบบหนึ่ง: จากสิ่งที่เราดูเฉย ๆ ไปสู่โลกที่เราส่งผลต่อมันได้ระหว่างกำลังเกิดขึ้น จุดเด่นที่สุดไม่ใช่แค่ภาพสวย แต่คือการรวม action, text และความต่อเนื่องระยะยาวเข้าด้วยกันในโมเดลโอเพนซอร์สขนาดค่อนข้างกระชับ
อ่านและทดลองต่อได้จาก GitHub ทางการ, Project Page และ Hugging Face


ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!