Yadeep Blog Yadeep Blog
หน้าแรก
หมวดหมู่
AI Generative
AI Generative
ML & Research
ML & Research
AI Agents & Tools
AI Agents & Tools
AI Ethics & Security
Hardware & Infrastructure
Robotics & Auto
Robotics & Auto
Tech & Career
Tech & Career
AI Models
AI Models
สอนใช้งานฟรีๆ เกี่ยวกับ ติดต่อ
เข้าสู่ระบบ สมัครสมาชิก

AI Models

โมเดล AI และ Large Language Models

25 บทความ อัปเดตข่าวใหม่ทุกวัน ดูหมวดหมู่อื่น

บทความในหมวดนี้

เรียงตามบทความล่าสุด
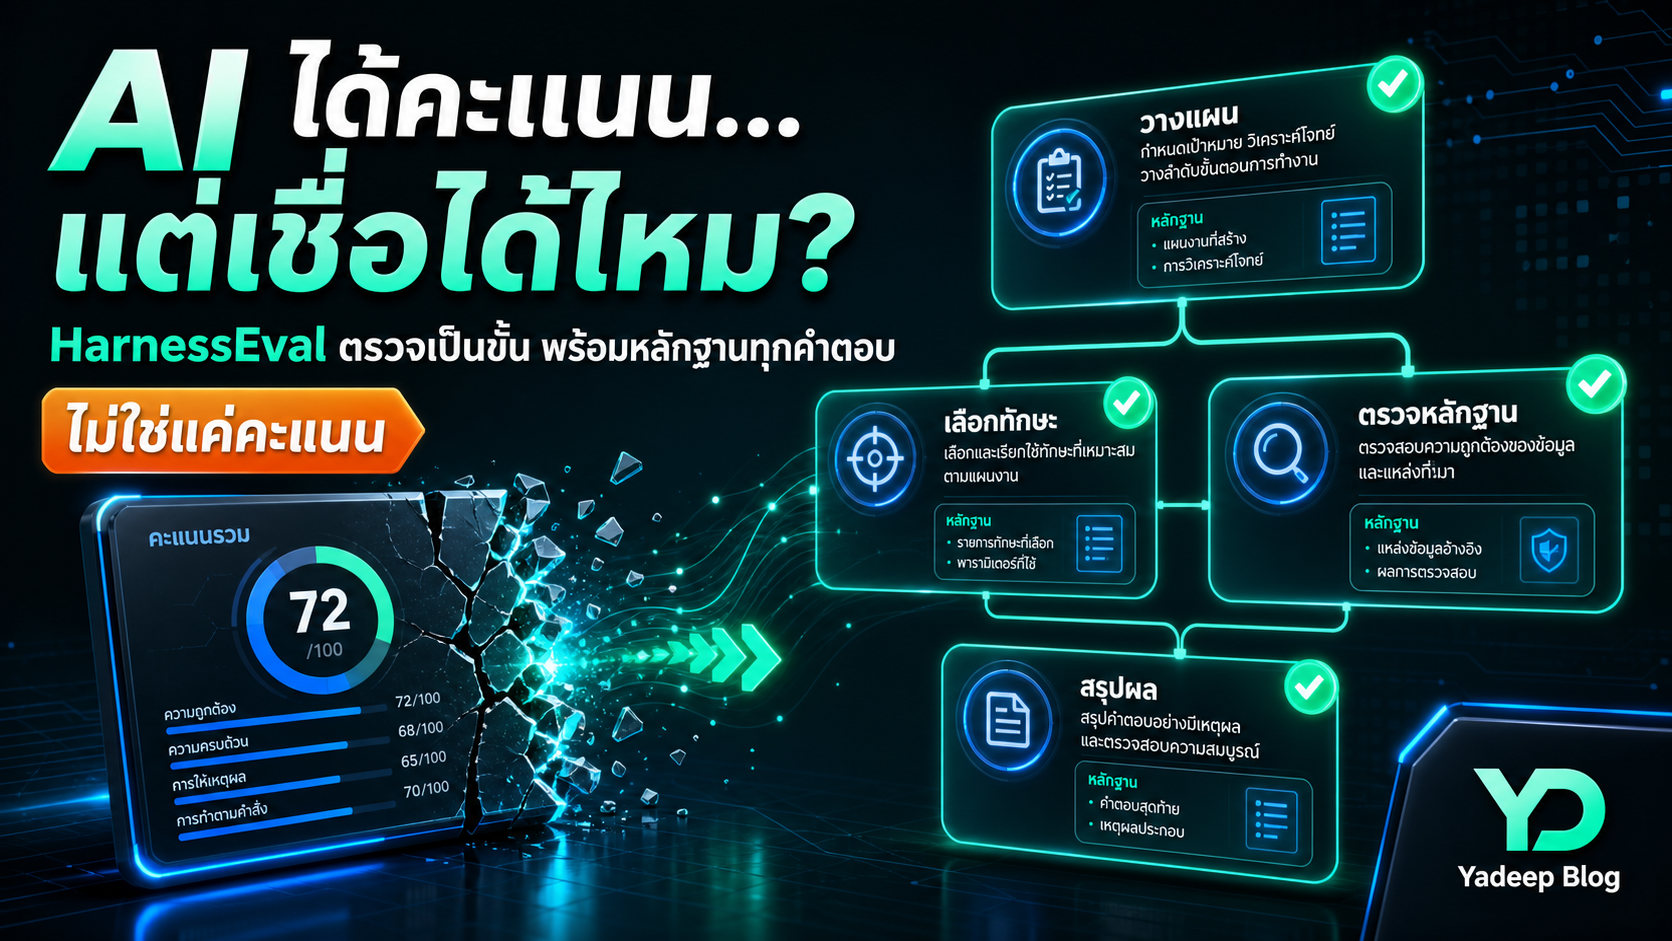
HarnessEval: เมื่อ AI ได้คะแนน แต่เราต้องเห็นเหตุผลก่อนเชื่อ
AI Models

HarnessEval: เมื่อ AI ได้คะแนน แต่เราต้องเห็นเหตุผลก่อนเชื่อ

HarnessEval เปลี่ยนการประเมิน AI จากคะแนนก้อนเดียว เป็น workflow แบบ agentic ที่วางแผน เลือกทักษะ หาและตรวจหลักฐาน ก่อนสรุปผลเป็น Evidence Tree
20 ส.ค. 2569 17 9 นาที
เมื่อมีเครื่องมือมากขึ้น เราอาจต้องการ ‘ข้อจำกัด’ มากกว่าเดิม
AI Models

เมื่อมีเครื่องมือมากขึ้น เราอาจต้องการ ‘ข้อจำกัด’ มากกว่าเดิม

บทความชวนคิดจากโลกซอฟต์แวร์: ความอุดมสมบูรณ์ของเครื่องมือและ AI ไม่ได้ทำให้ตัดสินใจง่ายขึ้นเสมอไป—ข้อจำกัดที่ดีอาจช่วยให้เราโฟกัส ออกแบบ และสร้างงานที่อยู่ได้นานกว่า

20 ส.ค. 2569 18 6 นาที
Gemini 3.7 Flash — Google ออกใหม่ทุก 3 สัปดาห์ เขียนโค้ดชนะ Claude Sonnet 5 ลดราคาครึ่งหนึ่ง
AI Models

Gemini 3.7 Flash — Google ออกใหม่ทุก 3 สัปดาห์ เขียนโค้ดชนะ Claude Sonnet 5 ลดราคาครึ่งหนึ่ง

Google ปล่อย Gemini 3.7 Flash ห่างจาก 3.6 แค่ 3 สัปดาห์ FrontierCode กระโดด 34.4% เป็น 43.6% ชนะ Claude Sonnet 5 และ GPT-5.6 Terra DeepSWE กระโดด 16 จุด ลดราคา API ครึ่งหนึ่งถึงสิ้นปี แอป Gemini ทะลุ 1 พันล้านผู้ใช้

16 ส.ค. 2569 29 10 นาที
Muse Glimmer — Meta เปิดซอร์ส 30B รันที่บ้านได้ 24GB เดียวพอ 3.1x เร็วขึ้น ฟรี Apache 2.0
AI Models

Muse Glimmer — Meta เปิดซอร์ส 30B รันที่บ้านได้ 24GB เดียวพอ 3.1x เร็วขึ้น ฟรี Apache 2.0

Meta Superintelligence Labs เปิดซอร์ส Muse Glimmer 30B Dense รันบนการ์ดจอ 24GB หรือ Mac 32GB เดียว ใช้ DFlash speculative decoding ได้ 233 tok/s บน RTX 5090 128K context + multimodal 100% รันในเครื่อง ข้อมูลไม่ออก ฟรี Apache 2.0

16 ส.ค. 2569 31 11 นาที
dots3-note preview — โมเดล MoE 280B/16B จาก小红书 512K context IMO 2026 เต็ม 42/42 Apache 2.0
AI Models

dots3-note preview — โมเดล MoE 280B/16B จาก小红书 512K context IMO 2026 เต็ม 42/42 Apache 2.0

小红书 dots lab เปิดซอร์ส dots3-note preview โมเดล MoE 280B total/16B activated 256 experts Top-8 รองรับ 512K context + multumodal (text/image/video/audio) ทำ IMO 2026 ได้เต็ม 42/42 เน้นงาน Agent ระยะยาว วางแผนท่องเที่ยว จัดงานแต่ง พัฒนาซอฟต์แวร์ end-to-end พร้อม Self-Critiquing แก้ผิดเองได้ ฟรี Apache 2.0

16 ส.ค. 2569 25 9 นาที
Qwen3.8-27B เปิดซอร์ส 27B ที่โค่น Opus 4.6 Max บน SWE-bench Pro — สรุปข่าว AI สัปดาห์นี้ (16 ส.ค. 2026)
AI Models

Qwen3.8-27B เปิดซอร์ส 27B ที่โค่น Opus 4.6 Max บน SWE-bench Pro — สรุปข่าว AI สัปดาห์นี้ (16 ส.ค. 2026)

Alibaba ปล่อย Qwen3.8-27B โมเดลเปิด 27B ที่ทำ SWE-bench Pro 61.7 ชนะ Claude Opus 4.6 Max (53.4) รันบน GPU 24GB ฟรี Apache 2.0 พร้อมสรุปข่าว AI ร้อนๆ รอบสัปดาห์

16 ส.ค. 2569 32 8 นาที
GLM-5.3 โมเดล AI จาก Z.ai ที่เขียนโค้ดเก่งที่สุดในโลกโอเพนซอร์ส
AI Models

GLM-5.3 โมเดล AI จาก Z.ai ที่เขียนโค้ดเก่งที่สุดในโลกโอเพนซอร์ส

GLM-5.3 โมเดลปัญญาประดิษฐ์ล่าสุดจาก Z.ai ที่พิสูจน์ว่า Post-Training Scaling สามารถดันความสามารถ AI ให้เทียบเท่าโมเดลปิดราคาแพง พร้อมความสามารถด้านความปลอดภัยไซเบอร์ที่ทรงพลัง

15 ส.ค. 2569 49 8 นาที