
เคยอัดเสียงประชุมแล้วกลับมาฟังตัวเองพูดว่า “เอ่อ…อืม…เดี๋ยวนะ” ทุกสามวินาทีไหม? ถ้าเคย ข่าวนี้อาจช่วยชีวิตทั้งคนพูดและคนทำรายงาน เพราะ Google เปิดตัว Gemini 3.5 Transcribe โมเดลแปลงเสียงเป็นข้อความที่ไม่ได้ทำหน้าที่เป็นแค่เครื่องพิมพ์ดีด แต่พยายามเข้าใจว่าคุณ “ตั้งใจจะพูดอะไร” ด้วย
มันมีทั้งรุ่นถอดเสียงสดและรุ่นจัดการไฟล์บันทึก รองรับมากกว่า 85 ภาษา รับศัพท์เฉพาะได้ และแยกผู้พูดในไฟล์เสียงได้ ที่น่าสนุกที่สุดคือโหมด Smart ซึ่งลบคำฟุ่มเฟือย รับคำแก้กลางประโยค และจัดข้อความเป็นย่อหน้าหรือลิสต์ให้พร้อมอ่าน ตรงนี้ผมว่าเป็นก้าวที่เปลี่ยนงานถอดเสียงจาก “ได้ข้อความดิบ” ไปเป็น “ได้ร่างที่พร้อมทำงานต่อ” จริง ๆ
ภาพเปิดตัวอย่างเป็นทางการจาก Google
Gemini 3.5 Transcribe คืออะไร เอาแบบไม่ต้องใส่เสื้อกาวน์
มันคือโมเดล speech-to-text หรือ AI ที่ฟังเสียงแล้วเขียนเป็นข้อความ แต่ Google แยกทางเข้าไว้สองแบบชัดเจน:
- gemini-3.5-transcribe-live ใช้กับเสียงที่ไหลเข้ามาสด ๆ ผ่าน Live API เหมาะกับซับสด ผู้ช่วยเสียง และหน้าจอที่ต้องตอบสนองทันที
- gemini-3.5-transcribe ใช้กับไฟล์ที่อัดไว้แล้วผ่าน Interactions API เหมาะกับประชุม สัมภาษณ์ สายโทรศัพท์ และงานที่ต้องการชื่อผู้พูดหรือเวลาแต่ละคำ
เปรียบเทียบง่าย ๆ: รุ่น Live เหมือนล่ามที่ยืนข้างเวที ส่วนรุ่นไฟล์เหมือนบรรณาธิการที่กลับไปฟังเทปแล้วติดป้ายว่าใครพูดอะไรตอนไหน
ไฮไลต์ที่ขโมยซีน: พูดวกไปวนมา แต่งานออกมาดูเป็นคนมีสติ
โหมดปกติ Verbatim จะเก็บสิ่งที่พูดแทบทุกคำ เหมาะกับงานที่ต้องการหลักฐานหรือคำพูดดิบ ส่วน Smart transcription จะตัด “เอ่อ” “อืม” การพูดซ้ำ และเลือกคำแก้ล่าสุด เช่น “นัดวันอังคาร—ไม่ใช่ วันพุธ” ผลลัพธ์จะเหลือ “นัดวันพุธ” พร้อมจัดเวลาและเครื่องหมายวรรคตอนให้เรียบร้อย
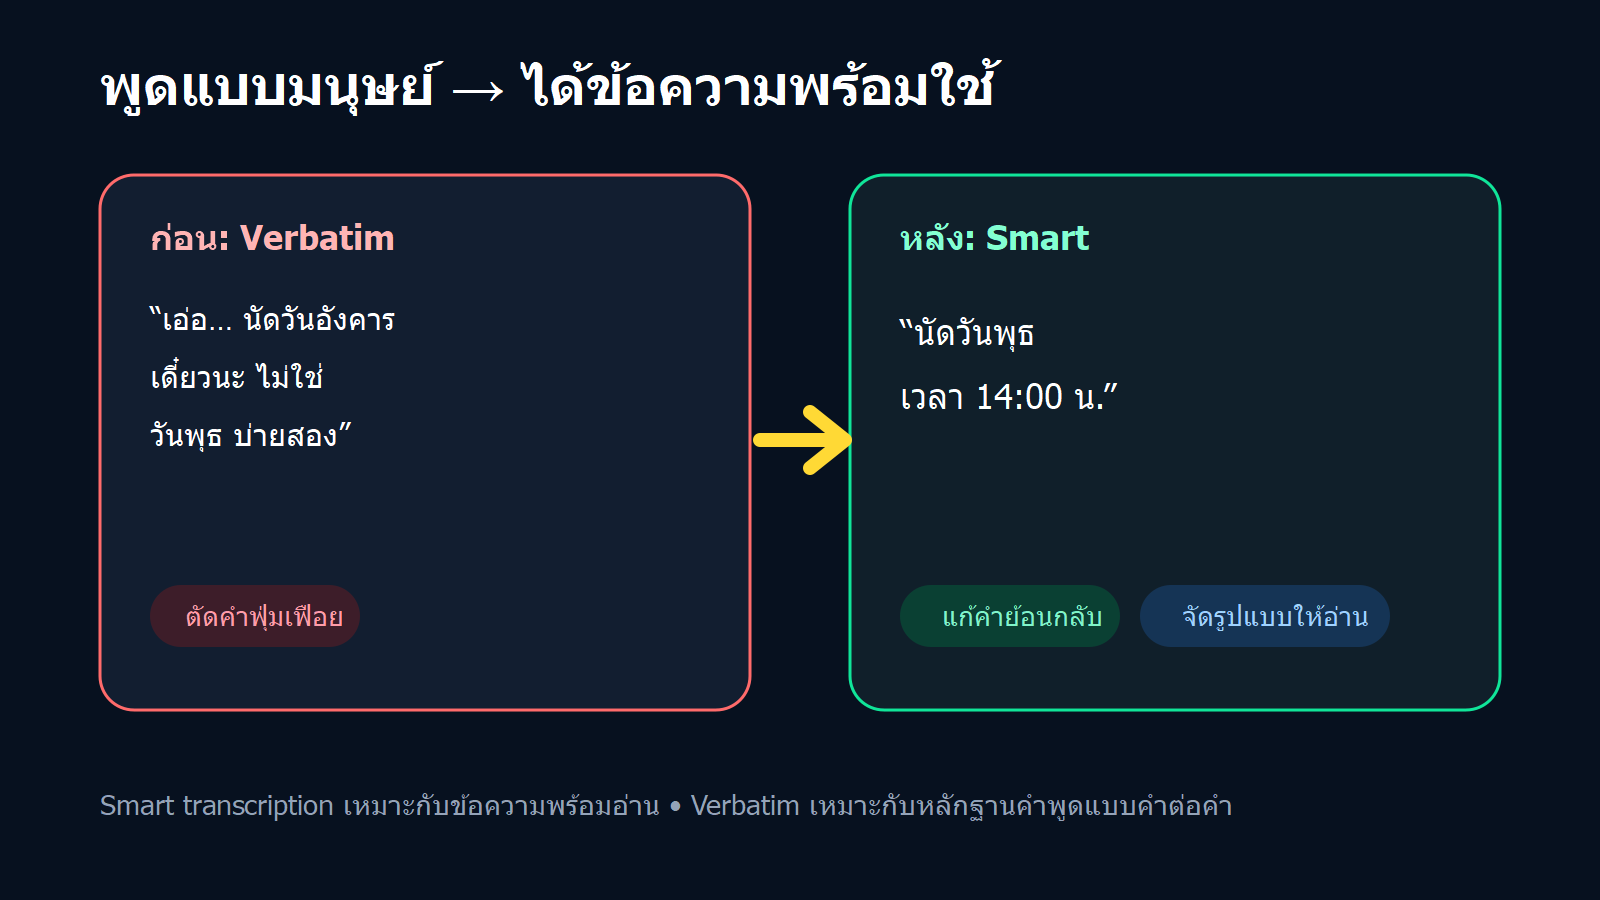
ภาพสรุป: Smart transcription เปลี่ยนคำพูดติดขัดให้เป็นข้อความพร้อมอ่าน
ฟังดูเหมือนเรื่องเล็ก แต่คนเคยแกะเทปจะรู้ว่าคำฟุ่มเฟือยคือฝูงยุงในห้องนอน—ตัวเดียวไม่เท่าไร มาเป็นร้อยตัวแล้วอยากย้ายบ้าน จุดนี้จึงน่าจะช่วยงานประชุม พอดแคสต์ สัมภาษณ์ และการพิมพ์ด้วยเสียงได้มาก
แต่อย่ากด Smart ทุกงานแบบหลับตา
เอกสารทางกฎหมาย งานวิจัยเชิงคุณภาพ หรือหลักฐานคำให้การอาจต้องการคำพูดแบบคำต่อคำ และตามเอกสาร API ปัจจุบัน Smart mode ใช้พร้อม word-level timestamps หรือ speaker diarization ในคำขอเดียวกันไม่ได้ ถ้าต้องการเวลาแต่ละคำหรือแยกผู้พูด ให้เลือก Verbatim แล้วค่อยทำความสะอาดข้อความภายหลัง
แม่นแค่ไหน? ตัวเลขว้าวได้ แต่อ่านเชิงอรรถด้วย
Google ระบุผลวัดจาก Artificial Analysis ว่า Word Error Rate หรือสัดส่วนคำที่ถอดผิด เฉลี่ยอยู่ที่ 4.0% สำหรับสตรีมสด และ 2.6% สำหรับไฟล์ที่อัดไว้ ยิ่งตัวเลขต่ำยิ่งดี ส่วนบนชุดทดสอบหลายภาษาชื่อ FLEURS รุ่น Live ได้ 5.50% และรุ่นไฟล์ได้ 5.04% พร้อมเวลารอผลสุดท้ายที่เร็วขึ้น 70% เมื่อเทียบกับ Chirp 3 ตามข้อมูลของ Google
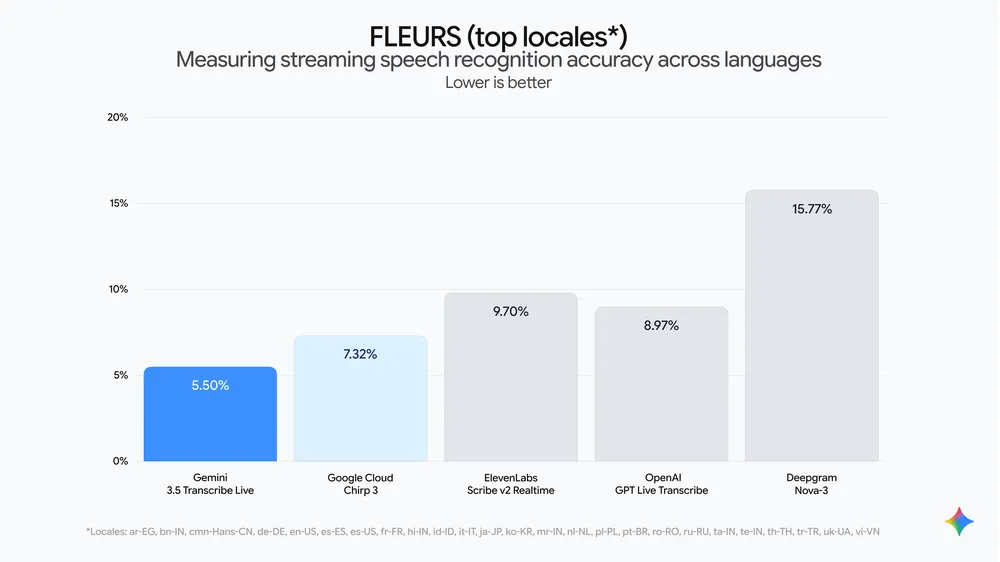
กราฟ FLEURS จาก Google: เปรียบเทียบอัตราคำผิดในงานถอดเสียงสดหลายภาษา
นี่เป็นผล benchmark ไม่ใช่คำสัญญาว่าไฟล์เสียงทุกไฟล์จะได้ 2.6% ห้องก้อง ไมค์ไกล คนพูดทับกัน สำเนียงเฉพาะ และศัพท์แปลกยังมีผลเสมอ แต่สิ่งที่ดูมีประโยชน์ในโลกจริงคือ custom vocabulary ซึ่งใส่ศัพท์เฉพาะได้สูงสุด 1,000 คำ โดย Google แนะนำว่ามักได้ผลดีที่สุดเมื่อใช้ราว 100 คำที่สำคัญจริง ๆ เช่น ชื่อสินค้า รหัสรุ่น ชื่อคน หรือศัพท์แพทย์
สองรุ่นนี้เลือกอย่างไร ไม่ให้เปิดประตูผิดบาน
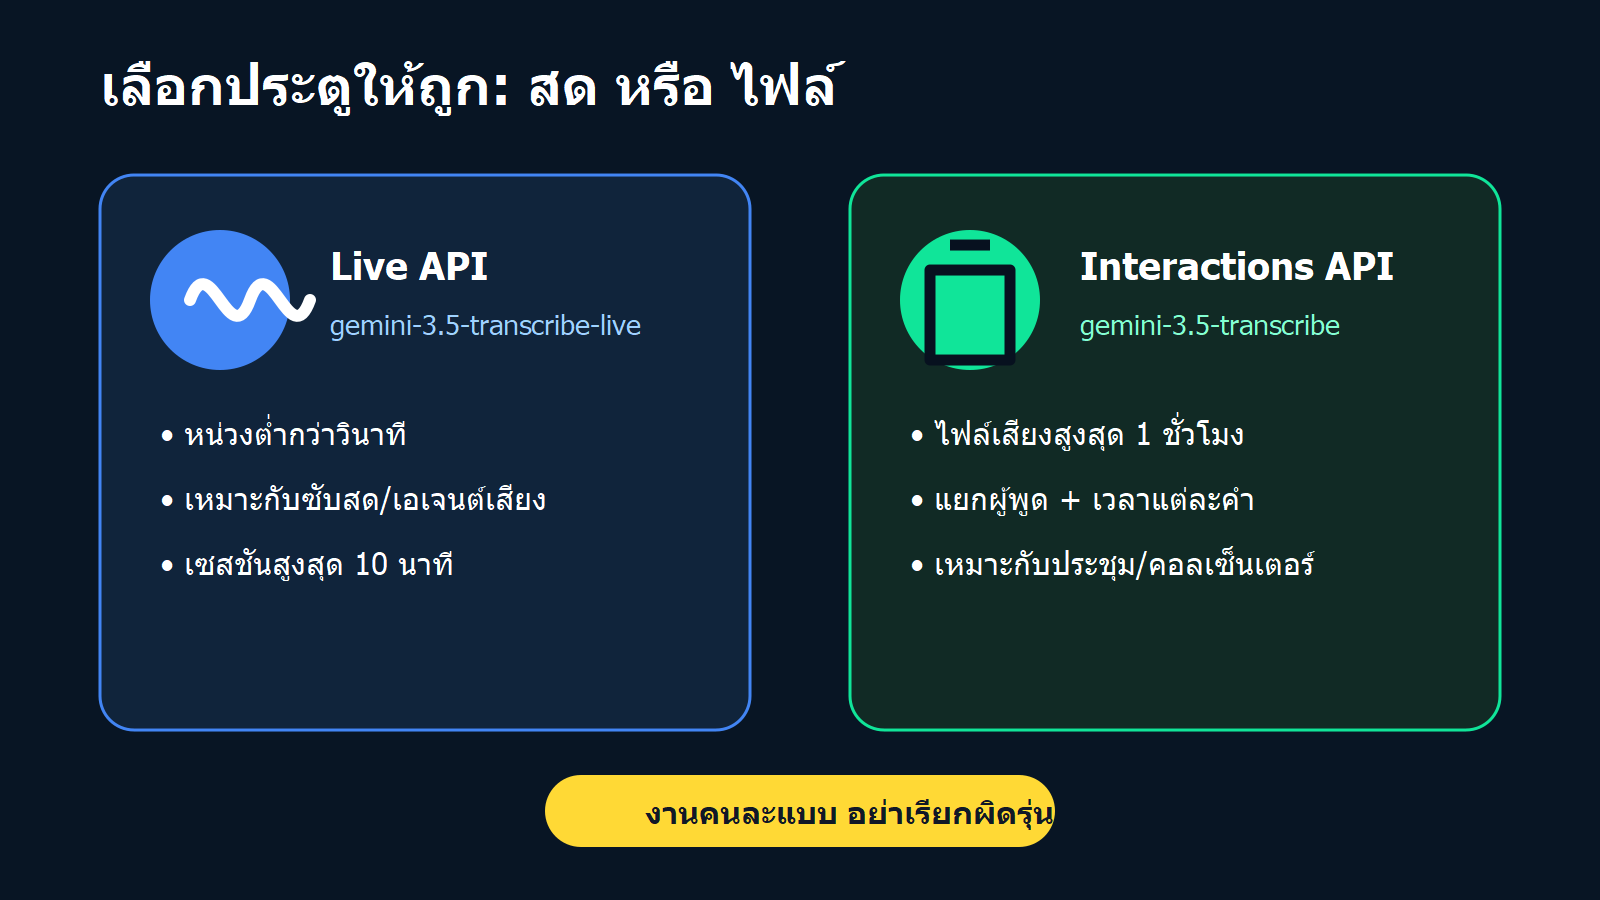
ภาพสรุป: Live API กับ Interactions API เหมาะกับงานคนละแบบ
| เรื่องที่เทียบ | Live | ไฟล์เสียง |
|---|---|---|
| เหมาะกับ | ซับสดและเอเจนต์เสียง | ประชุม สัมภาษณ์ คอลล็อก |
| ความยาว | สูงสุด 10 นาทีต่อเซสชัน | สูงสุด 1 ชั่วโมง; เหลือ 30 นาทีเมื่อใช้แยกผู้พูดหรือ timestamp |
| แยกผู้พูด/เวลาแต่ละคำ | ไม่รองรับ | รองรับ; ผู้พูด 3 คนขึ้นไปยังเป็น experimental |
| ราคาประเมินแบบเสียเงิน | ประมาณ $0.009/นาที | ประมาณ $0.005/นาที |
นักพัฒนาลองได้อย่างไร
รุ่นไฟล์อยู่ใน public preview ผ่าน Gemini API และ Google AI Studio ตัวอย่าง Python แบบสั้นที่สุดคืออัปโหลดไฟล์ แล้วส่ง URI เข้า Interactions API:
from google import genai

client = genai.Client()
audio = client.files.upload(file="meeting.mp3")

result = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "type": "audio",
        "uri": audio.uri,
        "mime_type": audio.mime_type,
    }],
)

print(result.output_text)
เดโม smart dictation บน macOS จาก GitHub ของ Google Gemini
Google ยังมีเดโม macOS แบบกดปุ่มค้างแล้วพูด จากนั้นข้อความที่เกลาสะอาดจะถูกพิมพ์ลงตำแหน่งเคอร์เซอร์ทันที ไอเดียมันง่ายจนดูธรรมดา แต่ของที่ “กดแล้วใช้ได้เลย” มักชนะของที่มีเมนู 47 ชั้นเสมอ
คนทั่วไปจะเจอมันที่ไหน
เทคโนโลยีนี้เริ่มโผล่ใน Rambler บน Gboard สำหรับ Android บางประเทศและภาษา, Gemini บน macOS ภาษาอังกฤษ และกำลังจะเข้า Chrome สำหรับพิมพ์ด้วยเสียงในช่องข้อความต่าง ๆ ส่วน Google Antigravity ใช้บริบทหน้าจอและแชตก่อนหน้า—เมื่อผู้ใช้อนุญาต—เพื่อช่วยจำชื่อไฟล์หรือศัพท์ในงานให้ถูกขึ้น
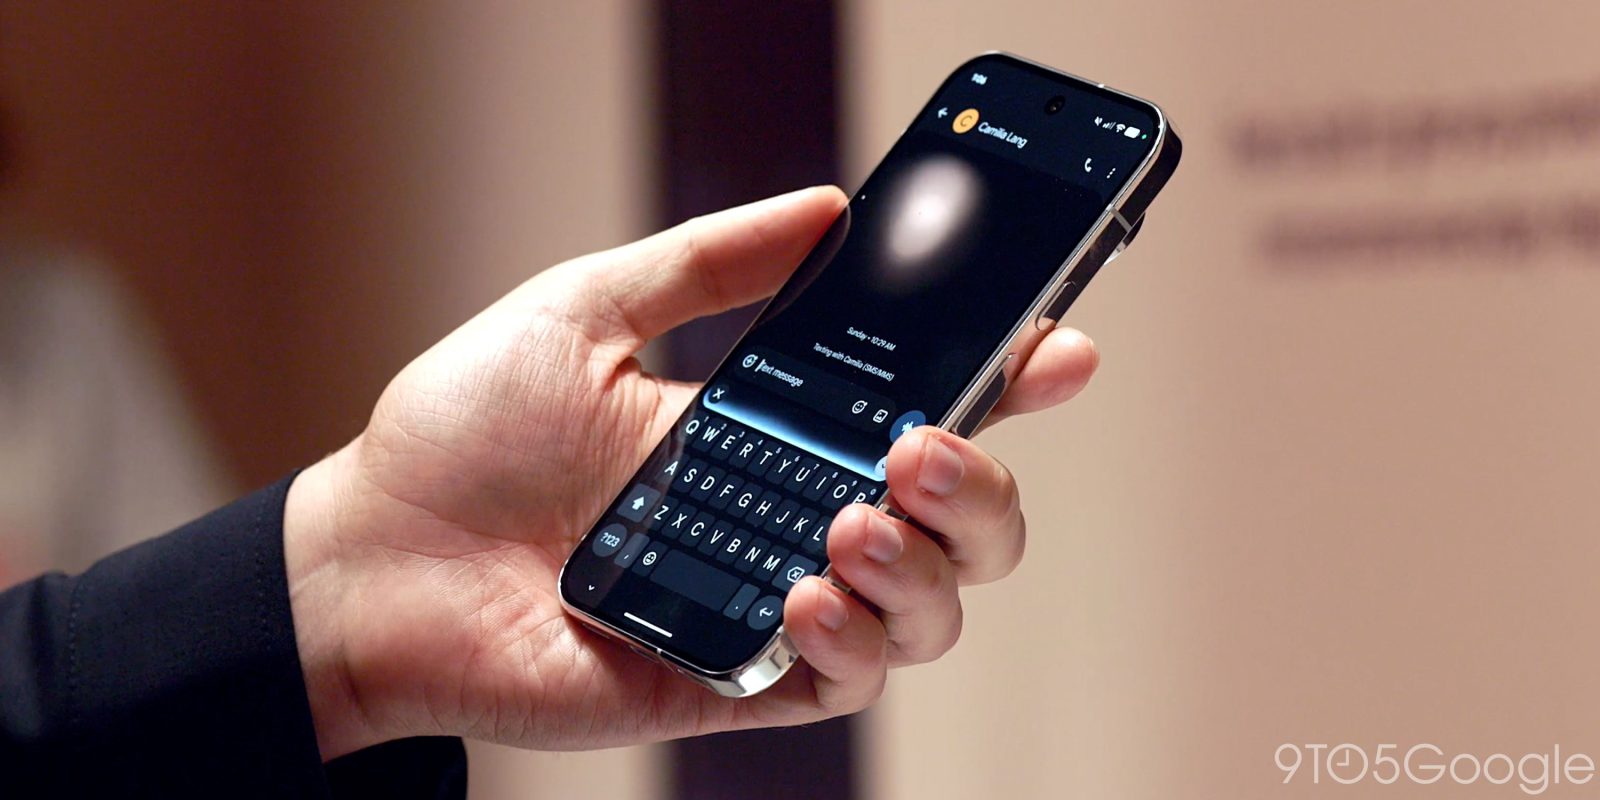
ภาพการใช้งาน Rambler บนสมาร์ตโฟน ที่มา: 9to5Google
มีจุดหนึ่งที่ควรแยกให้ชัด: บทความรวมบางแห่งเขียนเหมือนโมเดล Transcribe เรียกเครื่องมือสร้างภาพหรือวิเคราะห์ไฟล์ได้เอง แต่ model card ของ API ระบุว่าโมเดลถอดเสียงตัวนี้ ไม่รองรับ function calling โดยตรง สิ่งที่เกิดในแอป Gemini บน macOS คือแอปนำข้อความไปส่งต่อให้โมเดล Gemini ตัวอื่นทำงานอีกทอดหนึ่ง ไม่ใช่โมเดลถอดเสียงลุกขึ้นไปวาดภาพเอง
เหมาะกับใครที่สุด
- ทีมประชุมเยอะ: ถอดประชุม แยกผู้พูด และค้นตำแหน่งคำสำคัญ
- คอลเซ็นเตอร์: จับรหัสคำสั่งซื้อหรือชื่อสินค้าโดยป้อนคำศัพท์เฉพาะ
- ครีเอเตอร์: ทำซับ ร่างบทความจากเสียง และลดเวลานั่งลบคำว่า “เอ่อ”
- นักพัฒนาแอปเสียง: ใช้ Live API เพื่อสร้างซับสดหรือผู้ช่วยที่ตอบเร็ว
3 อย่างที่ควรจำ
- มันมีสองรุ่น: Live สำหรับงานสด และรุ่นไฟล์สำหรับงานละเอียด
- Smart ไม่ใช่ Verbatim: มันเกลาคำพูดให้พร้อมอ่าน จึงไม่เหมาะกับทุกงานที่ต้องเก็บถ้อยคำดิบ
- ตัวเลขดี แต่เสียงจริงยังเป็นกรรมการ: ทดลองกับสำเนียง ไมค์ และศัพท์ของงานคุณก่อนนำไปใช้จริง
สรุปแบบเพื่อน: Gemini 3.5 Transcribe ไม่ได้ทำให้เราพูดเก่งขึ้น แต่มันช่วยให้สิ่งที่เราพูดดูเหมือนเตรียมมาดีขึ้น—ซึ่งบางวัน แค่นี้ก็ถือว่าเป็นปาฏิหาริย์แล้ว
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!