
Obsidian ดูเหมือนเกิดมาเพื่อ AI โดยเฉพาะ โน้ตอยู่บนเครื่อง เป็นไฟล์ Markdown เปิดอ่านง่าย และเอเจนต์ก็ค้น แก้ หรือเชื่อมไฟล์ได้แทบจะทันที ฟังแล้วเหมือนฝันของคนทำ Second Brain ใช่ไหมครับ?
แต่ Simon Späti ผู้ดูแล Vault ขนาด 25,979 ไฟล์ รวม 3.5 GB กลับเสนอความคิดที่สวนกระแสแบบสุด ๆ ว่า อย่ารีบปล่อย AI เข้าไปเขียนใน Vault หลัก เพราะสิ่งที่หายไปอาจไม่ใช่แค่ความเป็นระเบียบ แต่มันคือเส้นแบ่งว่า “ประโยคนี้เราคิดเอง หรือเครื่องคิดให้”
บทความนี้ไม่ได้ชวนเลิกใช้ AI และไม่ได้บอกว่า AI เป็นผู้ร้าย ตรงกันข้าม เราจะหาจุดที่ AI มีประโยชน์ที่สุดกับ Obsidian โดยไม่ปล่อยให้คลังความรู้ส่วนตัวกลายเป็นโกดังข้อความอัตโนมัติ
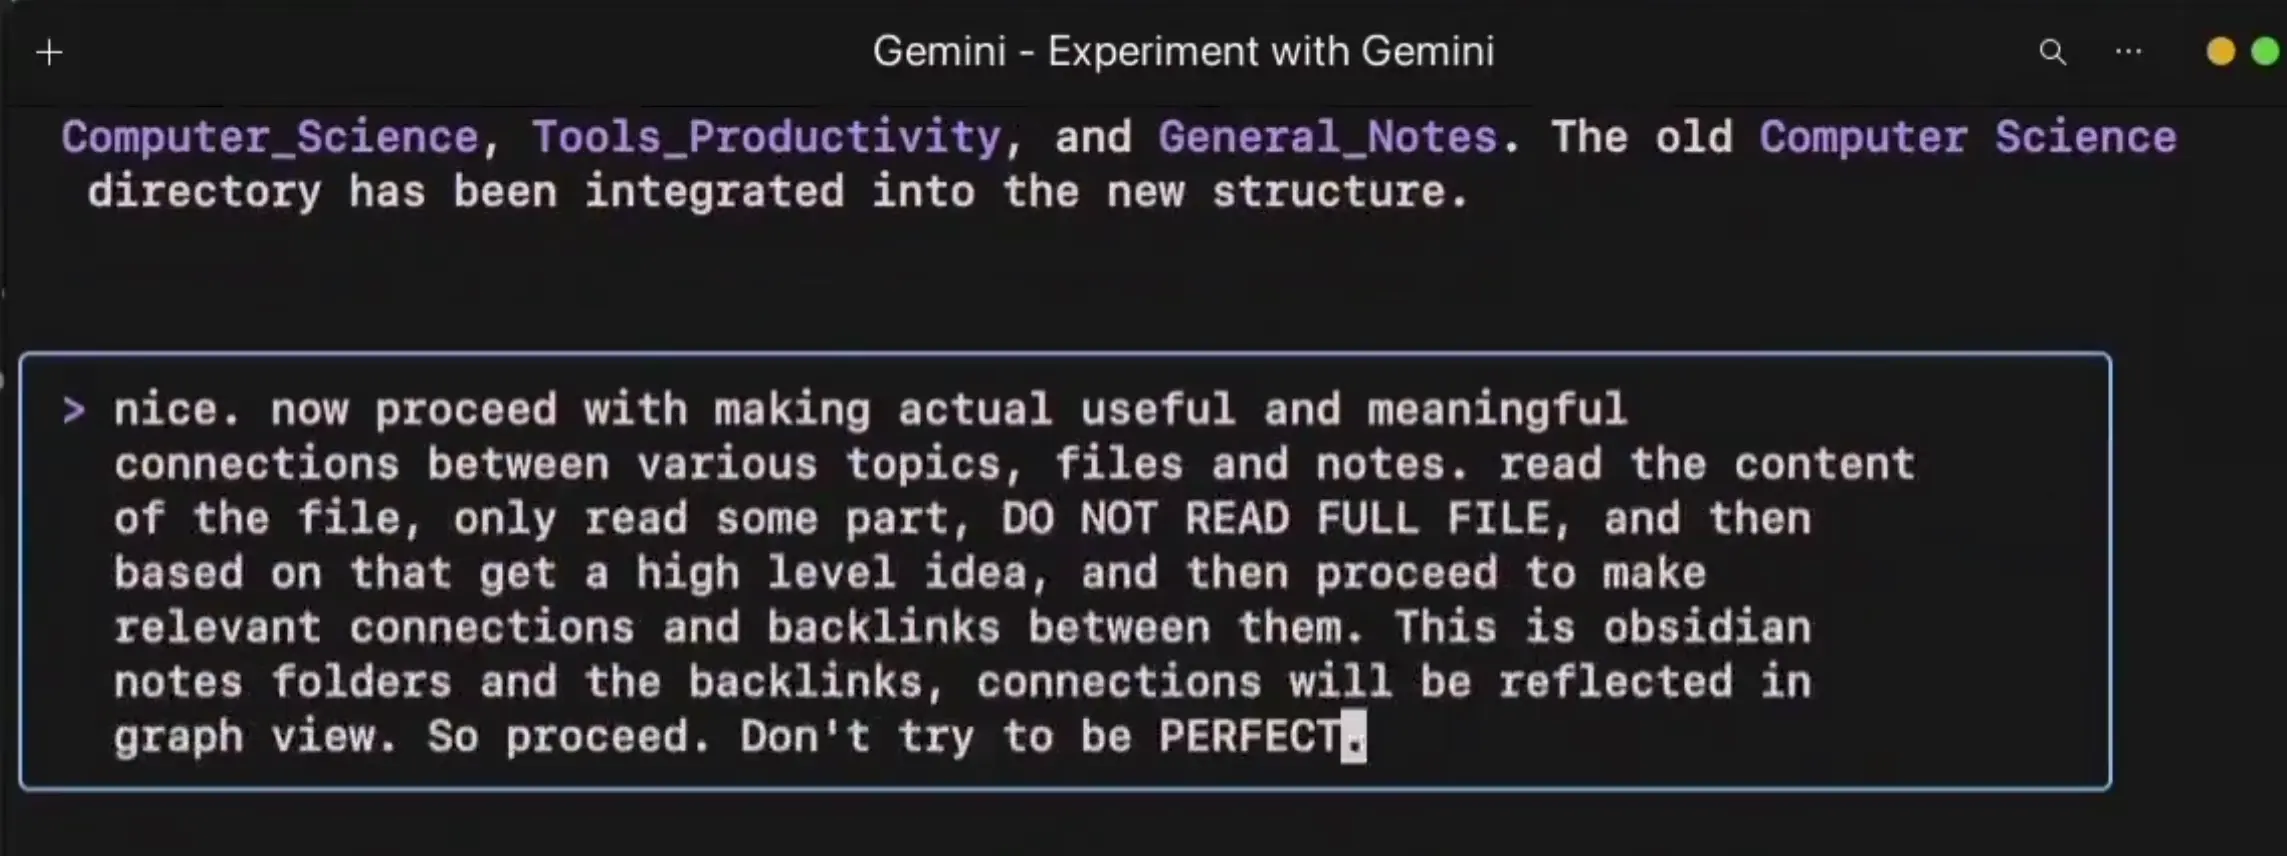
ภาพจากบทความต้นฉบับ: ตัวอย่างการสั่ง AI ให้สร้างความเชื่อมโยงและ backlink ใน Obsidian
กับดักที่ดูดีมาก: เมื่อ AI เติมโน้ตให้เราได้ทุกอย่าง
ลองนึกภาพว่าเรามีบทความยาวหนึ่งชิ้น กดปุ่มเดียวแล้ว AI สรุปให้ 20 บรรทัด สร้างแท็ก 12 อัน แตกโน้ตย่อยอีก 8 ไฟล์ และเชื่อม backlink ให้อัตโนมัติ ดูบน Graph View แล้วอลังการเหมือนสมองดิจิทัลทำงานเองได้
ปัญหาคือความสวยของกราฟไม่ได้แปลว่าความสัมพันธ์เหล่านั้นมีความหมายกับเรา การเชื่อมโน้ตที่เกิดจากการนึกออกว่า “เรื่องนี้คล้ายเหตุการณ์เมื่อสามปีก่อน” มีน้ำหนักต่างจากลิงก์ที่โมเดลสร้างเพราะคำสองชุดอยู่ใกล้กันทางสถิติ
สรุปยาวจาก AI มักเป็นเสียงรบกวน ส่วน insight ที่เราได้หลังอ่านคือสัญญาณ
แนวคิดที่บทความต้นฉบับยกมาถกเถียง และเป็นหัวใจของเรื่องนี้
ตรงนี้ผมเห็นด้วยมาก เพราะ “การเขียน” ไม่ใช่แค่การบันทึกผลลัพธ์ มันคือเครื่องมือคิด เรามักพบช่องโหว่ของเหตุผลตอนพยายามเรียบเรียงประโยคเอง หากโยนขั้นตอนนั้นให้ AI ตั้งแต่ต้น เราอาจได้ข้อความที่เรียบร้อย แต่ไม่ได้ความเข้าใจที่ลึกขึ้นเลย
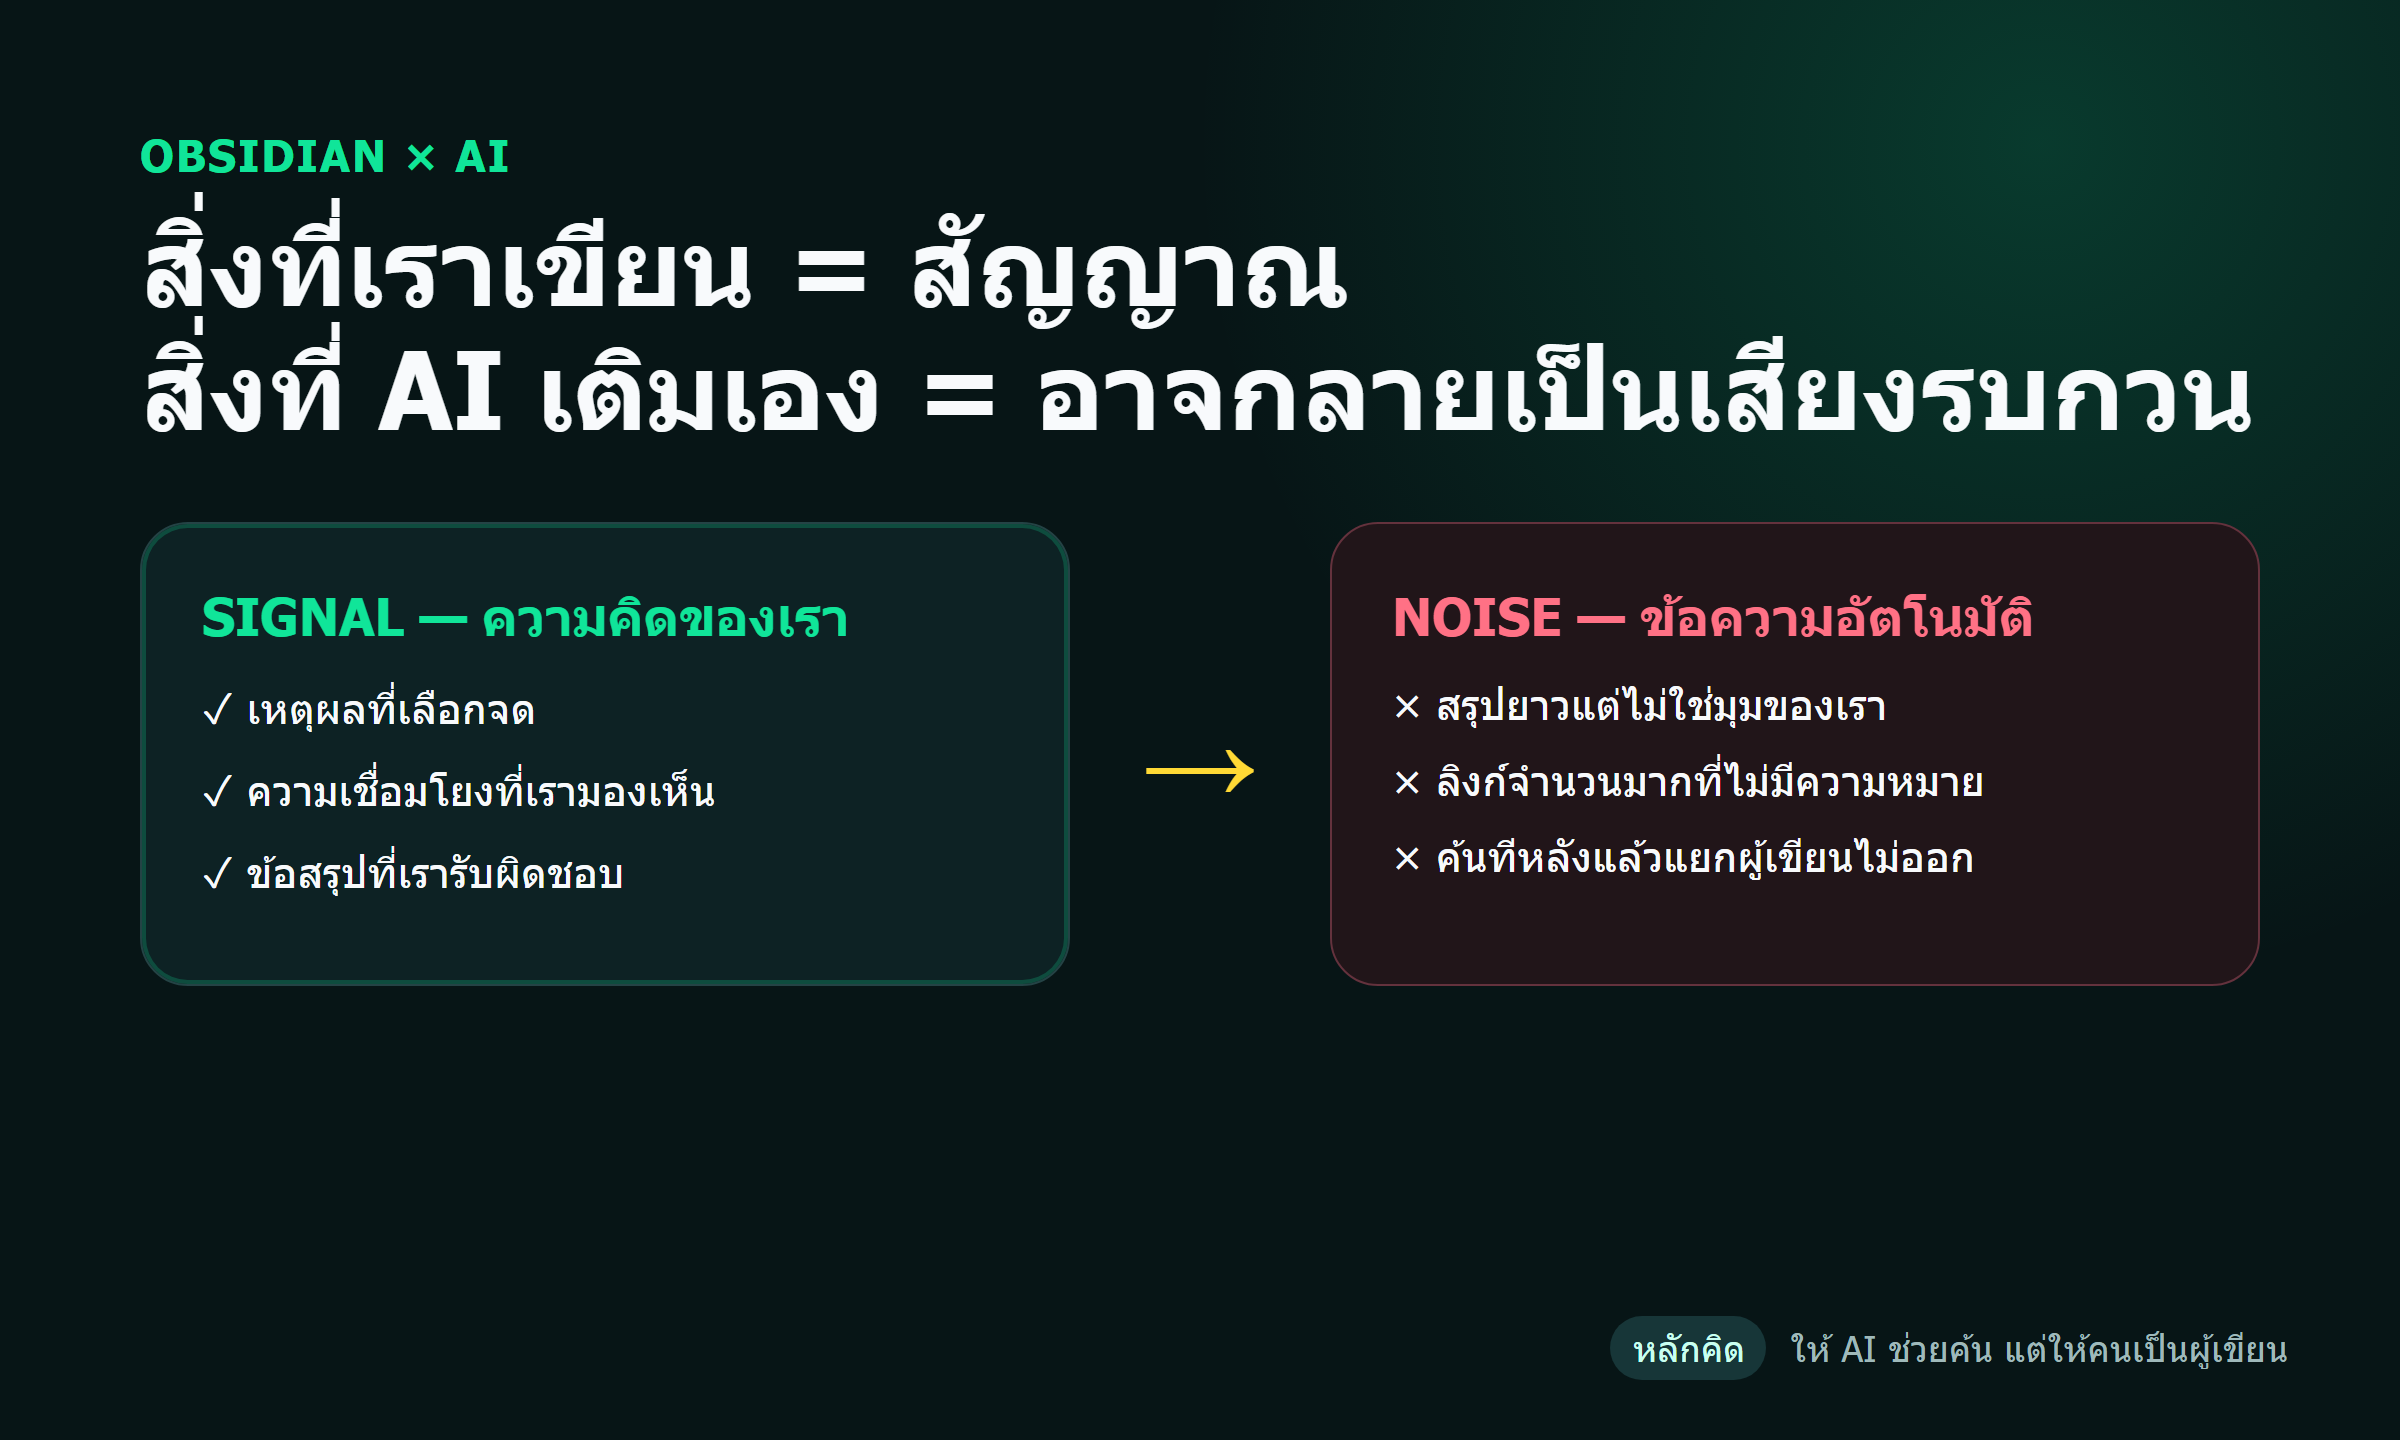
ภาพสรุป: ความคิดที่เราเขียนคือ signal ส่วนข้อความอัตโนมัติจำนวนมากอาจกลายเป็น noise
ปัญหาจริงไม่ใช่ AI ผิด แต่คือเราแยกเจ้าของความคิดไม่ออก
โน้ตส่วนตัวมีคุณค่าเพราะทุกบรรทัดเคยผ่านการเลือก เราจดบางอย่างเพราะมันกระทบใจ ขัดกับความเชื่อเดิม หรือช่วยแก้ปัญหาที่กำลังเจอ แม้โน้ตจะสั้นหรือเขียนไม่สวย มันยังมี “เหตุผลที่ถูกเก็บ” ซ่อนอยู่
เมื่อ AI เติมสรุปยาว ๆ ลงไปทุกไฟล์ จำนวนข้อความจะโตเร็วกว่าคุณภาพ เวลาค้นเรื่องเดิมในอนาคต เราต้องฝ่าข้อความที่ฟังดูสมเหตุสมผลแต่ไม่ได้สะท้อนสิ่งที่เราเคยคิด และที่น่ากลัวกว่านั้นคือผ่านไปห้าปี เราอาจจำไม่ได้แล้วว่าความเห็นไหนเป็นของเรา
สัญญาณเตือนว่า Vault เริ่มมี “AI Slop”
- ค้นอะไรก็เจอสรุปคล้ายกันเต็มไปหมด แต่หาโน้ตต้นฉบับยากขึ้น
- มีแท็กและ backlink จำนวนมาก ทว่าไม่ช่วยให้ตัดสินใจหรือเขียนงานได้เร็วขึ้น
- เปิดโน้ตเก่าแล้วตอบไม่ได้ว่าทำไมเราถึงเก็บมัน
- มีข้อความเรียบร้อยมาก แต่ไม่มีข้อสงสัย ความเห็นแย้ง หรือภาษาของเราเอง
แล้ว AI ควรทำอะไรใน Obsidian?
คำตอบที่สมดุลที่สุดคือ ให้ AI ทำหน้าที่ค้นคืนข้อมูล ไม่ใช่เป็นเจ้าของคลังความรู้ หรือพูดง่าย ๆ ให้มันเป็นบรรณารักษ์ที่เก่งมาก แต่ไม่ใช่นักเขียนที่แอบแก้หนังสือทุกเล่มบนชั้น
Smart Connections เป็นตัวอย่างของแนวทางนี้ ระบบใช้ embeddings (การแปลงความหมายของข้อความเป็นตัวเลข) เพื่อหาโน้ตที่มีเนื้อหาใกล้เคียงกับสิ่งที่กำลังเขียน เอกสารของโครงการระบุว่าโมเดลสำหรับ embeddings ทำงานในเครื่องเป็นค่าเริ่มต้น และโน้ตยังอยู่บนเครื่องของผู้ใช้ นี่เป็นประโยชน์ที่จับต้องได้: ของเก่าที่เราลืมสามารถกลับมาโผล่ในเวลาที่เหมาะ โดยไม่จำเป็นต้องให้ AI เขียนทับโน้ตเดิม
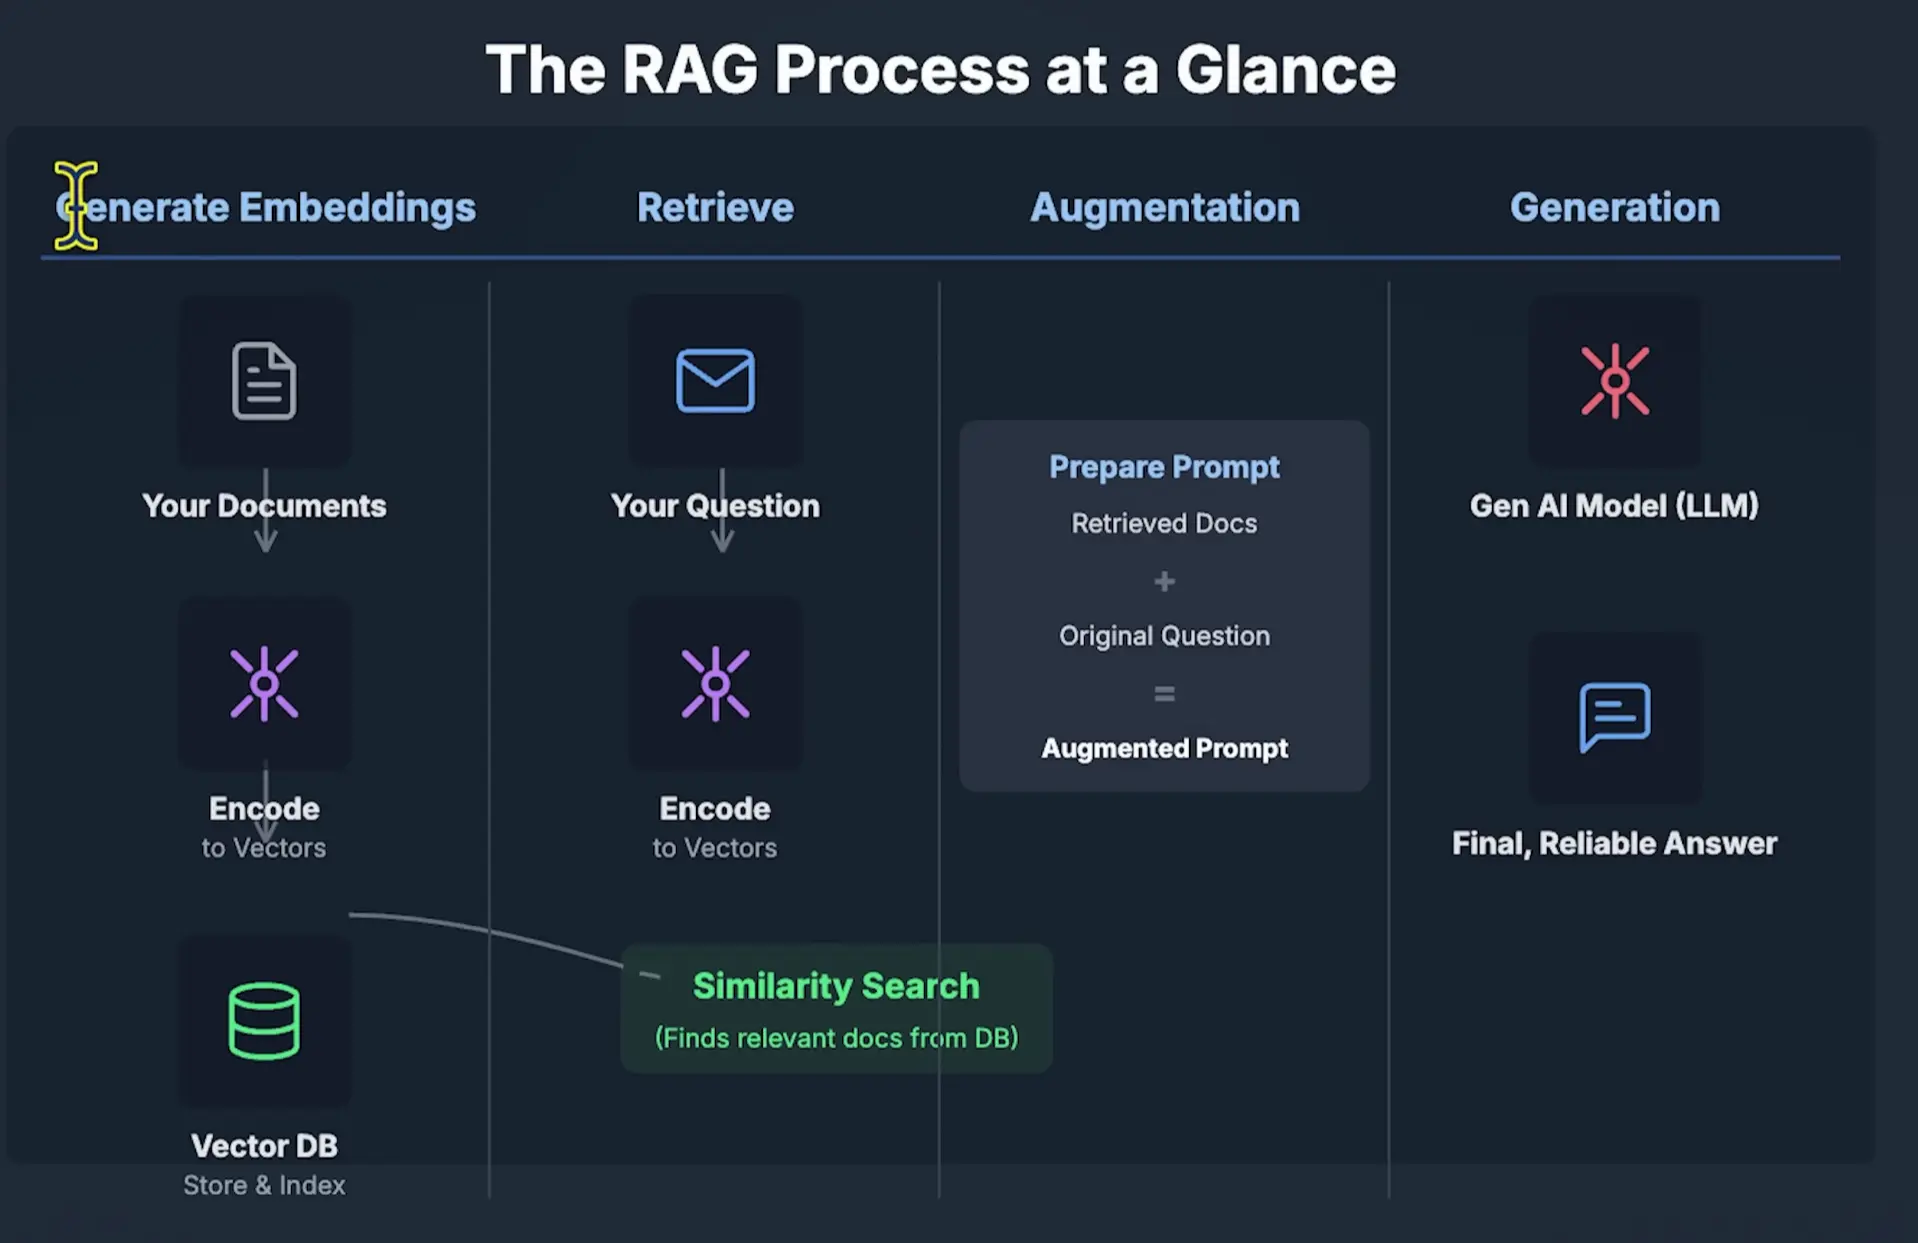
ภาพจาก ssp.sh: กระบวนการ RAG สำหรับค้นเอกสารที่เกี่ยวข้องก่อนให้โมเดลตอบ
เส้นแบ่งการใช้งานที่แนะนำ
| งาน | ให้ AI ช่วยได้ไหม | เงื่อนไข |
|---|---|---|
| ค้นโน้ตที่เกี่ยวข้อง | เหมาะมาก | ให้ผลเป็นคำแนะนำ ไม่แก้ไฟล์อัตโนมัติ |
| สรุปเว็บที่เพิ่งคลิป | ใช้ได้ | สั้น 1–2 ประโยคและติดป้ายว่า AI สร้าง |
| สร้างแท็กและ backlink ทั้ง Vault | ควรระวัง | ทำในพื้นที่ทดลองและให้คนตรวจทีละชุด |
| เขียนความเห็นหรือข้อสรุปแทนเรา | ไม่ควร | ให้ AI ตั้งคำถามหรือท้าทายเหตุผลแทน |
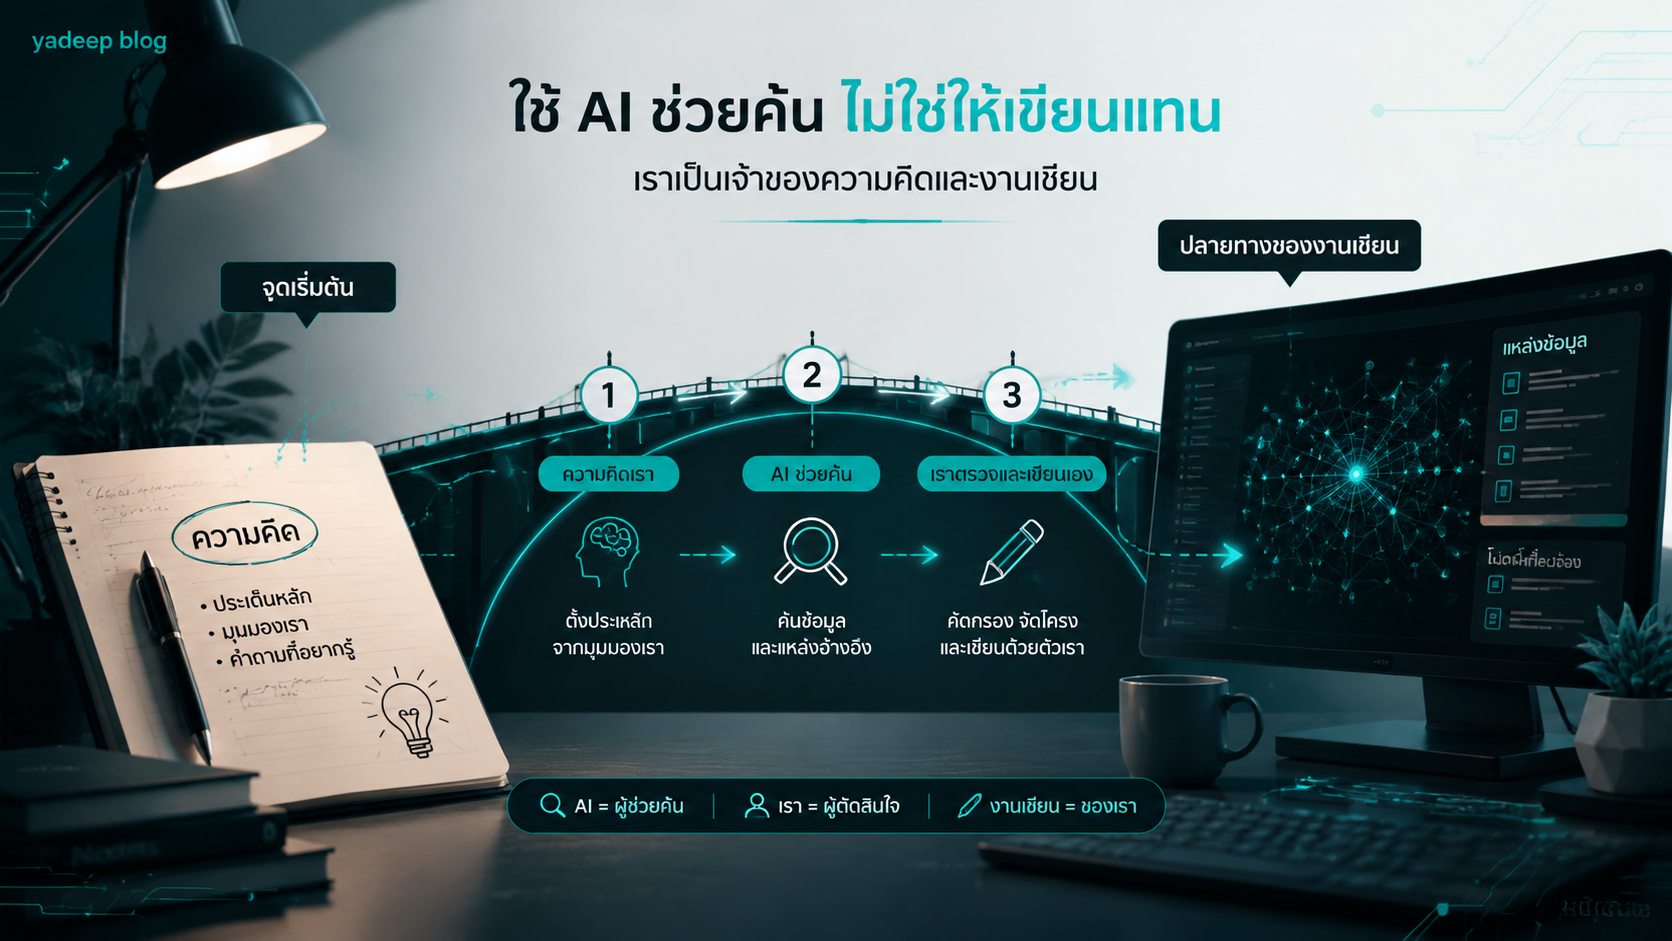
ภาพแนวคิด: AI ช่วยค้นและจัดบริบท ก่อนมนุษย์ตรวจและเขียนข้อสรุปเอง
Search ที่ดีเริ่มจากการจัดระบบ ไม่ได้เริ่มจากโมเดลที่ใหญ่กว่า
Späti บอกว่า Vault ของเขามีเกือบ 26,000 ไฟล์ แต่ค้นพบในไม่กี่วินาทีด้วย Omnisearch ประเด็นนี้น่าสนใจมาก เพราะมันพลิกคำถามจาก “เราควรติด AI ตัวไหน?” เป็น “เราออกแบบระบบให้ค้นเจอหรือยัง?”
ชื่อไฟล์ที่สื่อความหมาย โครงสร้างโฟลเดอร์ที่พอเดาได้ คำเชื่อมที่เราเลือกเอง และนิสัยเขียนโน้ตให้มีบริบท ช่วยได้มากกว่าการเทข้อความเข้า vector database แล้วหวังว่าโมเดลจะจัดระเบียบชีวิตให้ทั้งหมด
ภาพ Graph View ด้านล่างแสดงความต่างได้ดี เครือข่ายที่เกิดจากการเชื่อมโยงตามการใช้งานจริงดูเป็นใยซับซ้อน ขณะที่งานอัตโนมัติแบบแตกโน้ตจำนวนมากอาจเกิดลาย “ดาวกระจาย” จากศูนย์กลางเดียว มันไม่ได้แปลว่าทุกกราฟทรงดาวผิด แต่เป็นเครื่องเตือนว่าปริมาณลิงก์ไม่เท่ากับคุณค่าของลิงก์
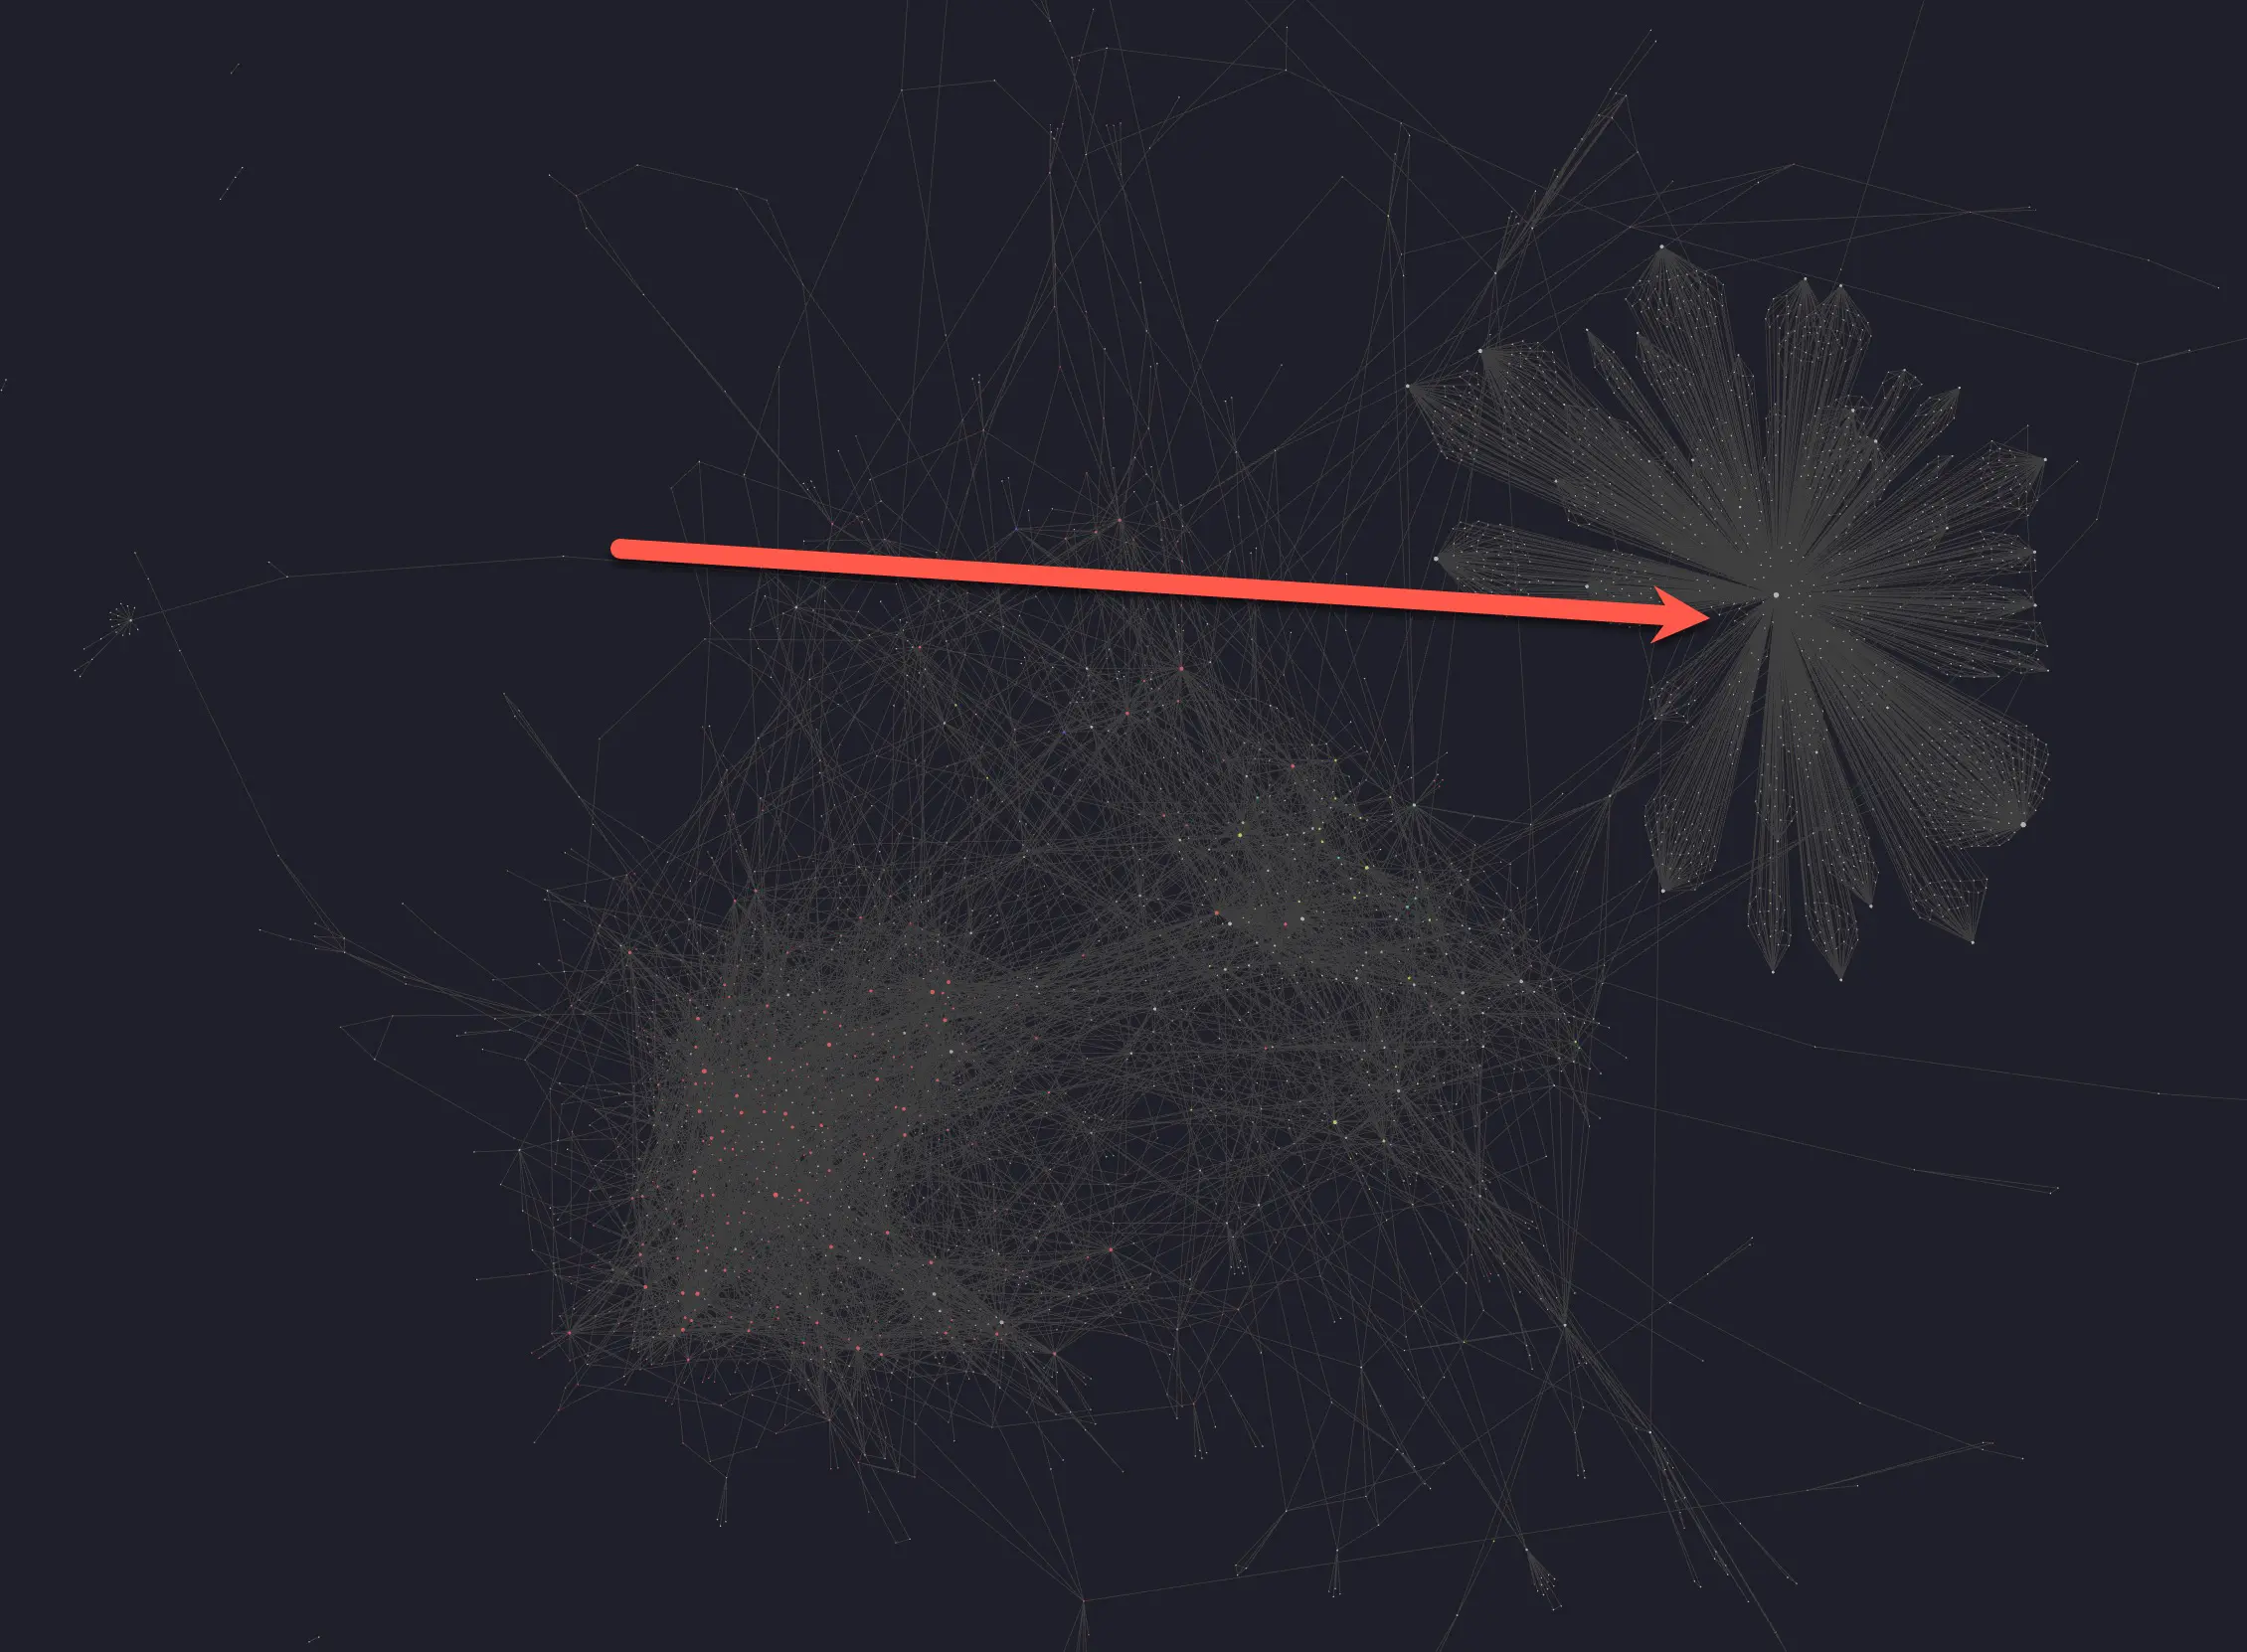
ภาพจาก ssp.sh: กราฟแบบดาวกระจายที่อาจเกิดจากการสร้างโน้ตหรือลิงก์อัตโนมัติ
Workflow ปลอดภัย: แบ่งสามพื้นที่ แล้วให้คนเป็นสะพาน
ถ้าอยากทดลองเต็มที่ ไม่จำเป็นต้องห้าม AI แบบเด็ดขาด วิธีที่ทำได้จริงกว่าคือแบ่งเขตให้ชัดเจน
- Vault หลัก: เก็บโน้ตที่เราเขียนหรืออนุมัติแล้ว ถือเป็นแหล่งความจริงส่วนตัว
- AI Workspace: แยกเป็นอีกโฟลเดอร์ อีก Vault หรือฐานข้อมูล เช่น DuckDB สำหรับสรุป จัดกลุ่ม และทดลองค้นแบบ semantic
- Reviewed Bridge: นำเฉพาะสิ่งที่มีประโยชน์กลับมา โดยเขียนใหม่ด้วยคำของเรา ใส่ที่มา และอธิบายว่าทำไมจึงเชื่อมกับโน้ตเดิม
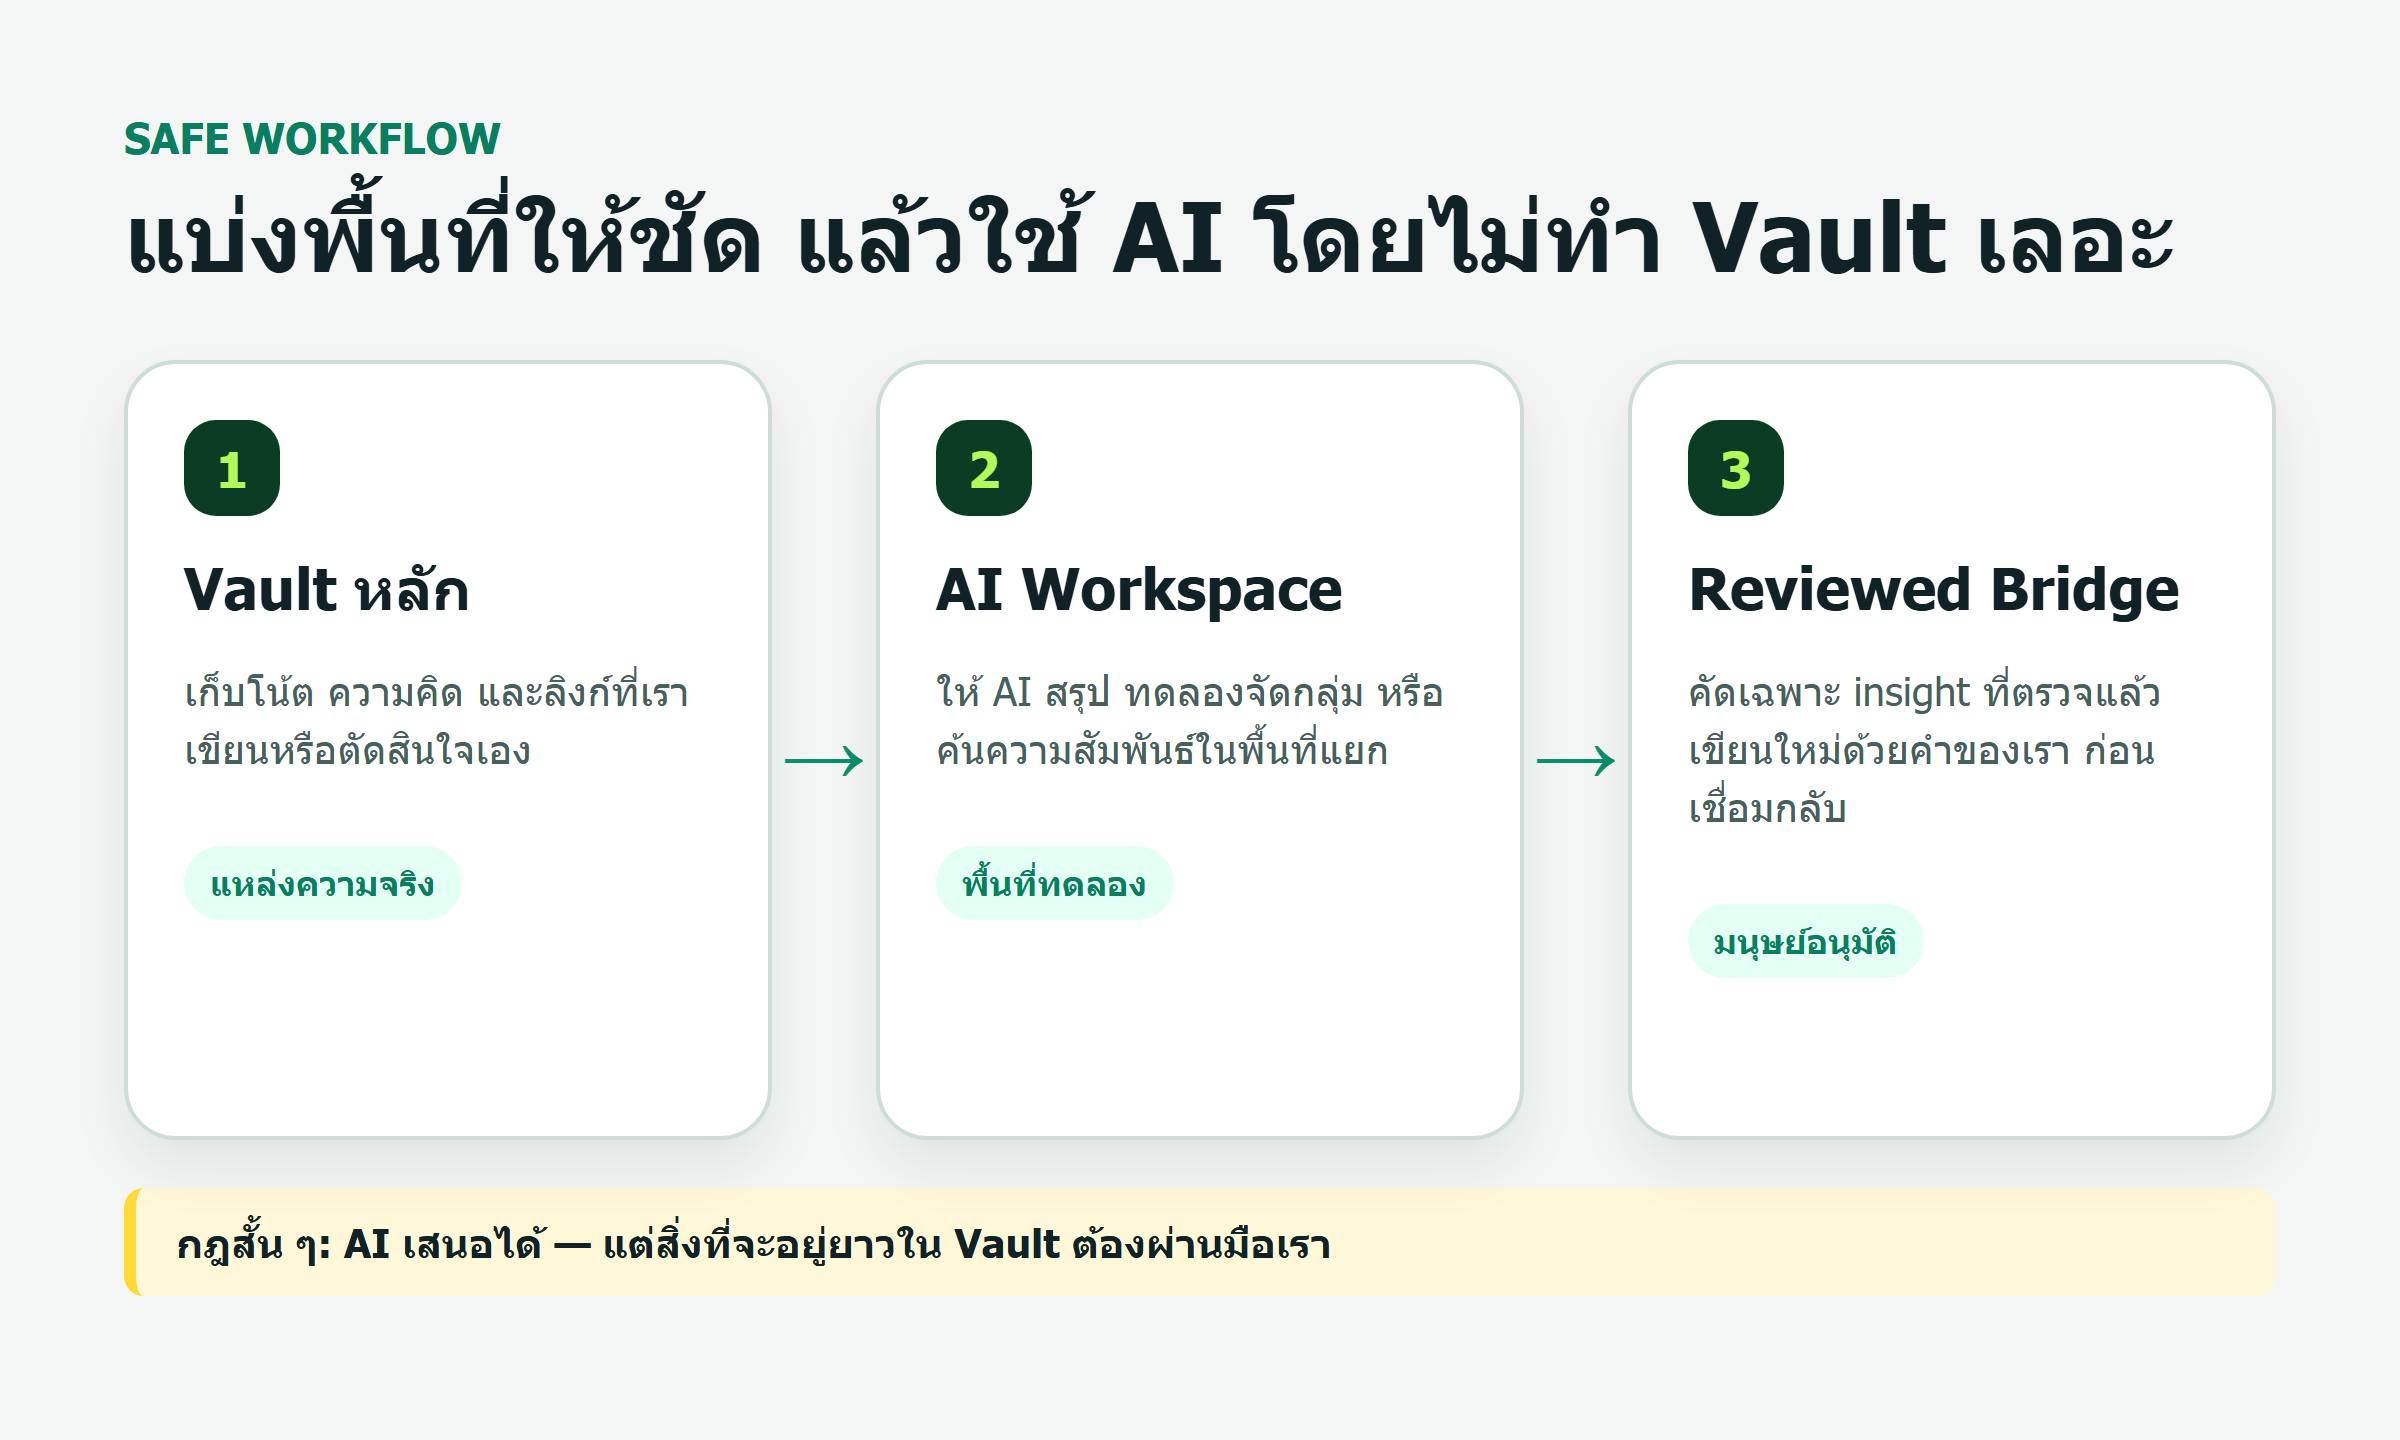
ภาพสรุป: แบ่ง Vault หลัก, AI Workspace และพื้นที่เชื่อมกลับหลังตรวจสอบ
ถ้าใช้วิธี PARA ก็ทำโฟลเดอร์ Resources/AI แยกต่างหาก และซ่อนจากผลค้นหาหลักได้ หลักการสำคัญไม่ใช่ชื่อโฟลเดอร์ แต่คือ ของที่ AI สร้างต้องมีสถานะต่างจากของที่เราเขียน
เครื่องมือที่ใช้ได้แบบไม่ยกพวงมาลัยให้ AI
1) Obsidian CLI สำหรับค้นและทำงานแบบตรวจสอบได้
Obsidian มี CLI ทางการสำหรับค้น อ่าน สร้าง และทำงานอัตโนมัติจากเทอร์มินัล เอกสารระบุว่าต้องใช้ installer รุ่น 1.12.7 ขึ้นไปและเปิด Command line interface ใน Settings ก่อน จุดดีคือเอเจนต์สามารถเรียกคำสั่งที่จำกัดขอบเขตได้ แทนการไล่อ่านหรือแก้ทั้ง Vault แบบไร้กรอบ
# ค้นโน้ตที่มีคำว่า second brain
obsidian search query="second brain"

# อ่านโน้ตที่กำลังเปิดอยู่
obsidian read

# เปิด daily note วันนี้
obsidian daily
2) Web Clipper สำหรับเก็บต้นฉบับ แล้วติดป้าย AI ให้ชัด
Web Clipper ทางการบันทึกเว็บลง Vault ในเครื่องและมี Interpreter ที่ใช้โมเดลช่วยประมวลผลหน้าเว็บได้ ถ้าจะให้ AI สรุป ให้สรุปสั้นและวางใน blockquote พร้อมป้าย “AI-generated” จากนั้นเขียนความเห็นของเราไว้คนละส่วน วันหนึ่งย้อนกลับมาอ่านจะรู้ทันทีว่าอะไรคือต้นฉบับ อะไรคือคำช่วย และอะไรคือข้อคิดของเรา
ข้อจำกัดที่ต้องพูดตรง ๆ
แนวคิด “กัน AI ออกจาก Vault” เป็นความเห็นและปรัชญาการทำงาน ไม่ใช่ผลวิจัยที่พิสูจน์ว่าทุกคนจะเรียนรู้แย่ลงเสมอ บางคนใช้ AI เขียนร่างแล้วคิดต่อได้ดีมาก บางคนมีข้อจำกัดทางการเขียนหรือใช้ voice-to-text ซึ่ง AI ช่วยให้เริ่มต้นได้จริง
อีกด้านหนึ่ง local model และ local embeddings ลดความเสี่ยงเรื่องการอัปโหลดข้อมูล แต่คำว่า local-first ไม่ได้แปลว่าปลอดภัยทุกกรณี ต้องตรวจการตั้งค่าปลั๊กอิน โฟลเดอร์ที่ถูก index สิทธิ์การเข้าถึง และบริการภายนอกที่อาจถูกเปิดใช้เพิ่ม
ดังนั้นเป้าหมายไม่ใช่สร้างกฎแข็งว่า “AI ห้ามแตะโน้ต” แต่คือออกแบบให้มี provenance หรือที่มาชัดเจน มีพื้นที่ทดลอง และมีมนุษย์อนุมัติก่อนสิ่งใดจะกลายเป็นความรู้ระยะยาว
3 อย่างที่ควรจำ
- ให้ AI ช่วยค้นมากกว่าช่วยเขียน: retrieval ทำให้ของเก่ากลับมามีประโยชน์ โดยไม่ทำลายเสียงของเรา
- แยกของ AI ออกจากของเรา: ใช้โฟลเดอร์หรือ Vault ทดลอง ติดป้าย และนำกลับเฉพาะสิ่งที่ตรวจแล้ว
- การเชื่อมโน้ตคือส่วนหนึ่งของการคิด: อย่าวัดความฉลาดของ Second Brain จากจำนวนแท็กหรือความอลังการของกราฟ
ส่วนตัวผมชอบประโยคสรุปแบบนี้: ให้ AI ถือไฟฉาย แต่เราเป็นคนเลือกทางเดิน เพราะสุดท้ายคุณค่าของ Obsidian ไม่ได้อยู่ที่มันสร้างข้อความได้กี่หน้า แต่อยู่ที่มันช่วยให้เราเห็นความคิดของตัวเองชัดขึ้นแค่ไหน
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!