
ถ้าให้ AI ทำภาพแล้วต้องเปิดโปรแกรมอื่นมาแก้ตัวหนังสือ จัดตำแหน่ง และซ่อมส่วนที่เพี้ยนทุกครั้ง เราอาจยังไม่ได้มีผู้ช่วยทำงานภาพจริง ๆ แต่มีเครื่องมือร่างภาพที่เก่งขึ้นเท่านั้น SenseNova U1.5 Lite พยายามแก้โจทย์นี้ด้วยแนวคิดที่น่าสนใจ: รวมความเข้าใจภาษาและการทำงานกับภาพไว้ในโมเดลเดียว
โมเดลนี้เป็นโอเพนซอร์สจาก SenseTime และถูกวางตำแหน่งให้เป็น native unified multimodal ขนาด 8B ที่เน้นงานส่งมอบจริง เช่น โปสเตอร์ อินโฟกราฟิก ภาพแบรนด์ และการแก้ไขภาพแบบระบุจุด
จุดขายของ SenseNova U1.5 Lite ไม่ใช่แค่สร้างภาพให้สวย แต่คือการพยายามทำตามโจทย์ภาพที่มีรายละเอียดเยอะให้จบเป็นงานได้จริง
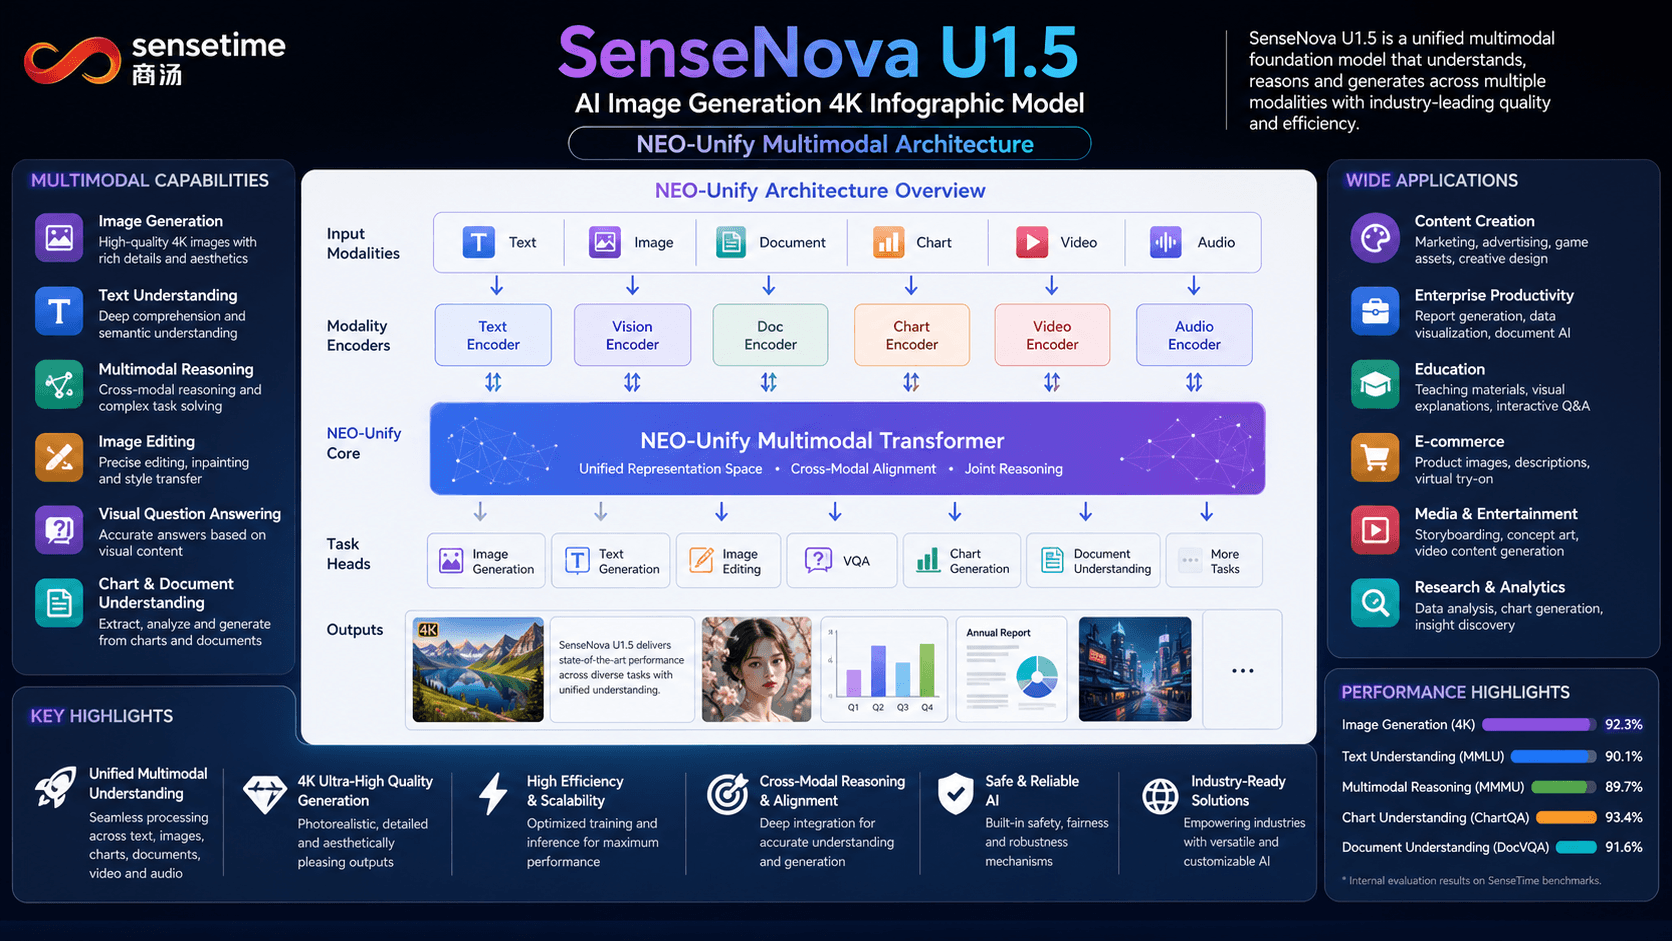
ภาพอ้างอิง: SenseNova U1.5 Lite รุ่น 8B-MoT และเอาต์พุต 4K — ที่มา Pandaily
SenseNova U1.5 Lite คืออะไร
SenseNova U1.5 Lite เป็นโมเดลมัลติโมดัลแบบ native unified หมายถึงข้อความและภาพถูกนำมาทำความเข้าใจในกรอบการทำงานเดียวกัน ไม่ใช่การเอาโมเดลภาษา โมเดลมองภาพ และโมเดลสร้างภาพมาต่อกันแบบแยกส่วน จุดนี้ทำให้เหมาะกับงานที่ต้องอ่านโจทย์ ดูภาพ อธิบายสิ่งที่เห็น และสร้างหรือแก้ภาพ
รุ่นที่เปิดตัวระบุขนาด 8B-MoT-Preview ซึ่งเน้นความเบากว่าโมเดลภาพขนาดใหญ่ แต่ยังคงความสามารถด้าน visual creation และ editing เอาไว้ ทั้งนี้ 8B ไม่ได้แปลว่าจะเปิดบนโน้ตบุ๊กทุกเครื่องได้ การรันจริงยังต้องดู checkpoint, quantization, VRAM และ license ของรุ่นที่เลือก
ความสามารถที่น่าสนใจ
รับคำสั่งยาวประมาณ 3–4k ตัวอักษร
งานภาพจริงมักไม่ได้จบด้วยคำสั่งว่า ทำภาพเทคโนโลยีสวย ๆ เราต้องบอกจำนวนวัตถุ ตำแหน่ง ข้อความ สี พื้นที่โลโก้ และบรรยากาศพร้อมกัน SenseNova U1.5 Lite ระบุว่ารองรับคำสั่งยาวระดับ 3–4k ตัวอักษร จึงเหมาะกับ prompt ที่มีหลายเงื่อนไข
- กำหนดวัตถุ จำนวน และความสัมพันธ์เชิงพื้นที่
- สั่งข้อความและเลย์เอาต์หลายส่วนในภาพเดียว
- ระบุสไตล์ สี แสง และวัสดุให้ไปด้วยกัน
สร้างและแก้ภาพใน workflow เดียว
จุดเด่นอีกอย่างคือ native image editing ตั้งแต่การแก้เฉพาะบริเวณ เปลี่ยนองค์ประกอบ ปรับตัวหนังสือ ไปจนถึงใช้ภาพอ้างอิงหลายใบ แนวคิดนี้เหมาะกับโจทย์แบบ เปลี่ยนเฉพาะแก้วกาแฟใบนี้ แต่ห้ามแตะสินค้าและฉากหลัง ซึ่งต่างจากการสร้างภาพใหม่ทั้งใบ
ภาพอ้างอิง: SenseNova กับงานมัลติโมดัล — ที่มา SQ Magazine
คุมพื้นที่ด้วย Bounding Box และ Visual Marker
Bounding Box และ Visual Marker ช่วยบอกโมเดลว่าให้แก้บริเวณใดหรือสนใจวัตถุใด รวมถึงรองรับภาพอ้างอิงเดี่ยวและหลายภาพ ทำให้การทำงานมีลักษณะเหมือน brief ให้ทีมออกแบบมากกว่าการสุ่ม prompt แล้วลุ้นผล
ข้อความและเลย์เอาต์ซับซ้อน
โปสเตอร์และอินโฟกราฟิกเป็นสนามที่โมเดลสร้างภาพหลายตัวมักสะดุด เพราะภาพอาจสวยแต่คำผิด ตัวหนังสือเบี้ยว หรือข้อมูลหลุดจากกรอบ SenseNova U1.5 Lite เน้นการเรนเดอร์ข้อความจีนและอังกฤษ รวมถึงการจัดวางข้อความหลายชุดในภาพเดียว
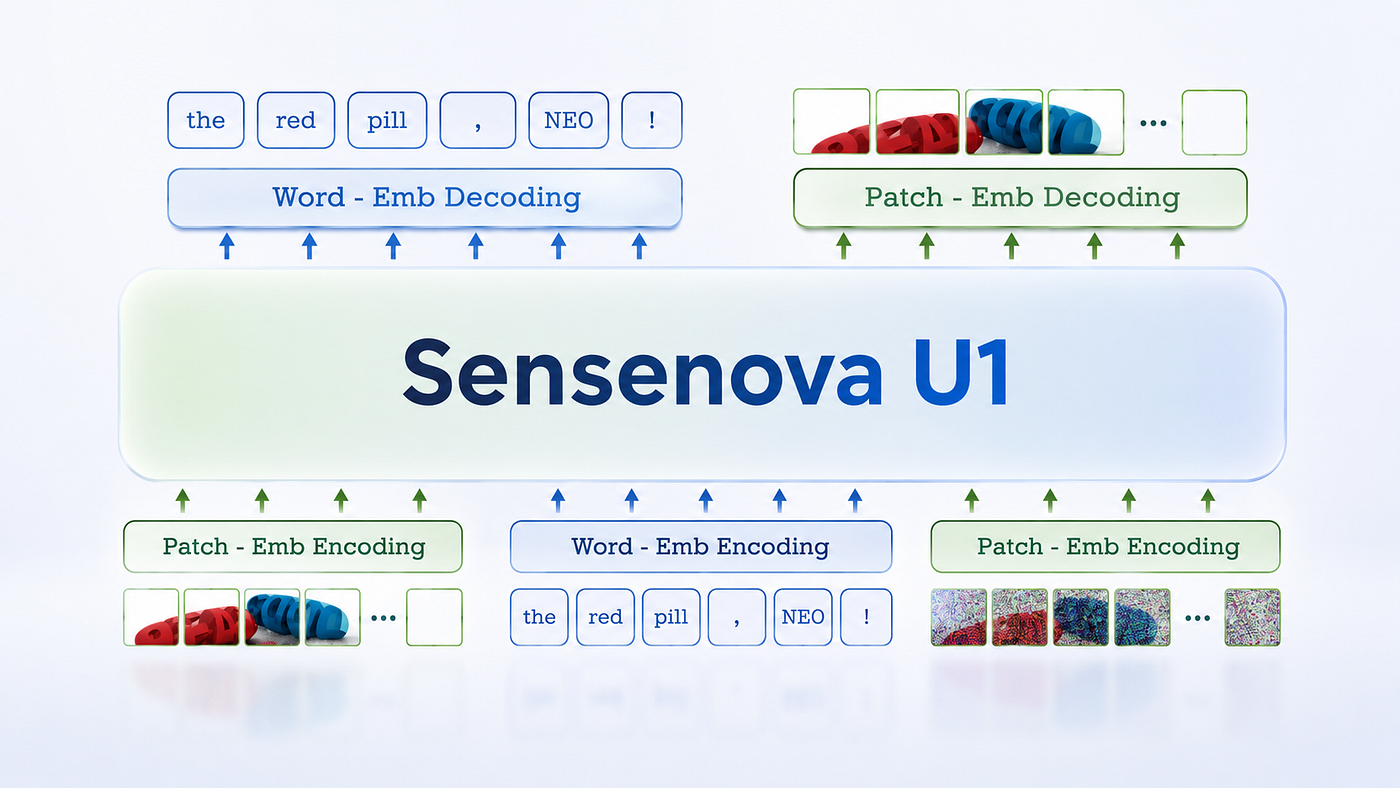
ภาพอ้างอิง: มุมมองต่อ SenseNova U1 ในฐานะโมเดลมัลติโมดัล — ที่มา Generative AI
จากภาพสวยสู่ภาพที่ส่งมอบได้
ข้อมูลต้นทางอธิบายว่าแนวทางฝึกโมเดลถูกออกแบบใหม่ โดยให้ความสำคัญกับงานส่งมอบจริง ไม่ใช่ดูเพียงความสวยของภาพ งานฝึกจึงครอบคลุมคำสั่งซับซ้อน การจัดข้อความ การแก้ภาพ เอาต์พุตความละเอียดสูง และการควบคุมจุดที่ต้องการแก้
พูดง่าย ๆ คือโมเดลไม่ได้ถูกฝึกให้เป็นนักวาดที่มีไอเดียอย่างเดียว แต่พยายามเป็นผู้ช่วยฝ่ายผลิตที่อ่าน brief แล้วทำตามข้อกำหนดให้ครบ
Native 4K มีประโยชน์อย่างไร
การรองรับ native 4K ช่วยให้รายละเอียดเล็ก ๆ เช่น เนื้อวัสดุ เงาสะท้อน และตัวหนังสือมีพื้นที่ให้โมเดลจัดการมากขึ้น โดยเฉพาะภาพที่ต้องนำไปครอปต่อหรือใช้เป็นสื่อสิ่งพิมพ์ แต่ไม่ควรตีความว่าเลข 4K รับประกันคุณภาพทุกงาน ควรทดสอบกับ workflow จริงของตัวเอง
เหมาะกับใคร
- ครีเอเตอร์: ทำภาพปก โปสเตอร์ และภาพโซเชียลจาก brief ที่ละเอียด
- นักออกแบบ: แก้เฉพาะส่วนและคุมองค์ประกอบด้วยพื้นที่อ้างอิง
- ทีมการตลาด: ทำภาพแบรนด์หลายรูปแบบโดยรักษาโทนและข้อความ
- นักพัฒนา: ทดลองโมเดลโอเพนซอร์สและต่อเข้ากับ workflow ของตัวเอง
ทดลองใช้และแหล่งข้อมูล
ทดลองผ่าน SenseNova Studio หรือดูโค้ดจาก GitHub repository และรายการน้ำหนักโมเดลจาก Hugging Face collection ก่อนติดตั้งควรตรวจ README, checkpoint, วิธีติดตั้ง, license และข้อกำหนดฮาร์ดแวร์ของรุ่นล่าสุดโดยตรง
สรุปแบบเพื่อนเล่าให้ฟัง
- SenseNova U1.5 Lite คือโมเดล native unified multimodal ขนาด 8B ที่รวมความเข้าใจข้อความ การสร้างภาพ และการแก้ภาพ
- จุดเด่นคือคำสั่งยาว การจัดข้อความ เลย์เอาต์ การควบคุมพื้นที่ และ native 4K
- ก่อนใช้จริงควรทดลองกับ workflow ของตัวเองและตรวจรุ่นโมเดลจากแหล่งทางการ
แหล่งข้อมูล: AI工具集, OpenSenseNova/SenseNova-U1, Hugging Face และ SenseNova Studio
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!