
ในวงการ Natural Language Processing (NLP) เราเคยผ่านยุคของ BERT ที่แม้จะเข้าใจภาษาได้ดี แต่ทุกครั้งที่จะนำไปใช้กับงานใหม่ เราจำเป็นต้องรวบรวมชุดข้อมูลขนาดใหญ่และทำการ Fine-tuning แยกโมเดลเป็นรายภารกิจ จนกระทั่งการมาถึงของ GPT-3 และ ChatGPT ที่นำเสนอความสามารถ In-Context Learning (ICL) หรือการสั่งงานด้วย Prompt เพียงครั้งเดียวโดยไม่ต้องแก้ค่าน้ำหนัก (Weights) ของโมเดลเลย
แต่วงการหุ่นยนต์ (Robotics) ตลอดหลายปีที่ผ่านมากลับยังคงติดอยู่ในวังวนของ "ยุค BERT" อย่างเหนียวแน่น หากเราต้องการให้แขนกลหรือหุ่นยนต์ฮิวแมนนอยด์ทำงานใหม่ เช่น ปลูกต้นไม้ หรือทอดแพนเค้ก วิศวกรต้องใช้เวลาหลายวันหรือหลายสัปดาห์ในการควบคุมทางไกล (Teleoperation) เพื่อเก็บข้อมูลการเคลื่อนไหวนับร้อยชั่วโมง แล้วนำมาเทรนโมเดลเฉพาะงานซ้ำแล้วซ้ำเล่า
แต่วันที่ 25 สิงหาคม 2026 บริษัทสตาร์ทอัพยูนิคอร์นด้าน Physical AI ระดับโลกอย่าง Skild AI (ผู้ได้รับการระดมทุนจาก NVIDIA, SoftBank, Amazon, LG และ Sequoia Capital ด้วยมูลค่าประเมินกว่า 14,000 ล้านดอลลาร์) ได้ประกาศเปิดตัว "S1" (Skild 1) โมเดลหุ่นยนต์ Foundation Model ตัวแรกของโลกที่นำพลัง In-Context Learning มาสู่โลกกายภาพอย่างแท้จริง เพียงแค่ให้หุ่นยนต์ดูวิดีโอมุมมองบุคคลที่หนึ่ง (Egocentric Video) ที่มนุษย์สาธิตการทำงานเพียงคลิปเดียว หุ่นยนต์ก็สามารถทำความเข้าใจเจตนา ลำดับขั้นตอน และลงมือปฏิบัติงานจริงที่มีความยาวต่อเนื่องถึง 10 นาที ได้ทันทีโดยไม่ต้องผ่านกระบวนการ Fine-tuning หรือ Post-training ใดๆ ทั้งสิ้น!
ภาพที่ 1: การเปิดตัว Skild AI S1 โมเดล Foundation สำหรับหุ่นยนต์ที่รองรับ In-Context Learning
1. ทำไมต้องเป็น 'วิดีโอ' แทนที่จะเป็นคำสั่งเสียงหรือข้อความ?
คำถามสำคัญที่หลายคนสงสัยคือ: ทำไมระบบหุ่นยนต์ทั่วไปอย่าง Vision-Language-Action (VLA) ที่สั่งงานด้วยข้อความ (เช่น "หยิบแก้วน้ำให้หน่อย") ถึงไม่เพียงพอสำหรับงานขั้นสูง?
ทีมวิจัยของ Skild AI อธิบายว่า สำหรับการกระทำระดับพื้นฐาน (Atomic Action) สั้นๆ 5-10 วินาที ข้อความเพียงประโยคเดียวอาจจะเพียงพอ แต่เมื่อเป็นงานที่มีความละเอียด ประณีต และมีมิติเชิงเวลาต่อเนื่องยาวนาน (Long-Horizon Tasks) มนุษย์เราก็ไม่ได้เรียนรู้จากการอ่านตัวหนังสือ เช่น เราไม่สามารถพับผ้าปูที่นอนให้เรียบกริบ ตีไข่ขาวให้ตั้งยอด หรือผูกเงื่อนเชือกที่ซับซ้อนได้จากข้อความบรรยายเพียงไม่กี่คำ แต่เราเรียนรู้จากการ "ดูคนอื่นทำให้ดู"
วิดีโอสาธิต 1 คลิปเก็บข้อมูลมิติเชิงพื้นที่ (Spatial), ลำดับเวลา (Temporal), ทิศทางการออกแรง และการตอบสนองต่อวัตถุไว้อย่างครบถ้วน ซึ่งโมเดล S1 ได้รับการฝึกฝนแบบ Meta-learning บนโครงสร้างพื้นฐานการประมวลผลของ NVIDIA AI เพื่อทำหน้าที่เป็น "ตัวแปลเจตนา" แปลงวิดีโอสาธิตจากมนุษย์ให้กลายเป็นการเคลื่อนไหวของข้อต่อและมือจับของหุ่นยนต์ในสภาพแวดล้อมจริง
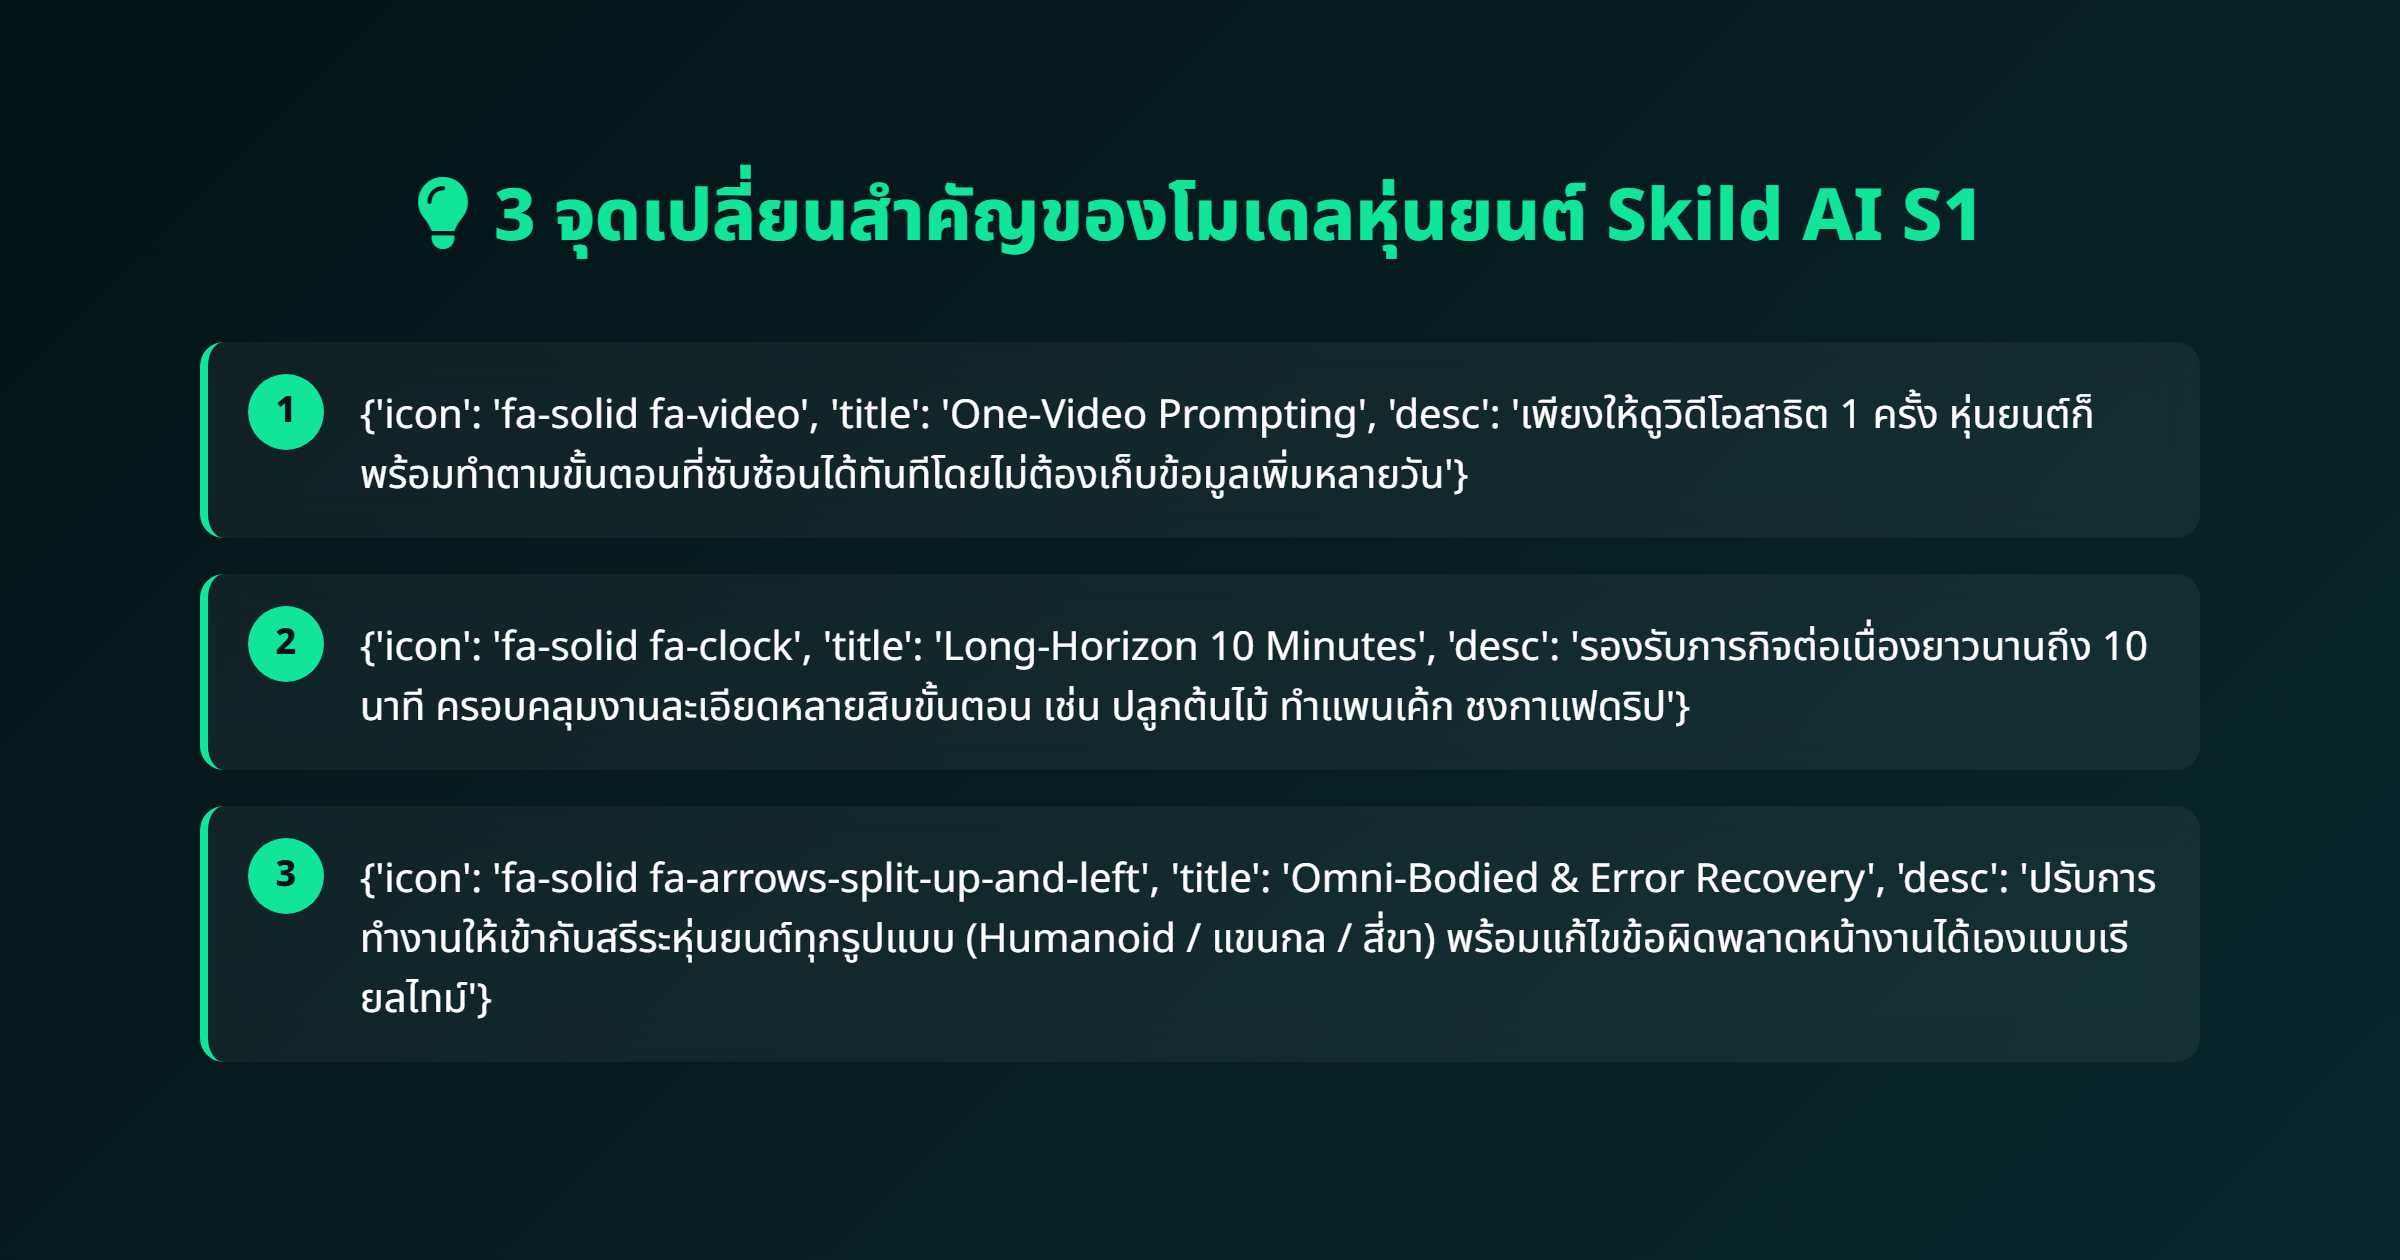
ภาพที่ 2: สรุป 3 จุดเด่นสำคัญของโมเดล Skild AI S1
2. สถิติ Benchmark ช็อกวงการ: ความสำเร็จ 66% เทียบกับ 9% ของ VLA เดิม
ในการทดลองแบบควบคุมตัวแปรอย่างเข้มงวดของ Skild AI ทีมวิจัยได้เปรียบเทียบระหว่างโมเดล S1 ที่ใช้ Video Prompting (In-Context Learning) กับโมเดล VLA มาตรฐานที่ใช้ Language Prompting ภายใต้สถาปัตยกรรมและปริมาณข้อมูลฝึกฝนระดับมหาศาล 100,000 ชั่วโมงเท่ากัน:
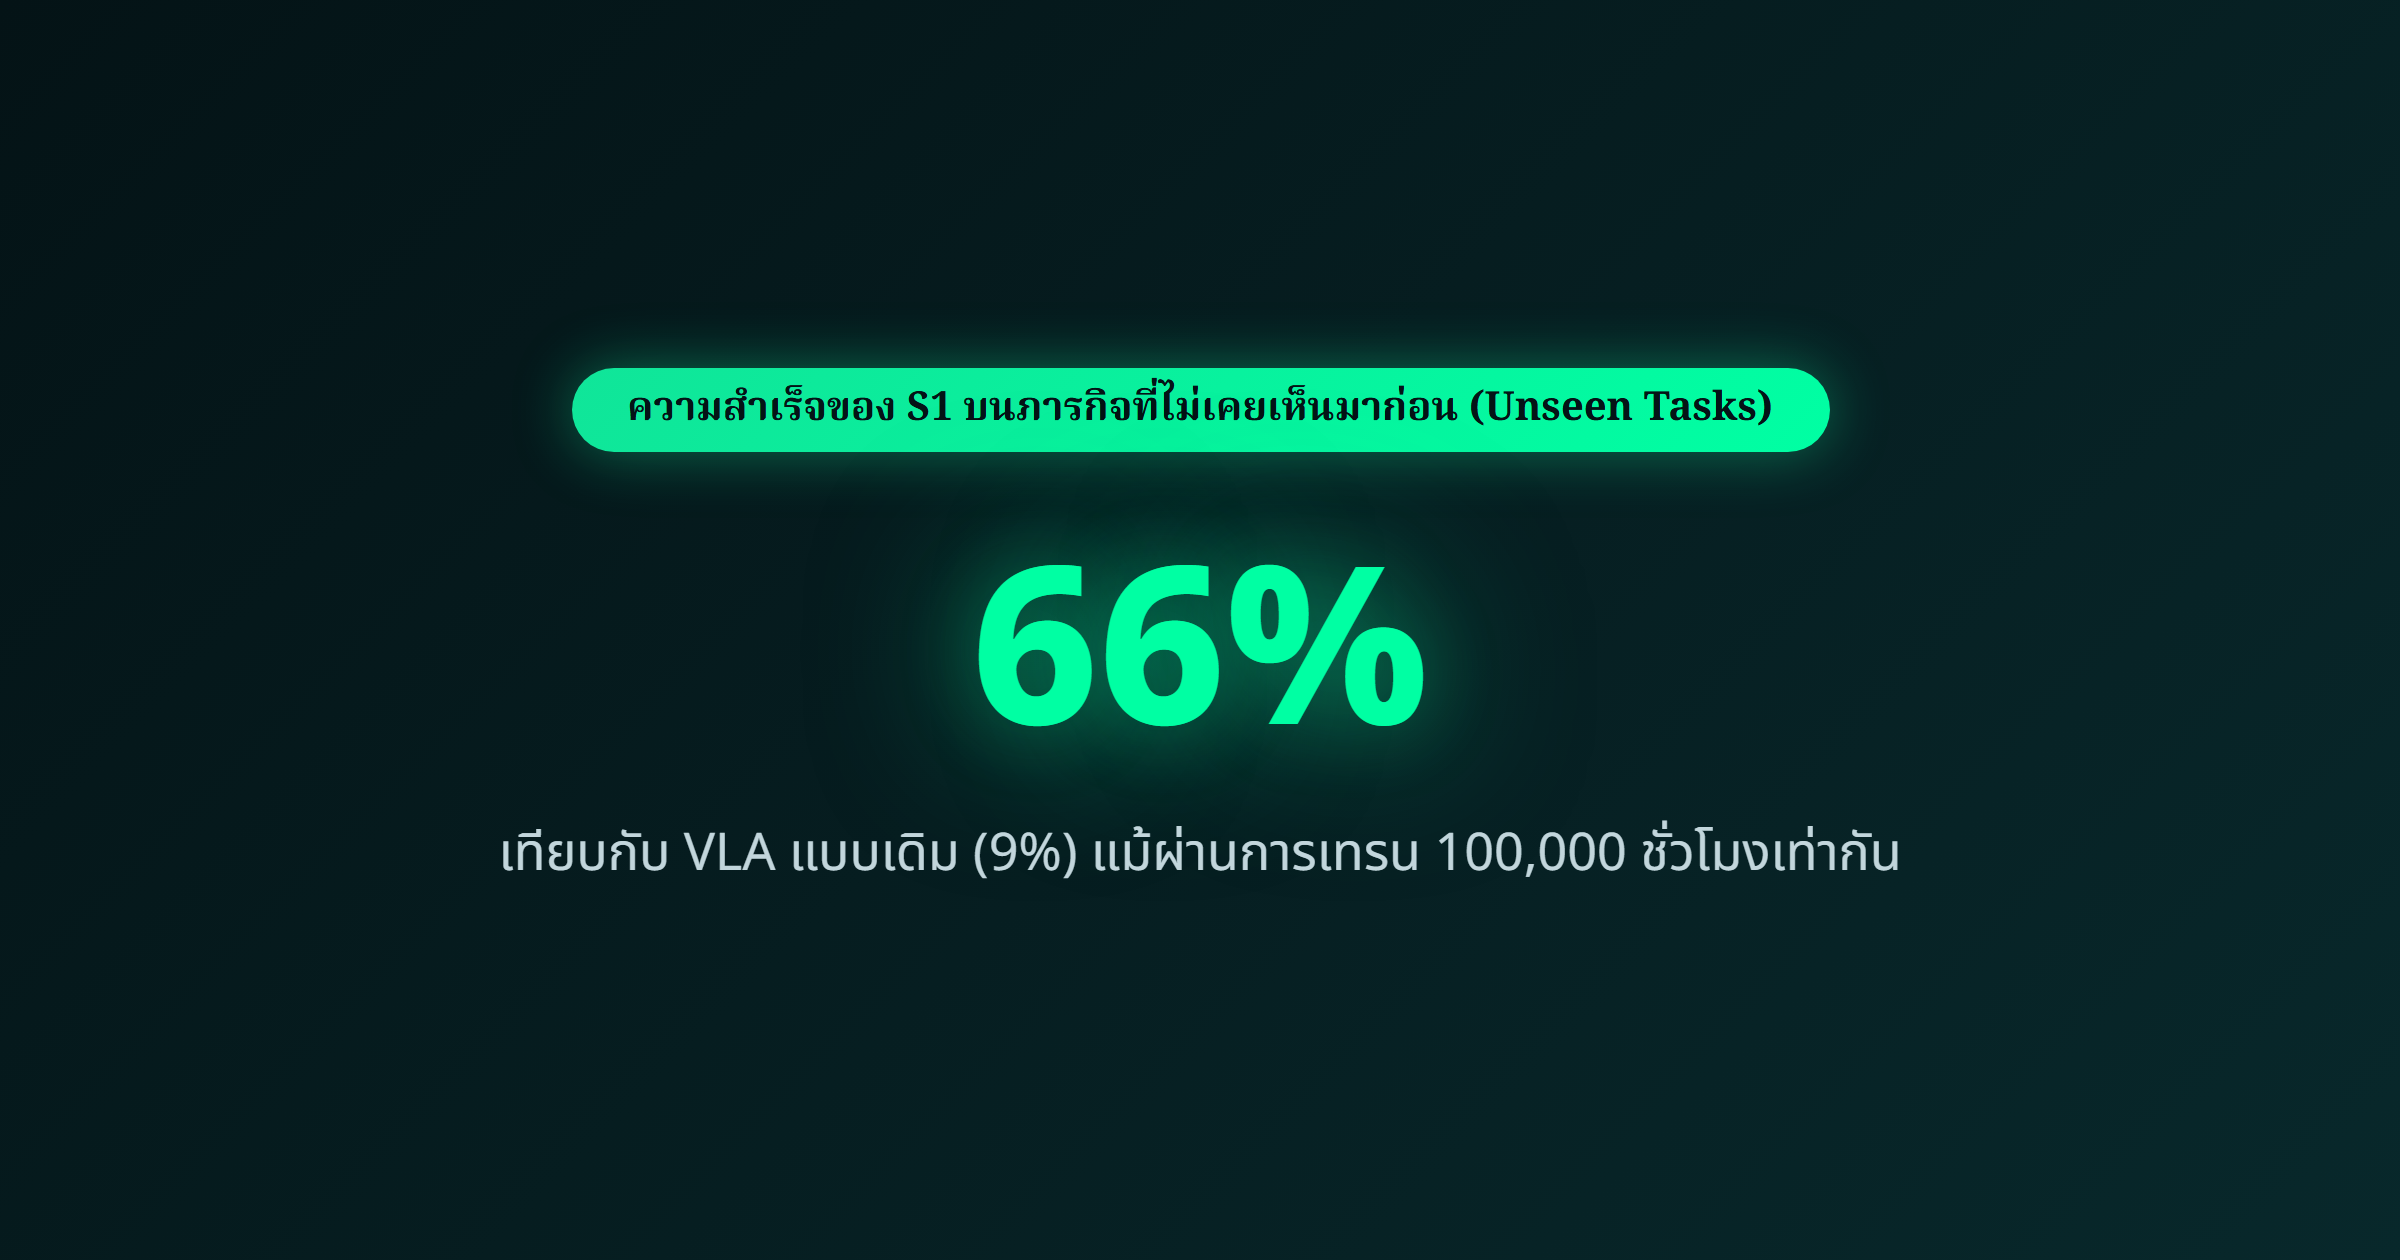
ภาพที่ 3: กราฟสถิติ Benchmark ความสำเร็จ 66% บนงานที่ไม่เคยเห็นมาก่อน
ผลลัพธ์ที่ได้สะท้อนความแตกต่างอย่างมหาศาล:
- บนภารกิจที่ไม่เคยเห็นมาก่อน (Unseen / Out-of-Distribution Tasks): โมเดล VLA ที่สั่งด้วยภาษาทำภารกิจสำเร็จเพียง 9% ในขณะที่โมเดล S1 (In-Context Learning) ทำภารกิจสำเร็จพุ่งสูงถึง 66% (เพิ่มขึ้นกว่า 7 เท่า!)
- การประหยัดข้อมูลเทียบเท่า 380 เท่า: การดูวิดีโอสาธิตเพียง 1 ครั้งใน S1 ให้ประสิทธิภาพเทียบเท่ากับการต้องเก็บข้อมูล Teleoperation หน้างานจริงถึง 380 รอบ ของโมเดลแบบเดิม
3. 4 ภารกิจสุดหินที่ S1 ทำได้จริงหลังดูวิดีโอเพียงครั้งเดียว
ในการสาธิตอย่างเป็นทางการ Skild AI ได้ทดสอบ S1 กับงานที่อยู่นอกชุดข้อมูล Pre-training โดยสมบูรณ์ ซึ่งมีขั้นตอนซับซ้อนและกินเวลายาวนานถึง 10 นาที:
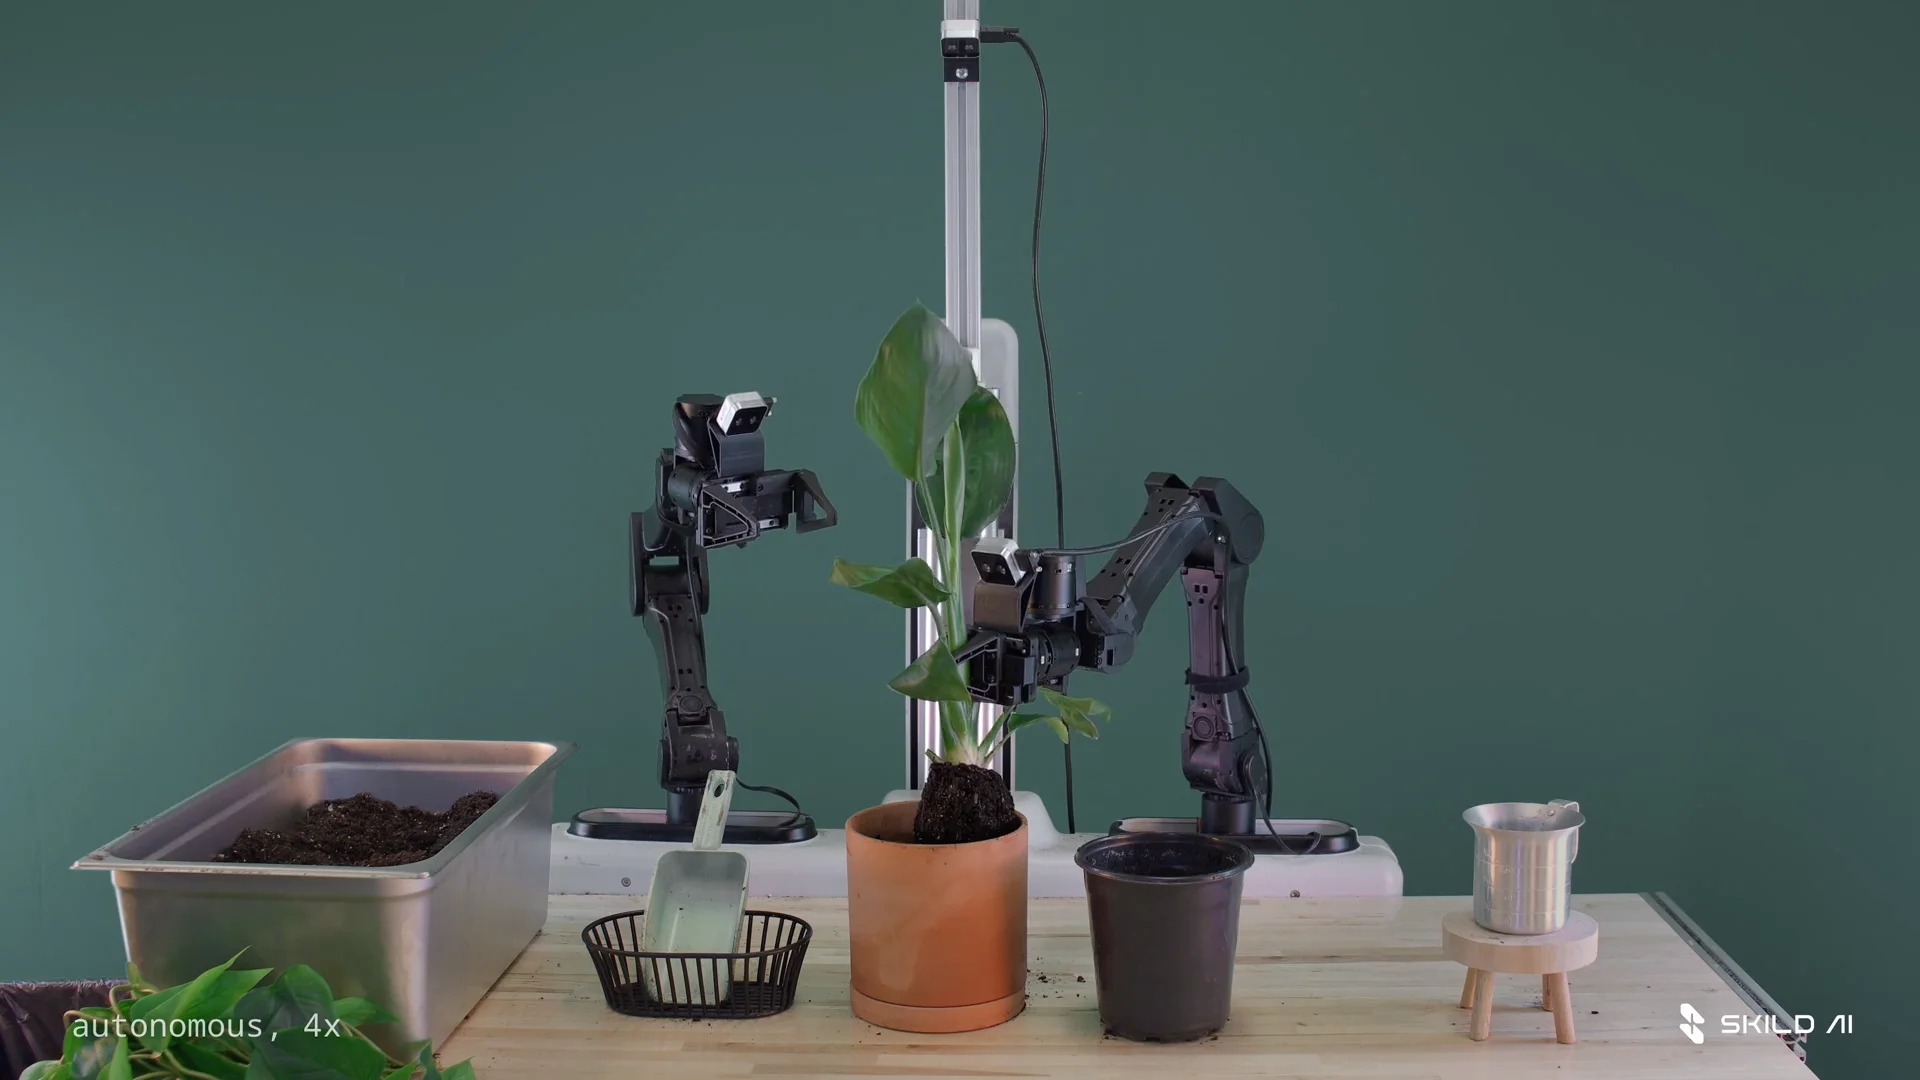
ภาพที่ 4: การสาธิตหุ่นยนต์ปลูกต้นไม้ลงกระถางจากการดูวิดีโอเพียงครั้งเดียว
- การปลูกต้นไม้ลงกระถาง (Plant Potting): ตั้งแต่การใช้พลั่วตักดินใส่กระถาง การหยิบต้นกล้าอย่างระมัดระวังไม่ให้รากช้ำ การกลบดิน และการรดน้ำ ซึ่งใช้เวลาเซ็ตติ้งและสาธิตเพียง 11 นาที หุ่นยนต์ก็สามารถทำงานได้เองโดยอัตโนมัติ
- การทำแพนเค้ก (Cooking Pancakes): การหยอดแป้งลงบนกระทะร้อน การรอเวลาจนแป้งสุกได้ที่ และการใช้ตะหลิวสอดใต้แผ่นแป้งเพื่อพลิกกลับด้านโดยไม่แตกหัก
- การชงกาแฟดริป (Pour-over Coffee): การพับกระดาษฟิลเตอร์ใส่กรวยดริป การตักผงกาแฟ และการควบคุมมือกาเพื่อรินน้ำร้อนวนเป็นวงกลมสม่ำเสมอ
- การประกอบชิ้นส่วนอุปกรณ์ (Kit Assembly): การจัดวางตำแหน่งชิ้นส่วน ขันน็อต และประกบโครงสร้างตามแบบ
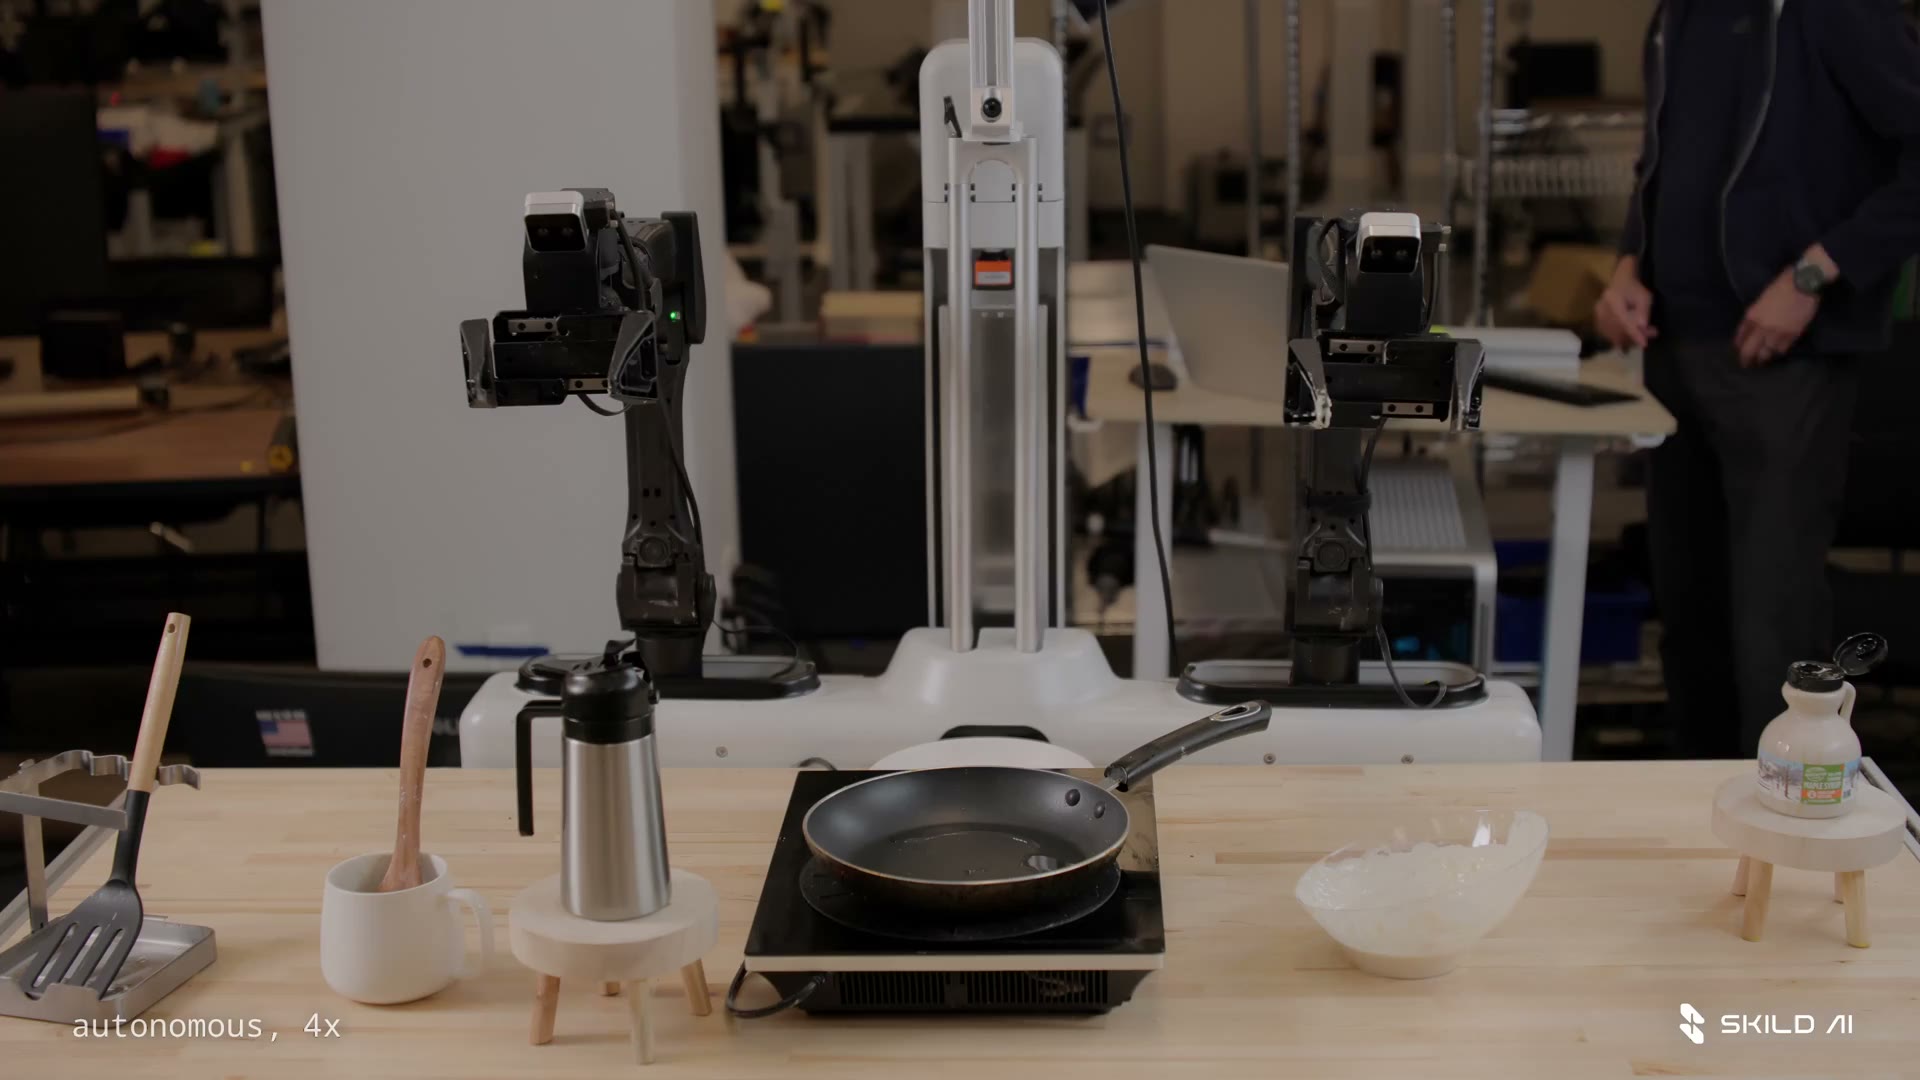
ภาพที่ 5: การสาธิตการทำแพนเค้กและงานบ้านที่มีความซับซ้อนต่อเนื่อง
4. ตารางเปรียบเทียบ: Skild AI S1 vs โมเดลหุ่นยนต์ยุคเดิม
| มิติการทำงาน | Skild AI S1 (สิงหาคม 2026) | Conventional VLA | Specialized Policy |
|---|---|---|---|
| วิธีการป้อนคำสั่ง | Video Prompt (วิดีโอสาธิต 1 คลิป) | Text Prompt (ภาษาธรรมชาติ) | เขียนโค้ด / กำหนด Trajectory |
| การปรับตัวกับงานใหม่ | Zero Fine-tuning (In-Context) | ต้อง Fine-tune หลายชั่วโมง | ต้องเทรนใหม่ทั้งหมดจากศูนย์ |
| ความยาวภารกิจ (Horizon) | ยาวนานสูงสุด 10 นาที (Dozens of Steps) | สั้น 5-30 วินาที (Atomic Actions) | ขึ้นอยู่กับการเขียนโปรแกรม |
| ความสำเร็จบนงาน Unseen | 66% (Scale ข้อมูล 100k ชม.) | 9% | 0% (ทำไม่ได้ถ้าไม่เทรน) |
| ความยืดหยุ่นต่อสรีระ | Omni-Bodied (Humanoid, แขนกล, สี่ขา) | จำกัดเฉพาะหุ่นยนต์รุ่นที่เทรน | เจาะจงฮาร์ดแวร์ 100% |
5. Omni-Bodied: หนึ่งสมองกล ควบคุมหุ่นยนต์ได้ทุกสรีระ
อีกหนึ่งความก้าวหน้าของ Skild AI คือแนวคิด "Omni-bodied Brain" สถาปัตยกรรมของ S1 ไม่ได้ถูกผูกมัดไว้กับฮาร์ดแวร์ชนิดใดชนิดหนึ่ง ไม่ว่าจะเป็นหุ่นยนต์ฮิวแมนนอยด์ 2 ขา, หุ่นยนต์ 4 ขา (Quadruped), รถเข็นติดแขนกล (Wheeled Manipulator) หรือแขนกลอุตสาหกรรมจากพันธมิตรอย่าง ABB Robotics, Universal Robots และ MiR
เมื่อหุ่นยนต์สังเกตเห็นวิดีโอของมนุษย์ มันจะทำการคำนวณ "Functional Correspondence" เพื่อแปลงท่าทางของมือคนให้เข้ากับจำนวนองศาอิสระ (DOF) และกริปเปอร์ของตัวมันเองโดยอัตโนมัติ ยิ่งไปกว่านั้น หากระหว่างทำงานมีคนมาแกล้งเลื่อนตำแหน่งของ หรือเปลี่ยนสภาพแสง S1 ก็สามารถปรับวิถีการเคลื่อนที่แบบเรียลไทม์ และหากทำของหลุดมือ มันจะพยายามหยิบขึ้นมาทำต่อจนบรรลุเป้าหมายแทนที่จะหยุดค้าง
6. สรุป: การก้าวเข้าสู่ยุค Deploy หุ่นยนต์ได้ใน 10 นาที
การเปิดตัว Skild AI S1 นับเป็นก้าวสำคัญที่สุดก้าวหนึ่งของวงการหุ่นยนต์ในรอบทศวรรษ จากเดิมที่โรงงานหรือครัวเรือนต้องใช้เวลาเป็นสัปดาห์และงบประมาณมหาศาลในการจ้างผู้เชี่ยวชาญมาโปรแกรมหุ่นยนต์สำหรับงานใหม่ ในอนาคตอันใกล้ หัวหน้างานหรือผู้ใช้ทั่วไปเพียงแค่หยิบสมาร์ตโฟนขึ้นมาถ่ายคลิปตัวเองทำงาน 1 รอบ แล้วส่งให้หุ่นยนต์ดู หุ่นยนต์ก็จะพร้อมเริ่มงานได้ทันที
แม้ว่าปัจจุบัน S1 จะยังเปิดให้ทดสอบเฉพาะกลุ่มพันธมิตรทางอุตสาหกรรมแบบ Early Access แต่ทิศทางของ Physical AI ได้ชัดเจนแล้วว่า: ยุคที่หุ่นยนต์ 'มองแล้วทำตามได้ทันที' ได้มาถึงแล้วจริงๆ!
แหล่งข้อมูลอ้างอิง:
ความคิดเห็น 0
ยังไม่มีความคิดเห็น — เป็นคนแรกที่แสดงความคิดเห็น!